diff --git a/notes/Java 容器.md b/notes/Java 容器.md
index 99d88f89..3513492c 100644
--- a/notes/Java 容器.md
+++ b/notes/Java 容器.md
@@ -16,6 +16,9 @@
* [ConcurrentHashMap](#concurrenthashmap)
* [LinkedHashMap](#linkedhashmap)
* [WeakHashMap](#weakhashmap)
+ * [附录:实测](#附录实测)
+ * [A1 ArrayList 的扩容与常见陷阱](#a1-arraylist-的扩容与常见陷阱)
+ * [A2 HashMap 的并发写入](#a2-hashmap-的并发写入)
* [参考资料](#参考资料)
@@ -26,40 +29,32 @@
### Collection
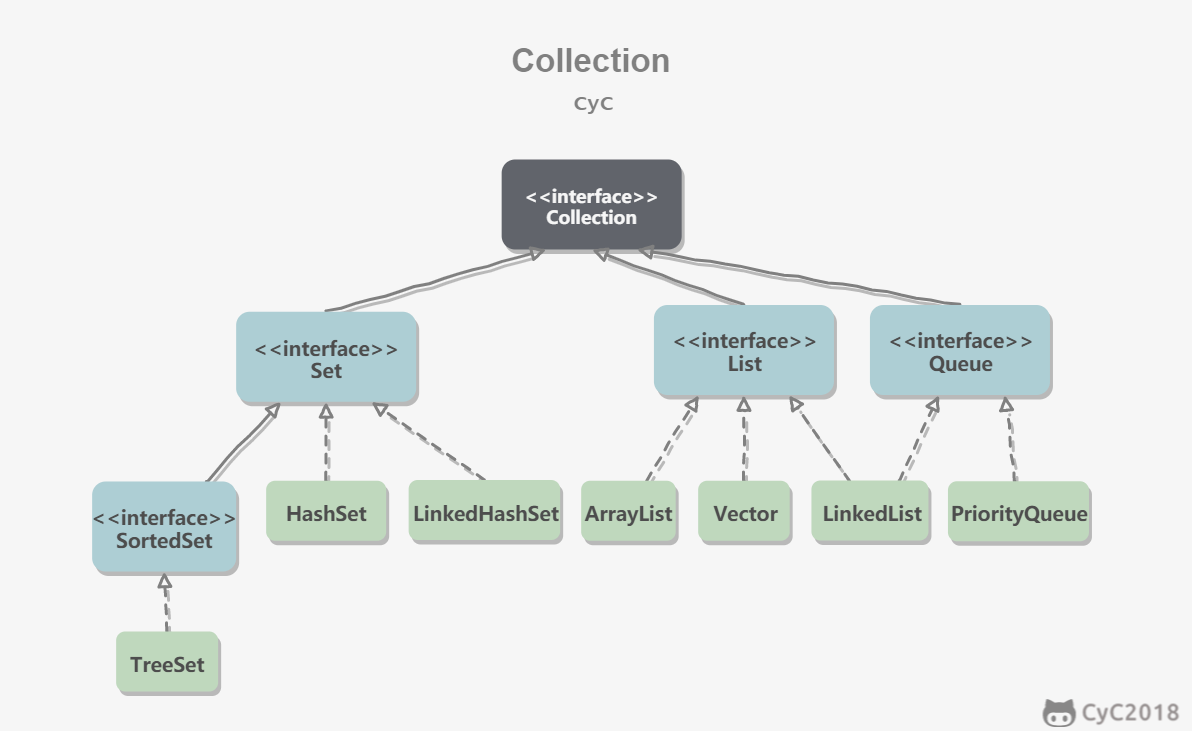
- 
+ 
#### 1. Set
-- TreeSet:基于红黑树实现,支持有序性操作,例如根据一个范围查找元素的操作。但是查找效率不如 HashSet,HashSet 查找的时间复杂度为 O(1),TreeSet 则为 O(logN)。
-
-- HashSet:基于哈希表实现,支持快速查找,但不支持有序性操作。并且失去了元素的插入顺序信息,也就是说使用 Iterator 遍历 HashSet 得到的结果是不确定的。
-
+- TreeSet:基于红黑树实现,支持有序性操作,例如根据一个范围查找元素的操作。但是查找效率不如 HashSet,HashSet 查找的时间复杂度为 O(1),TreeSet 则为 O(logN);
+- HashSet:基于哈希表实现,支持快速查找,但不支持有序性操作。并且失去了元素的插入顺序信息,也就是说使用 Iterator 遍历 HashSet 得到的结果是不确定的;
- LinkedHashSet:具有 HashSet 的查找效率,并且内部使用双向链表维护元素的插入顺序。
#### 2. List
-- ArrayList:基于动态数组实现,支持随机访问。
-
-- Vector:和 ArrayList 类似,但它是线程安全的。
-
+- ArrayList:基于动态数组实现,支持随机访问;
+- Vector:和 ArrayList 类似,但它是线程安全的;
- LinkedList:基于双向链表实现,只能顺序访问,但是可以快速地在链表中间插入和删除元素。不仅如此,LinkedList 还可以用作栈、队列和双向队列。
#### 3. Queue
-- LinkedList:可以用它来实现双向队列。
-
+- LinkedList:可以用它来实现双向队列;
- PriorityQueue:基于堆结构实现,可以用它来实现优先队列。
### Map
- 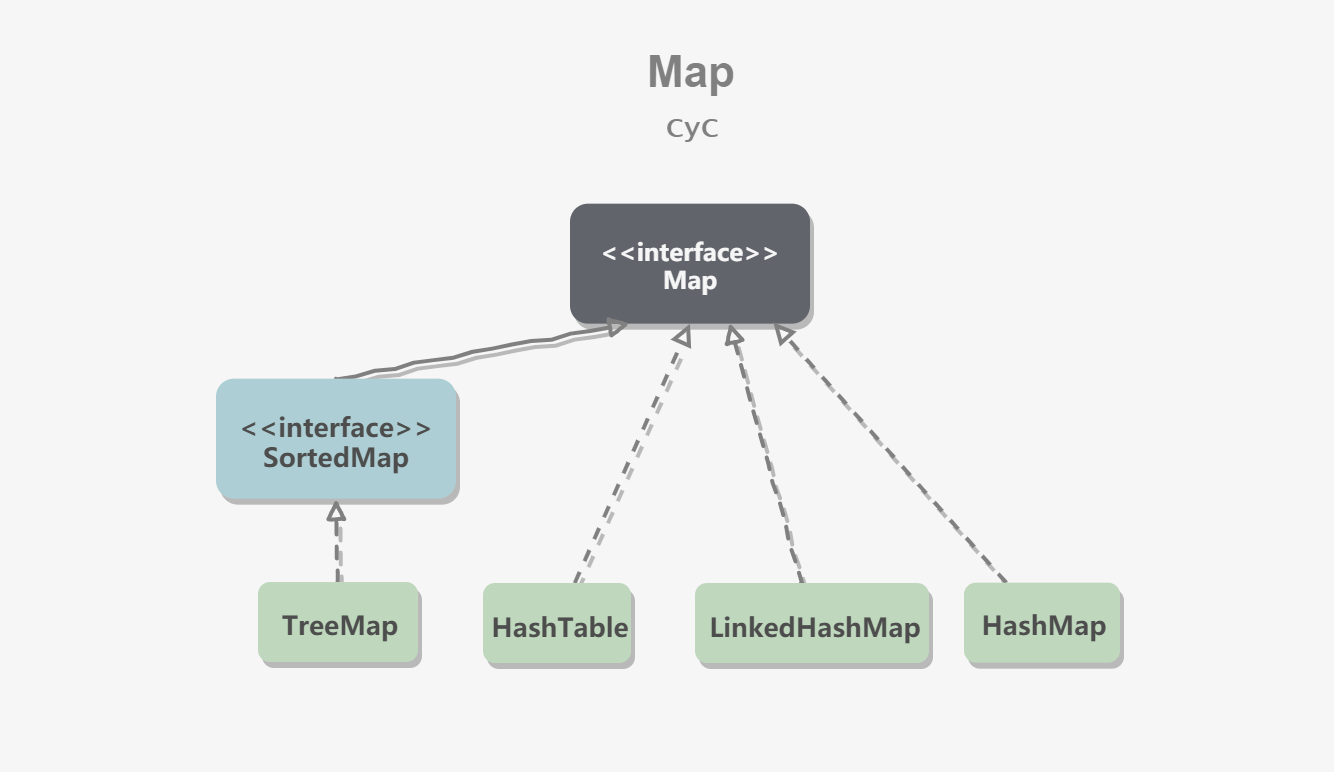
-
-- TreeMap:基于红黑树实现。
-
-- HashMap:基于哈希表实现。
-
-- Hashtable:和 HashMap 类似,但它是线程安全的,这意味着同一时刻多个线程同时写入 Hashtable 不会导致数据不一致。它是遗留类,不应该去使用它,而是使用 ConcurrentHashMap 来支持线程安全,ConcurrentHashMap 的效率会更高,因为 ConcurrentHashMap 引入了分段锁。
+ 
+- TreeMap:基于红黑树实现;
+- HashMap:基于哈希表实现;
+- Hashtable:和 HashMap 类似,但它是线程安全的,这意味着同一时刻多个线程同时写入 Hashtable 不会导致数据不一致。它是遗留类,不应该去使用它,而是使用 ConcurrentHashMap 来支持线程安全。ConcurrentHashMap 的效率更高,因为它不会锁住整个表:JDK 1.7 使用分段锁,JDK 1.8 只锁住一个桶;
- LinkedHashMap:使用双向链表来维护元素的顺序,顺序为插入顺序或者最近最少使用(LRU)顺序。
@@ -67,7 +62,7 @@
### 迭代器模式
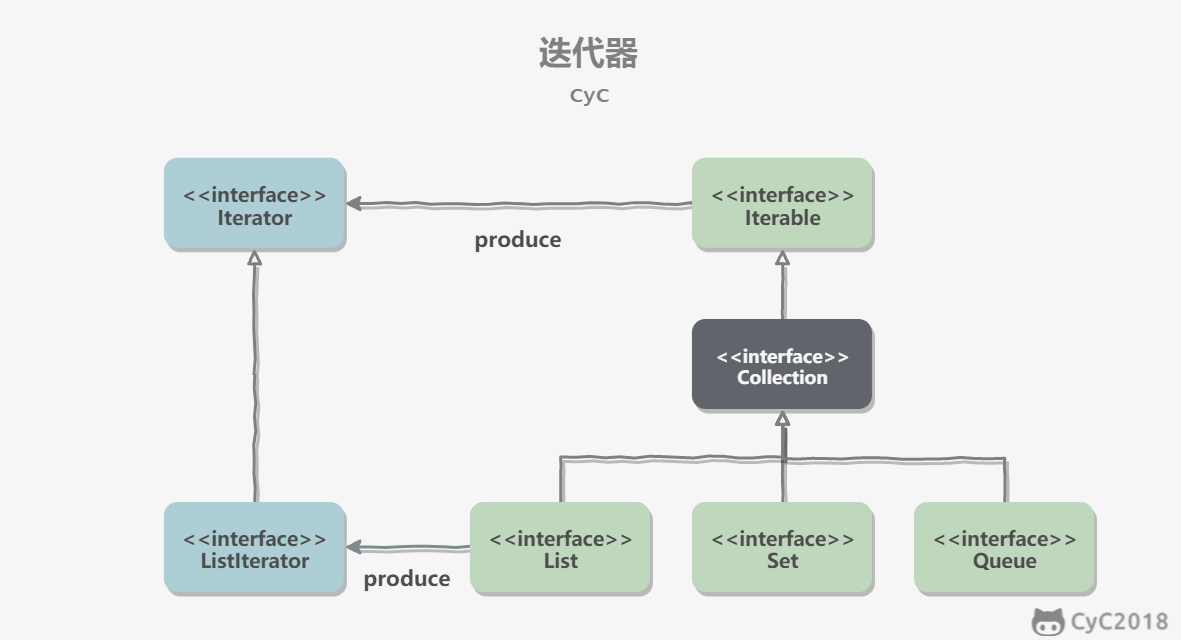
- 
+ 
Collection 继承了 Iterable 接口,其中的 iterator() 方法能够产生一个 Iterator 对象,通过这个对象就可以迭代遍历 Collection 中的元素。
@@ -104,11 +99,17 @@ List list = Arrays.asList(arr);
List list = Arrays.asList(1, 2, 3);
```
+asList() 返回的是数组的一个视图,而不是一个新的 ArrayList,使用时需要注意(JDK 21 实测,见[附录 A1](#a1-arraylist-的扩容与常见陷阱)):
+
+- 长度固定:可以 set(),但调用 add()、remove() 会抛出 UnsupportedOperationException;
+- 与数组共用存储:修改原数组后,List 中的元素也跟着改变;
+- 传入 int[] 这样的基本类型数组时,整个数组被当成一个元素,得到的 List 长度为 1。
+
+需要一个可以修改的列表时,用 new ArrayList<>(Arrays.asList(arr)) 复制一份。
+
## 三、源码分析
-如果没有特别说明,以下源码分析基于 JDK 1.8。
-
-在 IDEA 中 double shift 调出 Search EveryWhere,查找源码文件,找到之后就可以阅读源码。
+如果没有特别说明,以下源码分析基于 JDK 1.8。JDK 21 中这些类的主要逻辑没有变化,有差异的地方单独说明。
### ArrayList
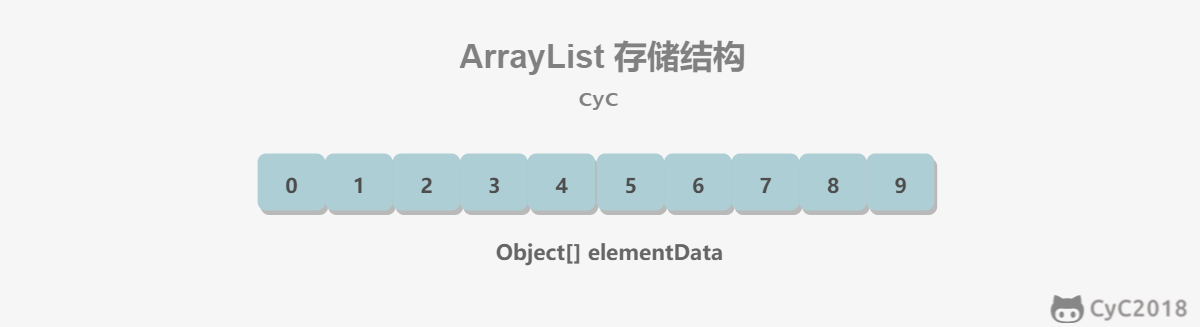
@@ -122,17 +123,17 @@ public class ArrayList extends AbstractList
implements List, RandomAccess, Cloneable, java.io.Serializable
```
-数组的默认大小为 10。
+数组的默认大小为 10。用无参构造函数创建时,elementData 先指向一个长度为 0 的共享空数组,第一次添加元素时才分配长度为 10 的数组。
```java
private static final int DEFAULT_CAPACITY = 10;
```
- 
+ 
#### 2. 扩容
-添加元素时使用 ensureCapacityInternal() 方法来保证容量足够,如果不够时,需要使用 grow() 方法进行扩容,新容量的大小为 `oldCapacity + (oldCapacity >> 1)`,即 oldCapacity+oldCapacity/2。其中 oldCapacity >> 1 需要取整,所以新容量大约是旧容量的 1.5 倍左右。(oldCapacity 为偶数就是 1.5 倍,为奇数就是 1.5 倍-0.5)
+添加元素时使用 ensureCapacityInternal() 方法来保证容量足够,如果不够时,需要使用 grow() 方法进行扩容,新容量的大小为 `oldCapacity + (oldCapacity >> 1)`,即 oldCapacity+oldCapacity/2。其中 oldCapacity >> 1 需要取整,所以新容量大约是旧容量的 1.5 倍(oldCapacity 为偶数就是 1.5 倍,为奇数就是 1.5 倍减 0.5)。例如依次添加元素时,容量的变化为 0、10、15、22、33(JDK 21 实测,见[附录 A1](#a1-arraylist-的扩容与常见陷阱))。JDK 21 的 grow() 改为调用 ArraysSupport.newLength() 计算新容量,增长的规则相同。
扩容操作需要调用 `Arrays.copyOf()` 把原数组整个复制到新数组中,这个操作代价很高,因此最好在创建 ArrayList 对象时就指定大概的容量大小,减少扩容操作的次数。
@@ -258,6 +259,21 @@ modCount 用来记录 ArrayList 结构发生变化的次数。结构发生变化
在进行序列化或者迭代等操作时,需要比较操作前后 modCount 是否改变,如果改变了需要抛出 ConcurrentModificationException。代码参考上节序列化中的 writeObject() 方法。
+最常见的情况是在 foreach 循环中删除元素。foreach 编译后使用迭代器,list.remove() 改变了 modCount,迭代器下一次调用 next() 时就会抛出异常。应该使用迭代器自己的 remove(),或者 removeIf():
+
+```java
+for (String s : list) {
+ if (s.equals("a")) list.remove(s); // ConcurrentModificationException
+}
+
+Iterator it = list.iterator();
+while (it.hasNext()) {
+ if (it.next().equals("a")) it.remove();
+}
+
+list.removeIf(s -> s.equals("a"));
+```
+
### Vector
@@ -350,7 +366,7 @@ List list = new CopyOnWriteArrayList<>();
写操作需要加锁,防止并发写入时导致写入数据丢失。
-写操作结束之后需要把原始数组指向新的复制数组。
+写操作结束之后需要把原始数组指向新的复制数组。JDK 21 中写操作改为用 synchronized 加锁,过程相同。
```java
public boolean add(E e) {
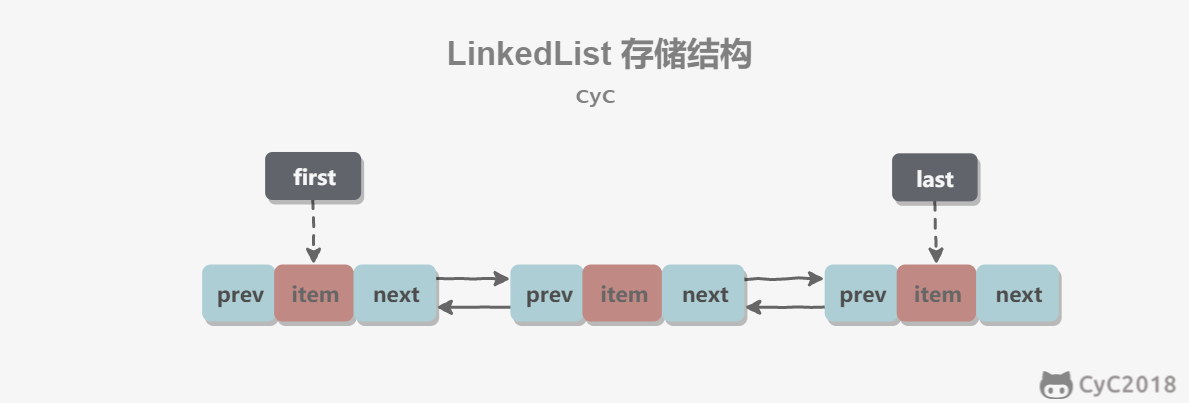
@@ -412,7 +428,7 @@ transient Node first;
transient Node last;
```
- 
+ 
#### 2. 与 ArrayList 的比较
@@ -421,15 +437,22 @@ ArrayList 基于动态数组实现,LinkedList 基于双向链表实现。Array
- 数组支持随机访问,但插入删除的代价很高,需要移动大量元素;
- 链表不支持随机访问,但插入删除只需要改变指针。
+需要注意的是,链表在中间插入前要先遍历到插入位置,这一步也是 O(N) 的,而且要逐个访问分散在内存中的节点;数组移动元素用的是 System.arraycopy(),一次复制一整块连续内存。例如在 10 万个元素的中间插入 1 万次,ArrayList 约 50 ms,LinkedList 约 0.8~1 秒;只有在头部插入时 LinkedList 才明显更快(JDK 21 实测,见[附录 A1](#a1-arraylist-的扩容与常见陷阱))。所以大多数场景下应该使用 ArrayList,需要在头尾频繁插入删除时使用 ArrayDeque 或 LinkedList。
+
### HashMap
-为了便于理解,以下源码分析以 JDK 1.7 为主。
+为了便于理解,以下源码分析以 JDK 1.7 为主。JDK 1.8 主要有以下变化,JDK 21 与 JDK 1.8 相同:
+
+- 数组元素由 Entry 改为 Node,链表长度达到 8 时转为红黑树,见第 8 节;
+- 新的键值对插入链表尾部,而不是头部;
+- 计算哈希值时只做一次扰动:(h = key.hashCode()) ^ (h >>> 16),把高 16 位异或到低 16 位,让高位也参与决定桶下标;
+- 扩容时不再逐个重新计算桶下标,而是按哈希值新增的那一位把链表拆成两条,分别放在原位置和原位置 + 旧容量,见第 6 节。
#### 1. 存储结构
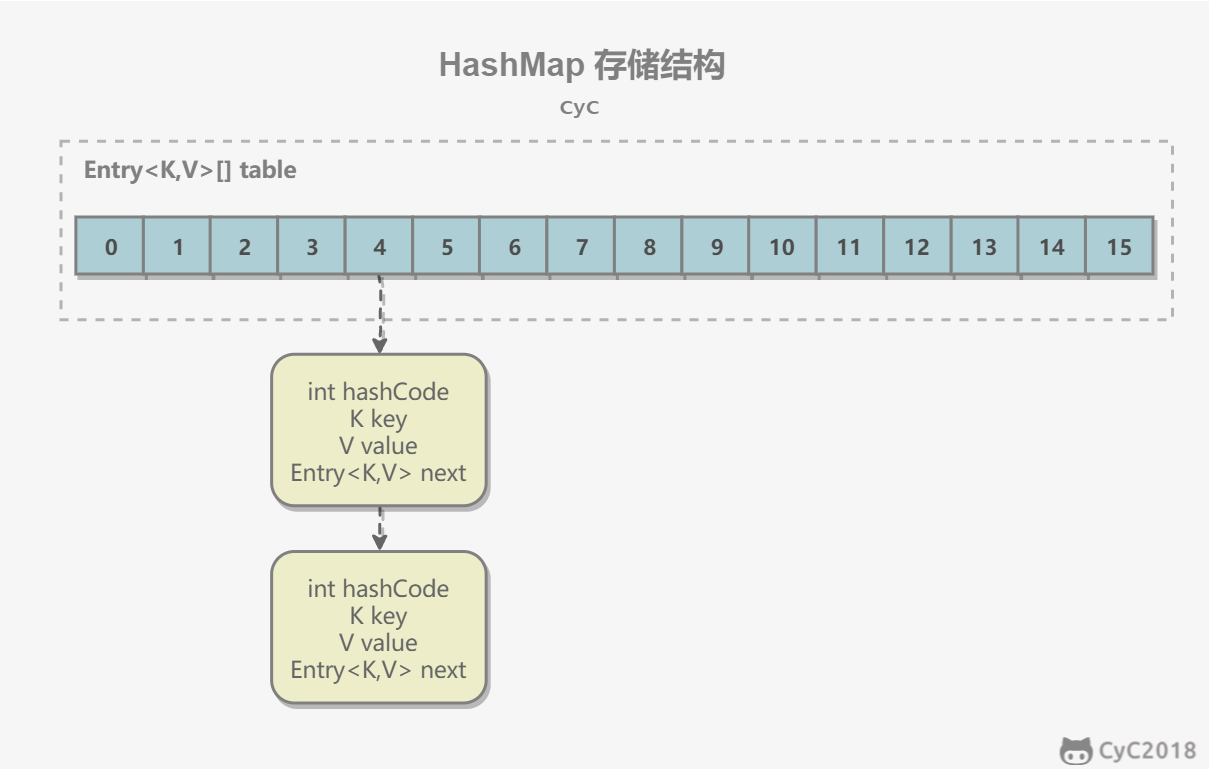
-内部包含了一个 Entry 类型的数组 table。Entry 存储着键值对。它包含了四个字段,从 next 字段我们可以看出 Entry 是一个链表。即数组中的每个位置被当成一个桶,一个桶存放一个链表。HashMap 使用拉链法来解决冲突,同一个链表中存放哈希值和散列桶取模运算结果相同的 Entry。
+内部包含了一个 Entry 类型的数组 table。Entry 存储着键值对。它包含了四个字段,从 next 字段可以看出 Entry 是一个链表。即数组中的每个位置被当成一个桶,一个桶存放一个链表。HashMap 使用拉链法来解决冲突,同一个链表中存放哈希值对桶的数量取模结果相同的 Entry。
- 
+ 
```java
transient Entry[] table;
@@ -498,8 +521,8 @@ map.put("K3", "V3");
```
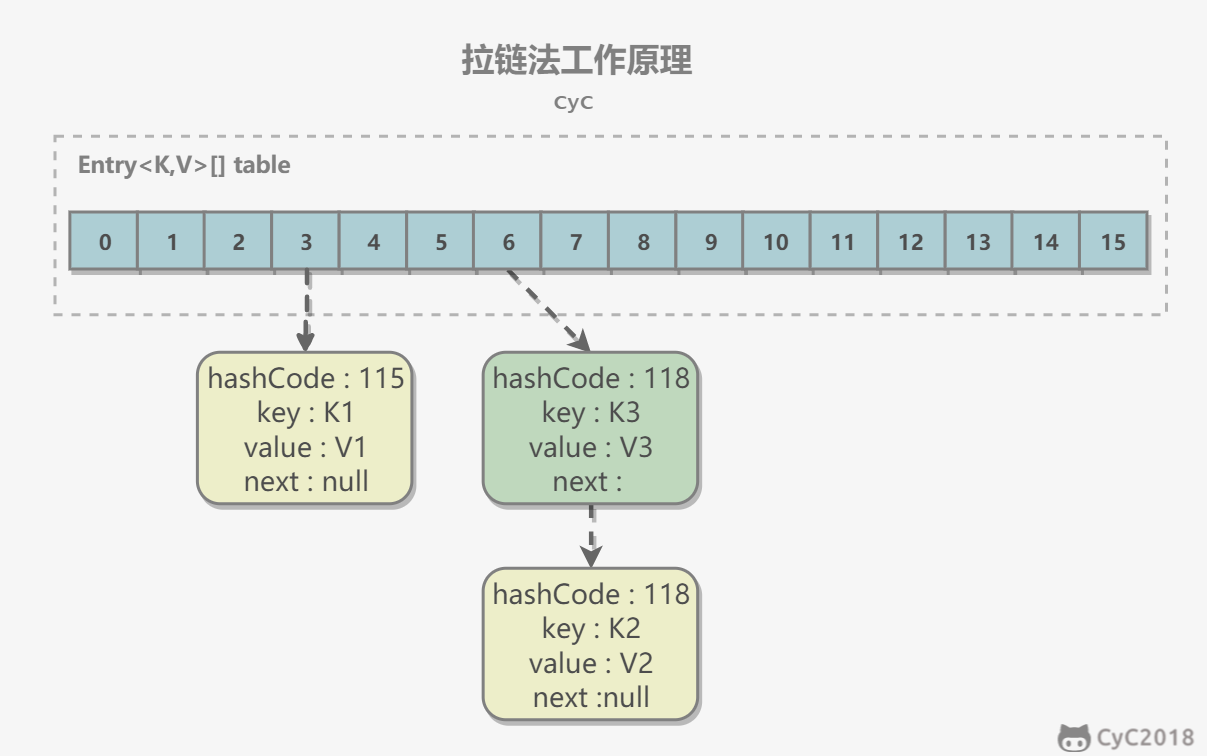
- 新建一个 HashMap,默认大小为 16;
-- 插入 <K1,V1\> 键值对,先计算 K1 的 hashCode,为了便于说明,假设为 115(实际上 "K1".hashCode() 是 2374),使用除留余数法得到所在的桶下标 115%16=3。
-- 插入 <K2,V2\> 键值对,假设 K2 的 hashCode 为 118,使用除留余数法得到所在的桶下标 118%16=6。
+- 插入 <K1,V1\> 键值对,先计算 K1 的 hashCode,为了便于说明,假设为 115(实际上 "K1".hashCode() 是 2374),使用除留余数法得到所在的桶下标 115%16=3;
+- 插入 <K2,V2\> 键值对,假设 K2 的 hashCode 为 118,使用除留余数法得到所在的桶下标 118%16=6;
- 插入 <K3,V3\> 键值对,假设 K3 的 hashCode 也为 118,使用除留余数法得到所在的桶下标 118%16=6,插在 <K2,V2\> 前面。
应该注意到链表的插入是以头插法方式进行的,例如上面的 <K3,V3\> 不是插在 <K2,V2\> 后面,而是插入在链表头部。JDK 1.8 改成了尾插法。
@@ -509,7 +532,7 @@ map.put("K3", "V3");
- 计算键值对所在的桶;
- 在链表上顺序查找,时间复杂度显然和链表的长度成正比。
- 
+ 
#### 3. put 操作
@@ -599,7 +622,7 @@ int hash = hash(key);
int i = indexFor(hash, table.length);
```
-**4.1 计算 hash 值**
+##### 4.1 计算哈希值
```java
final int hash(Object k) {
@@ -618,13 +641,16 @@ final int hash(Object k) {
}
```
+JDK 1.8 简化为一次扰动:
+
```java
-public final int hashCode() {
- return Objects.hashCode(key) ^ Objects.hashCode(value);
+static final int hash(Object key) {
+ int h;
+ return (key == null) ? 0 : (h = key.hashCode()) ^ (h >>> 16);
}
```
-**4.2 取模**
+##### 4.2 取模
令 x = 1\<\<4,即 x 为 2 的 4 次方,它具有以下性质:
@@ -649,9 +675,9 @@ x : 00010000
y%x : 00000010
```
-我们知道,位运算的代价比求模运算小的多,因此在进行这种计算时用位运算的话能带来更高的性能。
+位运算的代价比求模运算小得多,因此在进行这种计算时用位运算的话能带来更高的性能。
-确定桶下标的最后一步是将 key 的 hash 值对桶个数取模:hash%capacity,如果能保证 capacity 为 2 的 n 次方,那么就可以将这个操作转换为位运算。
+确定桶下标的最后一步是将 key 的哈希值对桶个数取模:hash%capacity,如果能保证 capacity 为 2 的 n 次方,那么就可以将这个操作转换为位运算。
```java
static int indexFor(int h, int length) {
@@ -671,7 +697,7 @@ static int indexFor(int h, int length) {
| :--: | :-- |
| capacity | table 的容量大小,默认为 16。需要注意的是 capacity 必须保证为 2 的 n 次方。|
| size | 键值对数量。 |
-| threshold | size 的临界值,当 size 大于等于 threshold 就必须进行扩容操作。 |
+| threshold | size 的临界值。JDK 1.7 中 size 大于等于 threshold、并且要插入的桶不为空时扩容;JDK 1.8 中插入后 size 大于 threshold 时扩容。 |
| loadFactor | 装载因子,table 能够使用的比例,threshold = (int)(capacity* loadFactor)。 |
```java
@@ -744,7 +770,7 @@ void transfer(Entry[] newTable) {
假设原数组长度 capacity 为 16,扩容之后 new capacity 为 32:
-```html
+```text
capacity : 00010000
new capacity : 00100000
```
@@ -754,6 +780,8 @@ new capacity : 00100000
- 为 0,那么 hash%00010000 = hash%00100000,桶位置和原来一致;
- 为 1,hash%00100000 = hash%00010000 + 16,桶位置是原位置 + 16。
+JDK 1.8 的 resize() 就利用了这个性质:遍历旧桶中的链表,按 (hash & oldCap) 是否为 0 把节点分到 lo、hi 两条链表,分别放到新数组的 j 和 j + oldCap 位置,链表中节点的相对顺序保持不变。
+

#### 7. 计算数组容量
@@ -795,22 +823,24 @@ static final int tableSizeFor(int cap) {
#### 9. 与 Hashtable 的比较
-- Hashtable 使用 synchronized 来进行同步。
-- HashMap 可以插入键为 null 的 Entry。
-- HashMap 的迭代器是 fail-fast 迭代器。
+- Hashtable 使用 synchronized 来进行同步;
+- HashMap 可以插入键为 null 的 Entry;
+- HashMap 的迭代器是 fail-fast 迭代器;
- HashMap 不能保证随着时间的推移 Map 中的元素次序是不变的。
#### 10. 线程安全
-HashMap 不是线程安全的。例如两个线程同时向同一个空桶插入,都判断桶为空,后写入的会覆盖先写入的;size++ 也不是原子操作。在 JDK 21 上用 8 个线程各插入 10 万个不同的键,HashMap 的 size 每次都不同,例如 281854、463269,远少于 80 万;同样的操作 ConcurrentHashMap 每次都是 800000。
+HashMap 不是线程安全的。例如两个线程同时向同一个空桶插入,都判断桶为空,后写入的会覆盖先写入的;size++ 也不是原子操作。用 8 个线程各插入 10 万个不同的键,HashMap 的 size 每次都不同,例如 111068、323870,远少于 80 万;同样的操作 ConcurrentHashMap 每次都是 800000(JDK 21 实测,见[附录 A2](#a2-hashmap-的并发写入))。
-JDK 1.7 的问题更严重:两个线程同时扩容时,头插法会把链表的顺序反转,可能让链表形成环,之后在这个桶上的 get 会陷入死循环。JDK 1.8 改为尾插法,扩容时保持链表原来的顺序,不会再成环,但并发写入仍然会丢失数据。多线程环境应该使用 ConcurrentHashMap。
+JDK 1.7 的问题更严重:两个线程同时扩容时,头插法会把链表的顺序反转,可能让链表形成环,之后在这个桶上的 get 会陷入死循环。JDK 1.8 改为尾插法,扩容时保持链表原来的顺序,不会再因为头插法成环,但并发写入仍然会丢失数据;链表转为红黑树时还可能破坏树的结构,实测中出现过线程抛出 ClassCastException,以及线程在 TreeNode.treeify() 中一直循环不返回的情况(见[附录 A2](#a2-hashmap-的并发写入))。多线程环境应该使用 ConcurrentHashMap。
### ConcurrentHashMap
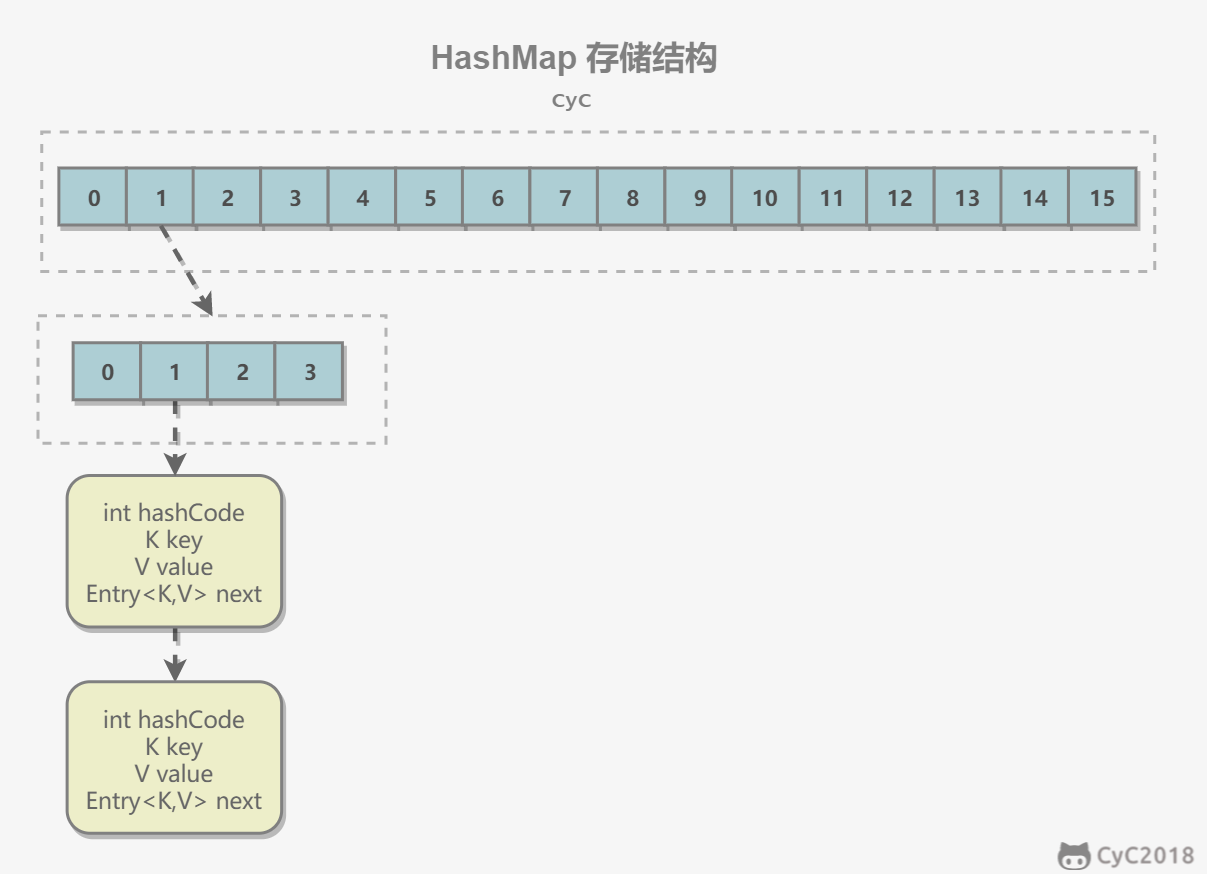
+第 1、2 节是 JDK 1.7 的实现,JDK 1.8 的改动见第 3 节。
+
#### 1. 存储结构
- 
+ 
```java
static final class HashEntry {
@@ -876,7 +906,6 @@ ConcurrentHashMap 在执行 size 操作时先尝试不加锁,如果连续两
如果尝试的次数超过 3 次,就需要对每个 Segment 加锁。
```java
-
/**
* Number of unsynchronized retries in size and containsValue
* methods before resorting to locking. This is used to avoid
@@ -937,7 +966,7 @@ JDK 1.8 去掉了 Segment,和 HashMap 一样使用 Node 数组加链表(或
1. 用 spread() 计算哈希值,把 hashCode 的高 16 位异或到低 16 位,让高位也参与决定桶下标;
2. 如果桶是空的,用 CAS 把新节点放进去,不加锁。CAS 失败说明有其它线程刚刚放入了节点,重新循环;
3. 如果桶的头节点是 ForwardingNode(哈希值为 MOVED),说明正在扩容,当前线程先帮忙迁移数据;
-4. 否则用 synchronized 锁住桶的头节点,在链表或红黑树中插入或更新,链表长度达到 8 时转为红黑树;
+4. 否则用 synchronized 锁住桶的头节点,在链表或红黑树中插入或更新,链表长度达到 8 时转为红黑树,数组长度小于 64 时则只扩容;
5. 最后更新元素个数。
get 不加锁:数组元素通过 Unsafe 的 volatile 方式读取,节点的 val 和 next 都是 volatile,能读到其它线程写入的最新值。
@@ -1045,7 +1074,7 @@ protected boolean removeEldestEntry(Map.Entry eldest) {
以下是使用 LinkedHashMap 实现的一个 LRU 缓存:
-- 设定最大缓存空间 MAX_ENTRIES 为 3;
+- 设定最大缓存空间 MAX_ENTRIES 为 3;
- 使用 LinkedHashMap 的构造函数将 accessOrder 设置为 true,开启 LRU 顺序;
- 覆盖 removeEldestEntry() 方法实现,在节点多于 MAX_ENTRIES 就会将最近最久未使用的数据移除。
@@ -1075,7 +1104,7 @@ public static void main(String[] args) {
}
```
-```html
+```text
[3, 1, 4]
```
@@ -1083,7 +1112,7 @@ public static void main(String[] args) {
#### 存储结构
-WeakHashMap 的 Entry 继承自 WeakReference,被 WeakReference 关联的对象在下一次垃圾回收时会被回收。
+WeakHashMap 的 Entry 继承自 WeakReference,键被 WeakReference 关联,没有其它强引用时,键在下一次垃圾收集时会被回收,对应的 Entry 随后从 Map 中清除。
WeakHashMap 主要用来实现缓存,通过使用 WeakHashMap 来引用缓存对象,由 JVM 对这部分缓存进行回收。
@@ -1098,8 +1127,8 @@ Tomcat 中的 ConcurrentCache 使用了 WeakHashMap 来实现缓存功能。
ConcurrentCache 采取的是分代缓存:
- 经常使用的对象放入 eden 中,eden 使用 ConcurrentHashMap 实现,不用担心会被回收(伊甸园);
-- 不常用的对象放入 longterm,longterm 使用 WeakHashMap 实现,这些老对象会被垃圾收集器回收。
-- 当调用 get() 方法时,会先从 eden 区获取,如果没有找到的话再到 longterm 获取,当从 longterm 获取到就把对象放入 eden 中,从而保证经常被访问的节点不容易被回收。
+- 不常用的对象放入 longterm,longterm 使用 WeakHashMap 实现,这些老对象会被垃圾收集器回收;
+- 当调用 get() 方法时,会先从 eden 区获取,如果没有找到的话再到 longterm 获取,当从 longterm 获取到就把对象放入 eden 中,从而保证经常被访问的节点不容易被回收;
- 当调用 put() 方法时,如果 eden 的大小超过了 size,那么就将 eden 中的所有对象都放入 longterm 中,利用虚拟机回收掉一部分不经常使用的对象。
```java
@@ -1138,6 +1167,82 @@ public final class ConcurrentCache {
```
+## 附录:实测
+
+以下实验的环境为 Apple M1 Pro(10 核)、macOS,JDK 为 Adoptium OpenJDK 21.0.13。
+
+### A1 ArrayList 的扩容与常见陷阱
+
+用反射读取 elementData 的长度,运行时需要加上 --add-opens java.base/java.util=ALL-UNNAMED:
+
+```java
+Field f = ArrayList.class.getDeclaredField("elementData");
+f.setAccessible(true);
+ArrayList list = new ArrayList<>();
+for (int i = 1; i <= 23; i++) {
+ list.add("e" + i);
+ int cap = ((Object[]) f.get(list)).length; // 容量变化时打印
+}
+```
+
+```text
+new ArrayList<>():容量 0
+添加第 1 个元素后:容量 10,size 1
+添加第 11 个元素后:容量 15,size 11
+添加第 16 个元素后:容量 22,size 16
+添加第 23 个元素后:容量 33,size 23
+```
+
+正文中 foreach 删除元素和 Arrays.asList() 的几种用法:
+
+```text
+foreach 中 remove:ConcurrentModificationException
+Iterator.remove:[b, c]
+removeIf:[b, c]
+asList set:[10, 2, 3]
+asList add:UnsupportedOperationException
+修改数组后 list:[100, 2, 3]
+Arrays.asList(int[]).size():1
+```
+
+ArrayList 与 LinkedList 的插入:先放入 10 万个元素,再执行 list.add(list.size() / 2, i) 1 万次;另外从空列表开始执行 list.add(0, i) 10 万次:
+
+```text
+round 0: 10 万个元素中间插入 1 万次 ArrayList 51 ms,LinkedList 844 ms;头部插入 10 万次 ArrayList 445 ms,LinkedList 2 ms
+round 1: 10 万个元素中间插入 1 万次 ArrayList 47 ms,LinkedList 1029 ms;头部插入 10 万次 ArrayList 441 ms,LinkedList 3 ms
+round 2: 10 万个元素中间插入 1 万次 ArrayList 47 ms,LinkedList 831 ms;头部插入 10 万次 ArrayList 441 ms,LinkedList 0 ms
+```
+
+### A2 HashMap 的并发写入
+
+8 个线程各插入 10 万个不同的键(线程 t 插入 t × 100000 到 t × 100000 + 99999),结束后查看 size:
+
+```java
+for (int t = 0; t < 8; t++) {
+ int base = t * 100_000;
+ pool.submit(() -> { for (int i = 0; i < 100_000; i++) map.put(base + i, i); });
+}
+```
+
+```text
+HashMap size=111068 ConcurrentHashMap size=800000
+HashMap size=323870 ConcurrentHashMap size=800000
+HashMap size=732440 ConcurrentHashMap size=800000
+```
+
+改用守护线程,每轮最多等待 10 秒,记录没有结束的线程停在哪里。两次运行的输出(节选):
+
+```text
+Exception in thread "putter-6" java.lang.ClassCastException: class java.util.HashMap$Node cannot be cast to class java.util.HashMap$TreeNode
+ at java.base/java.util.HashMap$TreeNode.moveRootToFront(HashMap.java:1994)
+ at java.base/java.util.HashMap$TreeNode.treeify(HashMap.java:2110)
+ at java.base/java.util.HashMap.treeifyBin(HashMap.java:778)
+run 0: size=278394 stuckThreads=0
+
+run 0: size=263620 stuckThreads=4
+ putter-4 at java.base/java.util.HashMap$TreeNode.treeify(HashMap.java:2107) / java.base/java.util.HashMap$TreeNode.split(HashMap.java:2339)
+```
+
## 参考资料
- Eckel B. Java 编程思想 [M]. 机械工业出版社, 2002.
@@ -1149,5 +1254,7 @@ public final class ConcurrentCache {
- [探索 ConcurrentHashMap 高并发性的实现机制](https://www.ibm.com/developerworks/cn/java/java-lo-concurrenthashmap/)
- [HashMap 相关面试题及其解答](https://www.jianshu.com/p/75adf47958a7)
- [Java 集合细节(二):asList 的缺陷](http://wiki.jikexueyuan.com/project/java-enhancement/java-thirtysix.html)
-- [Java Collection Framework – The LinkedList Class](http://javaconceptoftheday.com/java-collection-framework-linkedlist-class/)
-
+- [Java Collection Framework – The LinkedList Class](https://javaconceptoftheday.com/java-collection-framework-linkedlist-class/)
+- [JDK 8 源码 java.util](https://github.com/openjdk/jdk8u/tree/master/jdk/src/share/classes/java/util)
+- [Java SE 21 API: Arrays.asList](https://docs.oracle.com/en/java/javase/21/docs/api/java.base/java/util/Arrays.html#asList(T...))
+- [Java SE 21 API: ArrayDeque](https://docs.oracle.com/en/java/javase/21/docs/api/java.base/java/util/ArrayDeque.html)
diff --git a/notes/pics/jcol-arraylist.png b/notes/pics/jcol-arraylist.png
new file mode 100644
index 00000000..c21d3fb9
Binary files /dev/null and b/notes/pics/jcol-arraylist.png differ
diff --git a/notes/pics/jcol-chaining.png b/notes/pics/jcol-chaining.png
new file mode 100644
index 00000000..b39ea540
Binary files /dev/null and b/notes/pics/jcol-chaining.png differ
diff --git a/notes/pics/jcol-chm7.png b/notes/pics/jcol-chm7.png
new file mode 100644
index 00000000..3891b31b
Binary files /dev/null and b/notes/pics/jcol-chm7.png differ
diff --git a/notes/pics/jcol-collection.png b/notes/pics/jcol-collection.png
new file mode 100644
index 00000000..79cde018
Binary files /dev/null and b/notes/pics/jcol-collection.png differ
diff --git a/notes/pics/jcol-hashmap.png b/notes/pics/jcol-hashmap.png
new file mode 100644
index 00000000..0d74f409
Binary files /dev/null and b/notes/pics/jcol-hashmap.png differ
diff --git a/notes/pics/jcol-iterator.png b/notes/pics/jcol-iterator.png
new file mode 100644
index 00000000..7494024e
Binary files /dev/null and b/notes/pics/jcol-iterator.png differ
diff --git a/notes/pics/jcol-linkedlist.png b/notes/pics/jcol-linkedlist.png
new file mode 100644
index 00000000..1cd937c8
Binary files /dev/null and b/notes/pics/jcol-linkedlist.png differ
diff --git a/notes/pics/jcol-map.png b/notes/pics/jcol-map.png
new file mode 100644
index 00000000..c2ac01f1
Binary files /dev/null and b/notes/pics/jcol-map.png differ