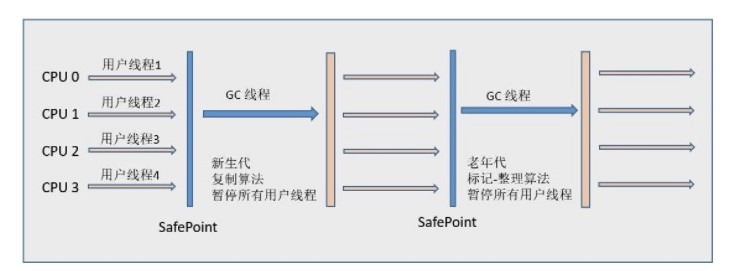
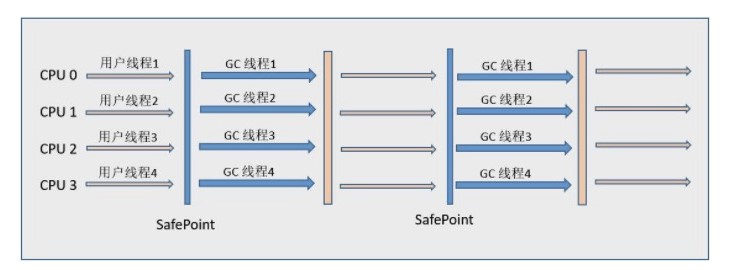
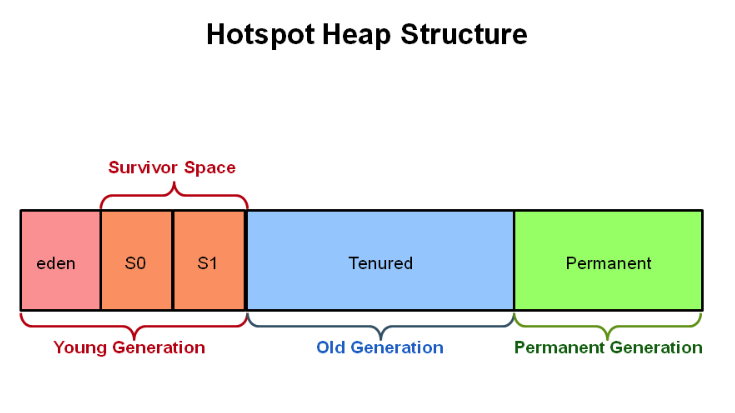
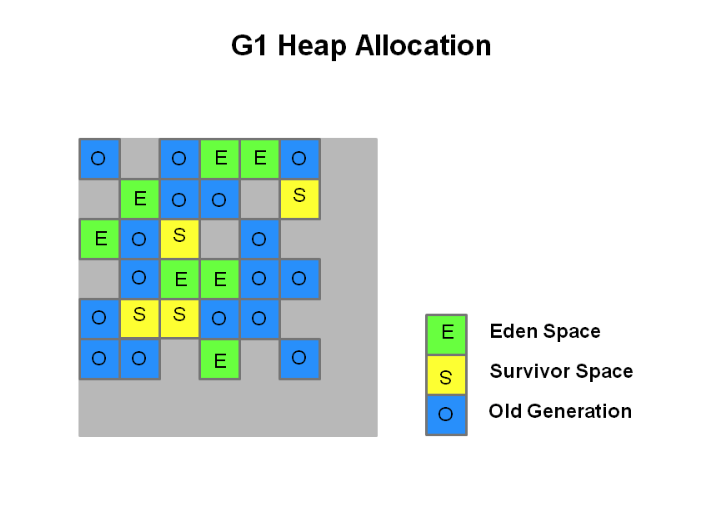
通过引入 Region 的概念,从而将原来的一整块内存空间划分成多个的小空间,使得每个小空间可以单独进行垃圾回收。这种划分方法带来了很大的灵活性,使得可预测的停顿时间模型成为可能。通过记录每个 Region 垃圾回收时间以及回收所获得的空间(这两个值是通过过去回收的经验获得),并维护一个优先列表,每次根据允许的收集时间,优先回收价值最大的 Region。
每个 Region 都有一个 Remembered Set,用来记录该 Region 对象的引用对象所在的 Region。通过使用 Remembered Set,在做可达性分析的时候就可以避免全堆扫描。
-
+
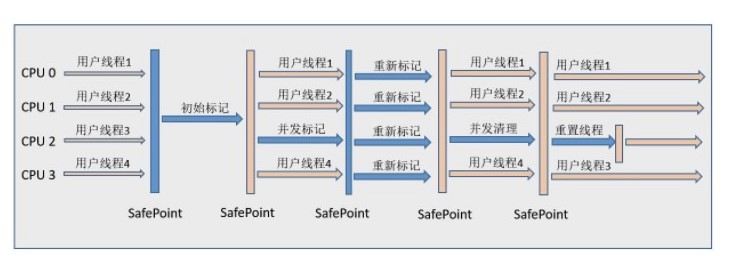
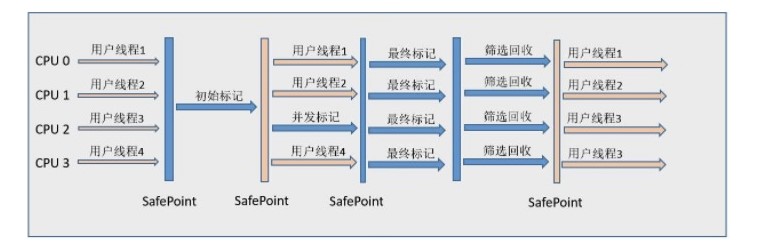
如果不计算维护 Remembered Set 的操作,G1 收集器的运作大致可划分为以下几个步骤:
-- 初始标记
-- 并发标记
-- 最终标记:为了修正在并发标记期间因用户程序继续运作而导致标记产生变动的那一部分标记记录,虚拟机将这段时间对象变化记录在线程的 Remembered Set Logs 里面,最终标记阶段需要把 Remembered Set Logs 的数据合并到 Remembered Set 中。这阶段需要停顿线程,但是可并行执行。
-- 筛选回收:首先对各个 Region 中的回收价值和成本进行排序,根据用户所期望的 GC 停顿时间来制定回收计划。此阶段其实也可以做到与用户程序一起并发执行,但是因为只回收一部分 Region,时间是用户可控制的,而且停顿用户线程将大幅度提高收集效率。
+- 初始标记:在一次年轻代回收中顺带完成(Concurrent Start),标记 GC Roots 直接关联的对象,需要停顿;
+- 并发标记:与用户线程同时运行,找出老年代中所有存活的对象,期间年轻代回收照常进行;
+- 最终标记(Remark):短暂停顿,处理并发标记期间用户线程修改引用留下的记录,完成标记,并直接回收完全空的 Region;
+- 清理与混合回收:清理(Cleanup)停顿根据各 Region 的回收价值决定是否进入回收阶段;之后的多次混合回收(Mixed)除了年轻代,再挑选一部分垃圾最多的老年代 Region,把其中存活的对象复制出去,每次回收的数量受停顿时间目标(MaxGCPauseMillis,默认 200 ms)限制。
具备如下特点:
- 空间整合:整体来看是基于“标记 - 整理”算法实现的收集器,从局部(两个 Region 之间)上来看是基于“复制”算法实现的,这意味着运行期间不会产生内存空间碎片。
- 可预测的停顿:能让使用者明确指定在一个长度为 M 毫秒的时间片段内,消耗在 GC 上的时间不得超过 N 毫秒。
+同一个程序(不断分配 1~5 KB 的数组,其中四分之一存活较久)在本机用 JDK 21、128 MB 的堆分别运行,停顿情况如下:
+
+| 收集器 | 停顿次数 | 停顿总时长 | 最长停顿 |
+| --- | --- | --- | --- |
+| Serial | 39 | 121.6 ms | 12.13 ms |
+| Parallel | 75 | 117.7 ms | 6.18 ms |
+| G1 | 88 | 49.1 ms | 2.38 ms |
+
+G1 停顿的次数更多,但每次都很短,适合对响应时间敏感的服务。
+
+#### 8. ZGC 收集器
+
+ZGC 的目标是让停顿时间不随堆的大小增长,JDK 15 起可以用于生产(JEP 377),JDK 21 加入了分代模式(JEP 439),JDK 23 起分代成为默认模式(JEP 474),JDK 24 移除了不分代的模式(JEP 490)。
+
+G1 的年轻代回收和混合回收都要在停顿中把存活对象复制到新的 Region,存活对象越多,停顿越长。ZGC 把标记和复制都放到与用户线程并发执行的阶段,停顿中只做扫描 GC Roots 这类少量工作,所以停顿很短,而且与堆的大小无关。
+
+并发复制的难点在于,对象被移走时,用户线程手里可能还拿着指向旧地址的引用。ZGC 用着色指针和读屏障解决这个问题:
+
+- 着色指针:ZGC 的对象引用固定为 64 位,除了对象的地址,还用其中几位元数据记录状态,例如对象是否已被标记、引用中的地址是否已经更新,看一眼引用就知道它是否可能指向旧地址;
+- 读屏障:JIT 在每次从堆中读取引用的地方插入一小段检查,发现引用还指向旧地址,就查转发表换成新地址,并把字段中的引用一起改掉,下次再读就不需要修正了。分代 ZGC 还在写入引用的地方加了写屏障,用来记录老年代对象指向年轻代对象的引用。
+
+同一个程序在本机用 JDK 21 的分代 ZGC 运行:
+
+| 堆大小 | 停顿次数 | 停顿总时长 | 最长停顿 | 分配停顿(Allocation Stall) |
+| --- | --- | --- | --- | --- |
+| 128 MB | 125 | 0.60 ms | 0.016 ms | 46 次,共 108.6 ms,最长 16.5 ms |
+| 512 MB | 43 | 0.27 ms | 0.012 ms | 0 次 |
+
+ZGC 的停顿都在 0.03 ms 以内,比 G1 短两个数量级。但堆只有 128 MB 时,程序分配内存的速度超过了并发回收的速度,没有空闲的内存可用,分配内存的线程只能等待回收完成,日志中记为 Allocation Stall,对用户来说与停顿无异。所以使用 ZGC 要给堆留出足够的余量,代价是占用更多的内存,读屏障也会让吞吐量略有下降。
+
## 三、内存分配与回收策略
### Minor GC 和 Full GC
@@ -505,7 +594,7 @@ G1 把堆划分成多个大小相等的独立区域(Region),新生代和
#### 3. 准备
-类变量是被 static 修饰的变量,准备阶段为类变量分配内存并设置初始值,使用的是方法区的内存。
+类变量是被 static 修饰的变量,准备阶段为类变量分配内存并设置初始值。在 JDK 7 之前类变量放在方法区(永久代)中,JDK 7 起随 Class 对象一起放在堆中。
实例变量不会在这阶段分配内存,它会在对象实例化时随着对象一起被分配在堆中。应该注意到,实例化不是类加载的一个过程,类加载发生在所有实例化操作之前,并且类加载只进行一次,实例化可以进行多次。
@@ -563,7 +652,7 @@ public static void main(String[] args) {
}
```
-接口中不可以使用静态语句块,但仍然有类变量初始化的赋值操作,因此接口与类一样都会生成 <clinit\>() 方法。但接口与类不同的是,执行接口的 <clinit\>() 方法不需要先执行父接口的 <clinit\>() 方法。只有当父接口中定义的变量使用时,父接口才会初始化。另外,接口的实现类在初始化时也一样不会执行接口的 <clinit\>() 方法。
+接口中不可以使用静态语句块,但仍然有类变量初始化的赋值操作,因此接口与类一样都会生成 <clinit\>() 方法。但接口与类不同的是,执行接口的 <clinit\>() 方法不需要先执行父接口的 <clinit\>() 方法。只有当父接口中定义的变量使用时,父接口才会初始化。另外,接口的实现类在初始化时一般也不会执行接口的 <clinit\>() 方法,例外是接口中定义了 default 方法时,实现类初始化之前要先初始化这个接口。
虚拟机会保证一个类的 <clinit\>() 方法在多线程环境下被正确的加锁和同步,如果多个线程同时初始化一个类,只会有一个线程执行这个类的 <clinit\>() 方法,其它线程都会阻塞等待,直到活动线程执行 <clinit\>() 方法完毕。如果在一个类的 <clinit\>() 方法中有耗时的操作,就可能造成多个线程阻塞,在实际过程中此种阻塞很隐蔽。
@@ -571,7 +660,7 @@ public static void main(String[] args) {
#### 1. 主动引用
-虚拟机规范中并没有强制约束何时进行加载,但是规范严格规定了有且只有下列五种情况必须对类进行初始化(加载、验证、准备都会随之发生):
+虚拟机规范中并没有强制约束何时进行加载,但是规范严格规定了有且只有下列六种情况必须对类进行初始化(加载、验证、准备都会随之发生):
- 遇到 new、getstatic、putstatic、invokestatic 这四条字节码指令时,如果类没有进行过初始化,则必须先触发其初始化。最常见的生成这 4 条指令的场景是:使用 new 关键字实例化对象的时候;读取或设置一个类的静态字段(被 final 修饰、已在编译期把结果放入常量池的静态字段除外)的时候;以及调用一个类的静态方法的时候。
@@ -583,9 +672,11 @@ public static void main(String[] args) {
- 当使用 JDK 1.7 的动态语言支持时,如果一个 java.lang.invoke.MethodHandle 实例最后的解析结果为 REF_getStatic, REF_putStatic, REF_invokeStatic 的方法句柄,并且这个方法句柄所对应的类没有进行过初始化,则需要先触发其初始化;
+- 当一个接口定义了 default 方法时,如果它的实现类发生了初始化,要先初始化这个接口。例如 Impl 同时实现了带 default 方法的 WithDefault 和不带 default 方法的 NoDefault,new Impl() 时在 JDK 21 上依次输出“WithDefault 初始化”“Impl 初始化”,NoDefault 没有被初始化。
+
#### 2. 被动引用
-以上 5 种场景中的行为称为对一个类进行主动引用。除此之外,所有引用类的方式都不会触发初始化,称为被动引用。被动引用的常见例子包括:
+以上 6 种场景中的行为称为对一个类进行主动引用。除此之外,所有引用类的方式都不会触发初始化,称为被动引用。被动引用的常见例子包括:
- 通过子类引用父类的静态字段,不会导致子类初始化。
@@ -627,6 +718,16 @@ System.out.println(ConstClass.HELLOWORLD);
- 应用程序类加载器(Application ClassLoader)这个类加载器是由 AppClassLoader(sun.misc.Launcher$AppClassLoader)实现的。由于这个类加载器是 ClassLoader 中的 getSystemClassLoader() 方法的返回值,因此一般称为系统类加载器。它负责加载用户类路径(ClassPath)上所指定的类库,开发者可以直接使用这个类加载器,如果应用程序中没有自定义过自己的类加载器,一般情况下这个就是程序中默认的类加载器。
+以上是 JDK 8 的情况。JDK 9 引入模块系统后,rt.jar 和 lib/ext 目录都被移除,扩展类加载器被平台类加载器(Platform ClassLoader)取代,负责加载 java.sql 等部分平台模块。三层加载器的父子关系不变,只是加载命名模块中的类时,会直接交给定义该模块的加载器。在 JDK 21 上打印:
+
+```text
+Loaders 的类加载器: jdk.internal.loader.ClassLoaders$AppClassLoader
+它的父加载器: jdk.internal.loader.ClassLoaders$PlatformClassLoader
+再上一层: null(启动类加载器,在 Java 中用 null 表示)
+java.sql.Driver: jdk.internal.loader.ClassLoaders$PlatformClassLoader
+String: null
+```
+
### 双亲委派模型
应用程序是由三种类加载器互相配合从而实现类加载,除此之外还可以加入自己定义的类加载器。
@@ -744,6 +845,39 @@ public class FileSystemClassLoader extends ClassLoader {
## 五、线上问题排查
+### JVM 调优
+
+调优之前先明确目标:在线服务关心最长停顿时间,批处理任务关心吞吐量。大多数情况下先使用默认的 G1,开启 GC 日志观察,确实有问题再调整参数;线上的 GC 问题大多是代码造成的,例如内存泄漏、一次查询加载了太多数据,只调参数解决不了。
+
+常用的参数:
+
+| 参数 | 作用 |
+| --- | --- |
+| -Xms、-Xmx | 堆的初始大小和最大值,线上通常设为相同,避免运行中扩容和收缩 |
+| -XX:MaxRAMPercentage | 不指定 -Xmx 时,最大堆占物理内存(容器中为容器的内存限制)的比例,默认 25% |
+| -Xss | 每个线程的栈大小 |
+| -XX:MaxMetaspaceSize | 元空间的上限,默认不限制 |
+| -XX:+UseG1GC、-XX:+UseZGC | 选择垃圾收集器,JDK 9 起默认 G1 |
+| -XX:MaxGCPauseMillis | G1 的停顿时间目标,默认 200 ms |
+| -Xlog:gc*:file=gc.log | 输出 GC 日志(JDK 9 起;JDK 8 使用 -XX:+PrintGCDetails -Xloggc:gc.log) |
+| -XX:+HeapDumpOnOutOfMemoryError | 内存溢出时保存堆转储 |
+
+例如一个程序长期持有约 60 MB 的对象,同时不断创建短命的对象。在本机用 JDK 21 和 G1 分别以 72 MB 和 256 MB 的堆运行:
+
+| 堆大小 | 年轻代回收 | Full GC | 停顿总时长 | 最长停顿 | 运行时间 |
+| --- | --- | --- | --- | --- | --- |
+| 72 MB | 449 次 | 6 次 | 195.4 ms | 7.34 ms | 460 ms |
+| 256 MB | 43 次 | 0 次 | 48.1 ms | 1.34 ms | 318 ms |
+
+堆太小时,存活的对象几乎占满了老年代,日志中反复出现 Pause Full (G1 Compaction Pause) 70M->28M(72M):每次 Full GC 后仍有一半以上的空间被占用,很快又满了。
+
+线上频繁 Full GC 的排查思路:
+
+1. 用 jstat -gcutil 观察老年代使用率(O 列)和 Full GC 次数(FGC 列);
+2. Full GC 之后老年代使用率仍然很高,并且越来越高,说明对象一直无法回收,导出堆转储查找内存泄漏;
+3. Full GC 之后老年代能降下来,说明堆对于正常的负载偏小,或者有大对象、大量对象过早进入老年代,可以增大堆、调整新生代大小,或者从代码上减少一次创建的数据量;
+4. 元空间不足也会触发 Full GC,日志中的原因为 Metadata GC Threshold,检查是否在动态生成大量的类。
+
### 内存溢出与内存泄漏
OutOfMemoryError 的详细信息指明了是哪一块内存不足,常见的有:
@@ -831,10 +965,14 @@ Found one Java-level deadlock:
- [JNI Part1: Java Native Interface Introduction and “Hello World” application](http://electrofriends.com/articles/jni/jni-part1-java-native-interface/)
- [Memory Architecture Of JVM(Runtime Data Areas)](https://hackthejava.wordpress.com/2015/01/09/memory-architecture-by-jvmruntime-data-areas/)
- [JVM Run-Time Data Areas](https://www.programcreek.com/2013/04/jvm-run-time-data-areas/)
-- [Android on x86: Java Native Interface and the Android Native Development Kit](http://www.drdobbs.com/architecture-and-design/android-on-x86-java-native-interface-and/240166271)
-- [深入理解 JVM(2)——GC 算法与内存分配策略](https://crowhawk.github.io/2017/08/10/jvm_2/)
-- [深入理解 JVM(3)——7 种垃圾收集器](https://crowhawk.github.io/2017/08/15/jvm_3/)
+- [Android on x86: Java Native Interface and the Android Native Development Kit](https://web.archive.org/web/20240706002000/https://www.drdobbs.com/architecture-and-design/android-on-x86-java-native-interface-and/240166271)
+- [深入理解 JVM(2)——GC 算法与内存分配策略](https://web.archive.org/web/20201120232823/https://crowhawk.github.io/2017/08/10/jvm_2/)
+- [深入理解 JVM(3)——7 种垃圾收集器](https://web.archive.org/web/20201120232823/https://crowhawk.github.io/2017/08/15/jvm_3/)
- [JVM Internals](http://blog.jamesdbloom.com/JVMInternals.html)
- [深入探讨 Java 类加载器](https://www.ibm.com/developerworks/cn/java/j-lo-classloader/index.html#code6)
- [Guide to WeakHashMap in Java](http://www.baeldung.com/java-weakhashmap)
- [Tomcat example source code file (ConcurrentCache.java)](https://alvinalexander.com/java/jwarehouse/apache-tomcat-6.0.16/java/org/apache/el/util/ConcurrentCache.java.shtml)
+- [Garbage-First (G1) Garbage Collector | Java SE 17 GC Tuning Guide](https://docs.oracle.com/en/java/javase/17/gctuning/garbage-first-g1-garbage-collector1.html)
+- [The Z Garbage Collector | Java SE 21 GC Tuning Guide](https://docs.oracle.com/en/java/javase/21/gctuning/z-garbage-collector.html)
+- [JEP 439: Generational ZGC](https://openjdk.org/jeps/439)
+- [JEP 490: ZGC: Remove the Non-Generational Mode](https://openjdk.org/jeps/490)
diff --git a/notes/pics/gc-cms.png b/notes/pics/gc-cms.png
new file mode 100644
index 00000000..8df701cc
Binary files /dev/null and b/notes/pics/gc-cms.png differ
diff --git a/notes/pics/gc-collectors.png b/notes/pics/gc-collectors.png
new file mode 100644
index 00000000..a5cc6143
Binary files /dev/null and b/notes/pics/gc-collectors.png differ
diff --git a/notes/pics/gc-g1-cycle.png b/notes/pics/gc-g1-cycle.png
new file mode 100644
index 00000000..bc22faca
Binary files /dev/null and b/notes/pics/gc-g1-cycle.png differ
diff --git a/notes/pics/gc-g1-regions.png b/notes/pics/gc-g1-regions.png
new file mode 100644
index 00000000..41733ed7
Binary files /dev/null and b/notes/pics/gc-g1-regions.png differ
diff --git a/notes/pics/gc-generations.png b/notes/pics/gc-generations.png
new file mode 100644
index 00000000..4ff636be
Binary files /dev/null and b/notes/pics/gc-generations.png differ
diff --git a/notes/pics/gc-parallel.png b/notes/pics/gc-parallel.png
new file mode 100644
index 00000000..c98615f2
Binary files /dev/null and b/notes/pics/gc-parallel.png differ
diff --git a/notes/pics/gc-parnew.png b/notes/pics/gc-parnew.png
new file mode 100644
index 00000000..7f8466b8
Binary files /dev/null and b/notes/pics/gc-parnew.png differ
diff --git a/notes/pics/gc-serial.png b/notes/pics/gc-serial.png
new file mode 100644
index 00000000..20960677
Binary files /dev/null and b/notes/pics/gc-serial.png differ
diff --git a/tools/diagram/src/gc-cms.svg b/tools/diagram/src/gc-cms.svg
new file mode 100644
index 00000000..4168ec35
--- /dev/null
+++ b/tools/diagram/src/gc-cms.svg
@@ -0,0 +1,68 @@
+
diff --git a/tools/diagram/src/gc-collectors.svg b/tools/diagram/src/gc-collectors.svg
new file mode 100644
index 00000000..1103f4d7
--- /dev/null
+++ b/tools/diagram/src/gc-collectors.svg
@@ -0,0 +1,63 @@
+
diff --git a/tools/diagram/src/gc-g1-cycle.svg b/tools/diagram/src/gc-g1-cycle.svg
new file mode 100644
index 00000000..cb61fa08
--- /dev/null
+++ b/tools/diagram/src/gc-g1-cycle.svg
@@ -0,0 +1,65 @@
+
diff --git a/tools/diagram/src/gc-g1-regions.svg b/tools/diagram/src/gc-g1-regions.svg
new file mode 100644
index 00000000..b2c2b45f
--- /dev/null
+++ b/tools/diagram/src/gc-g1-regions.svg
@@ -0,0 +1,178 @@
+
diff --git a/tools/diagram/src/gc-generations.svg b/tools/diagram/src/gc-generations.svg
new file mode 100644
index 00000000..7377a9b8
--- /dev/null
+++ b/tools/diagram/src/gc-generations.svg
@@ -0,0 +1,48 @@
+
diff --git a/tools/diagram/src/gc-parallel.svg b/tools/diagram/src/gc-parallel.svg
new file mode 100644
index 00000000..c6dadf49
--- /dev/null
+++ b/tools/diagram/src/gc-parallel.svg
@@ -0,0 +1,65 @@
+
diff --git a/tools/diagram/src/gc-parnew.svg b/tools/diagram/src/gc-parnew.svg
new file mode 100644
index 00000000..260fd117
--- /dev/null
+++ b/tools/diagram/src/gc-parnew.svg
@@ -0,0 +1,62 @@
+
diff --git a/tools/diagram/src/gc-serial.svg b/tools/diagram/src/gc-serial.svg
new file mode 100644
index 00000000..14815223
--- /dev/null
+++ b/tools/diagram/src/gc-serial.svg
@@ -0,0 +1,59 @@
+