diff --git a/notes/pics/cdn.png b/notes/pics/cdn.png
new file mode 100644
index 00000000..e29eac63
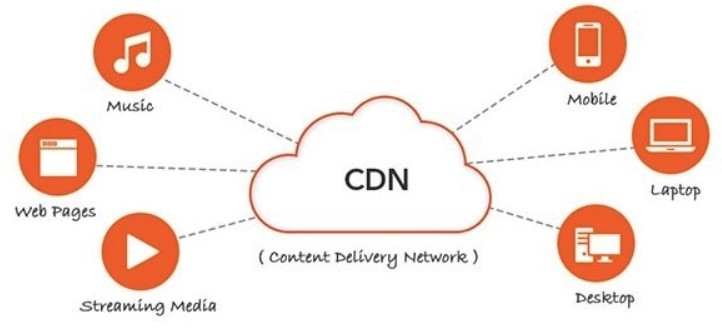
Binary files /dev/null and b/notes/pics/cdn.png differ
diff --git a/notes/pics/consistent-hash.png b/notes/pics/consistent-hash.png
new file mode 100644
index 00000000..b3dad47a
Binary files /dev/null and b/notes/pics/consistent-hash.png differ
diff --git a/notes/pics/multilevel-cache.png b/notes/pics/multilevel-cache.png
new file mode 100644
index 00000000..55e590d7
Binary files /dev/null and b/notes/pics/multilevel-cache.png differ
diff --git a/notes/缓存.md b/notes/缓存.md
index 5e4f6aad..84ff119a 100644
--- a/notes/缓存.md
+++ b/notes/缓存.md
@@ -60,6 +60,33 @@
相对于本地缓存来说,分布式缓存单独部署,可以根据需求分配硬件资源。不仅如此,服务器集群都可以访问分布式缓存,而本地缓存需要在服务器集群之间进行同步,实现难度和性能开销上都非常大。
+### 多级缓存
+
+多级缓存把本地缓存和分布式缓存组合起来:先查本地缓存,未命中再查 Redis,再未命中才查数据库,并逐级回填。
+
+ 
+
+在本机测试,Caffeine 读取一次约 21 纳秒;redis-benchmark 用单个连接逐条发送 GET,每次约 71 微秒,相差三千多倍,这还只是本机回环,跨机器访问还要加上网络往返。热点数据放在本地缓存中,既省去了网络开销,也不会让请求集中到存放这个热点键的 Redis 节点上。
+
+本地缓存在每个实例中各存一份,难点在于数据更新后怎样让所有实例失效:
+
+- 更新数据库后删除 Redis 中的键,再通过 Redis 的发布订阅或消息队列广播一条删除消息,各实例收到后删除自己的本地缓存;
+- Redis 的发布订阅不保证送达,实例断线期间的消息会丢失,所以本地缓存还要设置较短的过期时间(例如 30 秒)兜底;
+- 因此本地缓存只适合读多写少、能接受短暂不一致的数据,例如商品详情、配置;库存、余额这类数据不要放在本地缓存中。
+
+Caffeine 是目前常用的本地缓存库,使用方式如下:
+
+```java
+Cache cache = Caffeine.newBuilder()
+ .maximumSize(10_000) // 最多 1 万个,超出时淘汰
+ .expireAfterWrite(Duration.ofSeconds(30)) // 写入 30 秒后过期
+ .build();
+
+Product p = cache.get("product:1024", key -> loadFromRedisOrDb(key));
+```
+
+它的淘汰算法 W-TinyLFU 同时考虑访问频率和最近访问时间,命中率通常高于 LRU;get 传入的加载函数对同一个键只会执行一次,其它并发的请求等待它的结果,避免缓存未命中时大量请求同时查询下游。
+
### 数据库缓存
MySQL 等数据库管理系统具有自己的缓存机制来提高查询效率,例如 InnoDB 的 Buffer Pool 将数据页和索引页缓存在内存中。MySQL 的查询缓存因为命中率低、维护开销大,已经在 8.0 版本中被移除。
@@ -84,7 +111,7 @@ CDN 主要有以下优点:
- 通过部署多台服务器,从而提高系统整体的带宽性能;
- 多台服务器可以看成是一种冗余机制,从而具有高可用性。
-
+
## 四、缓存问题
@@ -99,7 +126,7 @@ CDN 主要有以下优点:
布隆过滤器用多个哈希函数把 Key 映射到位数组的多个位置并置为 1。查询时只要有一个位置为 0,Key 就一定不存在;全部为 1 时 Key 可能存在,存在一定的误判率。
-
+
### 缓存击穿
@@ -132,7 +159,7 @@ CDN 主要有以下优点:
删除缓存而不是更新缓存,是因为两个并发的写操作到达缓存的顺序可能和到达数据库的顺序不同,导致缓存中是旧值。先更新数据库再删除缓存,是因为反过来的话,删除缓存之后、更新数据库之前的读请求会把旧值重新写入缓存。
-
+
这种模式仍然存在小概率的不一致,例如删除缓存失败。常用的补救措施:
@@ -205,11 +232,9 @@ CDN 主要有以下优点:
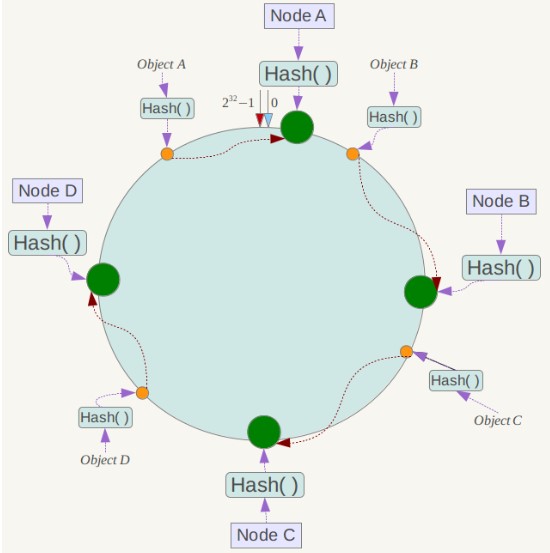
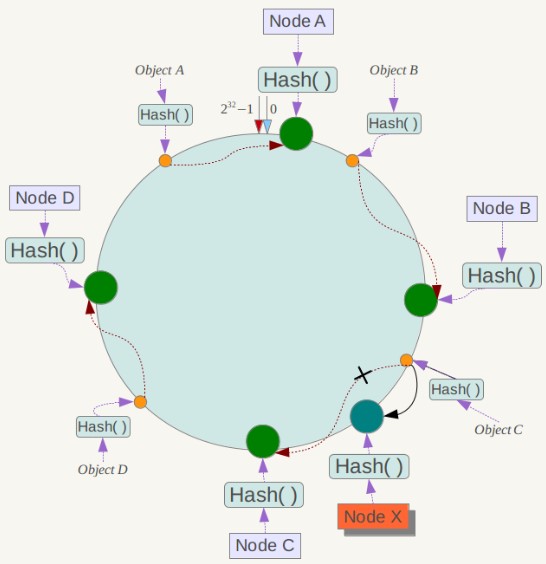
将哈希空间 [0, 2n-1] 看成一个哈希环,每个服务器节点都通过哈希配置到哈希环上。每个数据对象通过哈希函数得到哈希值之后,存放到哈希环中顺时针方向第一个大于等于该哈希值的节点上。
-
-
一致性哈希在增加或者删除节点时只会影响到哈希环中相邻的节点,例如下图中在 B 和 C 之间新增节点 X,只需要将节点 C 上哈希值位于 B 和 X 之间的数据迁移到 X 上即可,对于节点 A、B、D 都没有影响。
-
+
### 虚拟节点
@@ -228,7 +253,7 @@ Redis Cluster 使用的不是一致性哈希,而是把 Key 映射到固定的
- 访问某个节点时,将其从原来的位置删除,并重新插入到链表头部。这样就能保证链表尾部存储的就是最近最久未使用的节点,当节点数量大于缓存最大空间时就淘汰链表尾部的节点。
- 为了使删除操作时间复杂度为 O(1),就不能采用遍历的方式找到某个节点。HashMap 存储着 Key 到节点的映射,通过 Key 就能以 O(1) 的时间得到节点,然后再以 O(1) 的时间将其从双向队列中删除。
-
+
Java 的 LinkedHashMap 内部就是这种结构,把 accessOrder 设为 true 并重写 removeEldestEntry 方法,就可以直接得到一个 LRU 缓存。
@@ -368,3 +393,4 @@ public class LRU implements Iterable {
- [How Aspiration CDN helps to improve your website loading speed?](https://www.aspirationhosting.com/aspiration-cdn/)
- [Redis: UNLINK](https://redis.io/docs/latest/commands/unlink/)
- [Redis CLI](https://redis.io/docs/latest/develop/tools/cli/)
+- [Caffeine Wiki](https://github.com/ben-manes/caffeine/wiki)