diff --git a/notes/pics/er-many-one.png b/notes/pics/er-many-one.png
new file mode 100644
index 00000000..9c61d0e0
Binary files /dev/null and b/notes/pics/er-many-one.png differ
diff --git a/notes/pics/er-prerequisite.png b/notes/pics/er-prerequisite.png
new file mode 100644
index 00000000..47ed0aed
Binary files /dev/null and b/notes/pics/er-prerequisite.png differ
diff --git a/notes/pics/er-subclass.png b/notes/pics/er-subclass.png
new file mode 100644
index 00000000..f11b9872
Binary files /dev/null and b/notes/pics/er-subclass.png differ
diff --git a/notes/pics/er-ternary.png b/notes/pics/er-ternary.png
new file mode 100644
index 00000000..c27d97e8
Binary files /dev/null and b/notes/pics/er-ternary.png differ
diff --git a/notes/pics/lock-protocol-2.png b/notes/pics/lock-protocol-2.png
deleted file mode 100644
index c37a6bc2..00000000
Binary files a/notes/pics/lock-protocol-2.png and /dev/null differ
diff --git a/notes/pics/next-key-locks.png b/notes/pics/next-key-locks.png
deleted file mode 100644
index cb623375..00000000
Binary files a/notes/pics/next-key-locks.png and /dev/null differ
diff --git a/notes/pics/readview.png b/notes/pics/readview.png
deleted file mode 100644
index 049d2005..00000000
Binary files a/notes/pics/readview.png and /dev/null differ
diff --git a/notes/数据库系统原理.md b/notes/数据库系统原理.md
index 8192a199..cd897c78 100644
--- a/notes/数据库系统原理.md
+++ b/notes/数据库系统原理.md
@@ -7,9 +7,9 @@
* [AUTOCOMMIT](#autocommit)
* [二、并发一致性问题](#二并发一致性问题)
* [丢失修改](#丢失修改)
- * [读脏数据](#读脏数据)
+ * [脏读](#脏读)
* [不可重复读](#不可重复读)
- * [幻影读](#幻影读)
+ * [幻读](#幻读)
* [三、封锁](#三封锁)
* [封锁粒度](#封锁粒度)
* [封锁类型](#封锁类型)
@@ -39,6 +39,12 @@
* [表示出现多次的关系](#表示出现多次的关系)
* [联系的多向性](#联系的多向性)
* [表示子类](#表示子类)
+ * [附录:实测](#附录实测)
+ * [A1 并发一致性问题](#a1-并发一致性问题)
+ * [A2 可串行化与快照读](#a2-可串行化与快照读)
+ * [A3 事务 ID 的分配](#a3-事务-id-的分配)
+ * [A4 快照读与当前读混用](#a4-快照读与当前读混用)
+ * [A5 Next-Key Locks 的加锁范围](#a5-next-key-locks-的加锁范围)
* [参考资料](#参考资料)
@@ -77,10 +83,10 @@
事务的 ACID 特性概念简单,但不是很好理解,主要是因为这几个特性不是一种平级关系:
-- 只有满足一致性,事务的执行结果才是正确的。
-- 在无并发的情况下,事务串行执行,隔离性一定能够满足。此时只要能满足原子性,就一定能满足一致性。
-- 在并发的情况下,多个事务并行执行,事务不仅要满足原子性,还需要满足隔离性,才能满足一致性。
-- 事务满足持久化是为了能应对系统崩溃的情况。
+- 只有满足一致性,事务的执行结果才是正确的;
+- 在无并发的情况下,事务串行执行,隔离性一定能够满足,此时只要能满足原子性,就一定能满足一致性;
+- 在并发的情况下,多个事务并行执行,事务不仅要满足原子性,还需要满足隔离性,才能满足一致性;
+- 事务满足持久性是为了能应对系统崩溃的情况。
在 InnoDB 中,这四个特性分别这样实现:
@@ -93,11 +99,11 @@
### AUTOCOMMIT
-MySQL 默认采用自动提交模式。也就是说,如果不显式使用`START TRANSACTION`语句来开始一个事务,那么每个查询操作都会被当做一个事务并自动提交。
+MySQL 默认采用自动提交模式。也就是说,如果不显式使用 START TRANSACTION 或 BEGIN 开始一个事务,那么每条语句都会被当做一个事务并自动提交。
## 二、并发一致性问题
-在并发环境下,事务的隔离性很难保证,因此会出现很多并发一致性问题。以下例子都是在 MySQL 8.0 上用两个会话实际执行得到的,表 account 中原有 id 为 1、2 的两行,余额都是 100。
+在并发环境下,事务的隔离性很难保证,因此会出现很多并发一致性问题。以下例子中,表 account 原有 id 为 1、2 的两行,余额都是 100,图中的结果是在 MySQL 8.0 上用两个会话实际执行得到的(见[附录 A1](#a1-并发一致性问题))。
### 丢失修改
@@ -105,21 +111,21 @@ MySQL 默认采用自动提交模式。也就是说,如果不显式使用`STAR
-### 读脏数据
+### 脏读
-读脏数据指在不同的事务下,当前事务可以读到另外事务未提交的数据。例如:T1 修改一个数据但未提交,T2 随后读取这个数据。如果 T1 撤销了这次修改,那么 T2 读取的数据是脏数据。
+脏读指一个事务读到了另一个事务还没有提交的数据。例如:T1 修改一个数据但未提交,T2 随后读取这个数据。如果 T1 撤销了这次修改,那么 T2 读取的数据是脏数据。
### 不可重复读
-不可重复读指在一个事务内多次读取同一数据集合。在这一事务还未结束前,另一事务也访问了该同一数据集合并做了修改,由于第二个事务的修改,第一次事务的两次读取的数据可能不一致。例如:T2 读取一个数据,T1 对该数据做了修改。如果 T2 再次读取这个数据,此时读取的结果和第一次读取的结果不同。
+不可重复读指一个事务内两次读取同一行,结果不同,原因是两次读取之间另一个事务修改并提交了这一行。例如:T2 读取一个数据,T1 修改了这个数据并提交,T2 再次读取时,结果和第一次不同。
-### 幻影读
+### 幻读
-幻读本质上也属于不可重复读的情况,T2 读取某个范围的数据,T1 在这个范围内插入新的数据,T2 再次读取这个范围的数据,此时读取的结果和第一次读取的结果不同。
+幻读本质上也属于不可重复读的情况:T2 读取某个范围的数据,T1 在这个范围内插入新的数据,T2 再次读取这个范围的数据时,多出了新插入的行。不可重复读针对的是同一行被修改,幻读针对的是范围内的行数变化。
@@ -144,13 +150,13 @@ MySQL 中提供了两种封锁粒度:行级锁以及表级锁。
#### 1. 读写锁
-- 互斥锁(Exclusive),简写为 X 锁,又称写锁。
+- 排他锁(Exclusive),简写为 X 锁,又称写锁;
- 共享锁(Shared),简写为 S 锁,又称读锁。
有以下两个规定:
-- 一个事务对数据对象 A 加了 X 锁,就可以对 A 进行读取和更新。加锁期间其它事务不能对 A 加任何锁。
-- 一个事务对数据对象 A 加了 S 锁,可以对 A 进行读取操作,但是不能进行更新操作。加锁期间其它事务能对 A 加 S 锁,但是不能加 X 锁。
+- 一个事务对数据对象 A 加了 X 锁,就可以对 A 进行读取和更新,加锁期间其它事务不能对 A 加任何锁;
+- 一个事务对数据对象 A 加了 S 锁,可以对 A 进行读取操作,但是不能进行更新操作,加锁期间其它事务能对 A 加 S 锁,但是不能加 X 锁。
锁的兼容关系如下:
@@ -183,14 +189,14 @@ MySQL 中提供了两种封锁粒度:行级锁以及表级锁。
解释如下:
-- 任意 IS/IX 锁之间都是兼容的,因为它们只表示想要对表加锁,而不是真正加锁;
-- 这里兼容关系针对的是表级锁,而表级的 IX 锁和行级的 X 锁兼容,两个事务可以对两个数据行加 X 锁。(事务 T1 想要对数据行 R1 加 X 锁,事务 T2 想要对同一个表的数据行 R2 加 X 锁,两个事务都需要对该表加 IX 锁,但是 IX 锁是兼容的,并且 IX 锁与行级的 X 锁也是兼容的,因此两个事务都能加锁成功,对同一个表中的两个数据行做修改。)
+- 任意 IS/IX 锁之间都是兼容的,因为它们只表示想要对表中的某些行加锁,而不是真正锁住整张表;
+- 表中的兼容关系只针对表级锁。例如事务 T1 要修改行 R1,事务 T2 要修改同一张表的行 R2,两者都先对表加 IX 锁(IX 与 IX 兼容),再分别对 R1、R2 加行级 X 锁,互不冲突;如果这时另一个事务要对整张表加 X 锁,就会和 IX 锁冲突,不需要逐行检查。
### 封锁协议
#### 1. 三级封锁协议
-**一级封锁协议**
+##### 1.1 一级封锁协议
事务 T 要修改数据 A 时必须加 X 锁,直到 T 结束才释放锁。
@@ -198,15 +204,15 @@ MySQL 中提供了两种封锁粒度:行级锁以及表级锁。
-**二级封锁协议**
+##### 1.2 二级封锁协议
在一级的基础上,要求读取数据 A 时必须加 S 锁,读取完马上释放 S 锁。
-可以解决读脏数据问题,因为如果一个事务在对数据 A 进行修改,根据 1 级封锁协议,会加 X 锁,那么就不能再加 S 锁了,也就是不会读入数据。
+可以解决脏读问题,因为如果一个事务在对数据 A 进行修改,根据 1 级封锁协议,会加 X 锁,那么就不能再加 S 锁了,也就是不会读入数据。
-**三级封锁协议**
+##### 1.3 三级封锁协议
在二级的基础上,要求读取数据 A 时必须加 S 锁,直到事务结束了才能释放 S 锁。
@@ -216,30 +222,30 @@ MySQL 中提供了两种封锁粒度:行级锁以及表级锁。
#### 2. 两段锁协议
-加锁和解锁分为两个阶段进行。
+两段锁协议指的是每个事务的加锁和解锁分为两个阶段:先是只加锁不解锁的扩展阶段,一旦释放了某个锁,就进入只解锁不加锁的收缩阶段。
可串行化调度是指,通过并发控制,使得并发执行的事务结果与某个串行执行的事务结果相同。串行执行的事务互不干扰,不会出现并发一致性问题。
事务遵循两段锁协议是保证可串行化调度的充分条件。例如以下操作满足两段锁协议,它是可串行化调度。
-```html
+```text
lock-x(A)...lock-s(B)...lock-s(C)...unlock(A)...unlock(C)...unlock(B)
```
但不是必要条件,例如以下操作不满足两段锁协议,但它还是可串行化调度。
-```html
+```text
lock-x(A)...unlock(A)...lock-s(B)...unlock(B)...lock-s(C)...unlock(C)
```
### MySQL 隐式与显式锁定
-MySQL 的 InnoDB 存储引擎采用两段锁协议,会根据隔离级别在需要的时候自动加锁,并且所有的锁都是在同一时刻被释放,这被称为隐式锁定。
+MySQL 的 InnoDB 存储引擎采用两段锁协议,会根据隔离级别在需要的时候自动加锁,所有的锁都在事务提交或回滚时一起释放,这被称为隐式锁定。
InnoDB 也可以使用特定的语句进行显式锁定:
```sql
-SELECT ... LOCK In SHARE MODE;
+SELECT ... FOR SHARE; -- MySQL 8.0 之前写作 LOCK IN SHARE MODE
SELECT ... FOR UPDATE;
```
@@ -261,20 +267,20 @@ SELECT ... FOR UPDATE;
保证并发执行的结果与某种串行执行的结果相同,不会出现并发一致性问题。
-InnoDB 的实现方式是在关闭自动提交时,把普通的 SELECT 都变成加共享锁的 SELECT ... FOR SHARE,读和写会互相阻塞,并发度最低。实测在可串行化的事务中读取 id 为 1 的行之后,另一个事务修改这一行会一直等待,直到锁等待超时;同样的操作在可重复读下可以立即完成。
+InnoDB 的实现方式是在关闭自动提交时,把普通的 SELECT 都变成加共享锁的 SELECT ... FOR SHARE,读和写会互相阻塞,并发度最低:可串行化的事务读过的行,另一个事务要修改就得等它结束(见[附录 A2](#a2-可串行化与快照读))。
----
各个隔离级别能否避免并发一致性问题:
-| 隔离级别 | 脏读 | 不可重复读 | 幻影读 |
+| 隔离级别 | 脏读 | 不可重复读 | 幻读 |
| :---: | :---: | :---: | :---: |
| 未提交读 | 可能 | 可能 | 可能 |
| 提交读 | 不可能 | 可能 | 可能 |
| 可重复读 | 不可能 | 不可能 | 可能 |
| 可串行化 | 不可能 | 不可能 | 不可能 |
-这是 SQL 标准的规定。MySQL 的 InnoDB 默认使用可重复读,并且用 MVCC 和 Next-Key Locks 在很大程度上避免了幻影读,见 [六、Next-Key Locks](#六next-key-locks);Oracle 和 PostgreSQL 默认使用提交读。
+这是 SQL 标准的规定。MySQL 的 InnoDB 默认使用可重复读,并且用 MVCC 和 Next-Key Locks 在很大程度上避免了幻读,见 [六、Next-Key Locks](#六next-key-locks);Oracle 和 PostgreSQL 默认使用提交读。
## 五、多版本并发控制
@@ -290,7 +296,7 @@ InnoDB 的实现方式是在关闭自动提交时,把普通的 SELECT 都变
### 版本号
-InnoDB 为每个事务分配一个递增的事务 ID(TRX_ID),每个数据行都记录着最后修改它的事务 ID。需要注意的是,事务 ID 不是在 BEGIN 时分配的,而是在事务第一次修改数据时才分配;只读的事务不分配真正的事务 ID,也就不会出现在其它事务的 ReadView 中。在 MySQL 8.0 中实测:事务执行 SELECT 时 information_schema.innodb_trx 中显示的 trx_id 是一个很大的临时编号 281479674465408,执行 UPDATE 之后变为 3095。
+InnoDB 为每个事务分配一个递增的事务 ID(TRX_ID),每个数据行都记录着最后修改它的事务 ID。需要注意的是,事务 ID 不是在 BEGIN 时分配的,而是在事务第一次修改数据时才分配;只读的事务不分配真正的事务 ID,也就不会出现在其它事务的 ReadView 中。在 information_schema.innodb_trx 中可以看到,事务只执行过 SELECT 时 trx_id 是一个很大的临时编号,执行 UPDATE 之后才变成真正的事务 ID(见[附录 A3](#a3-事务-id-的分配))。
### Undo 日志
@@ -317,8 +323,9 @@ MVCC 维护了一个 ReadView 结构,主要包含了创建 ReadView 时系统
在进行 SELECT 操作时,根据数据行快照的 TRX_ID 与 TRX_ID_MIN 和 TRX_ID_MAX 之间的关系,从而判断数据行快照是否可以使用:
-- TRX_ID \< TRX_ID_MIN,表示该数据行快照是在当前所有未提交事务之前进行更改的,因此可以使用。
-- TRX_ID \>= TRX_ID_MAX,表示该数据行快照是在 ReadView 创建之后被更改的,因此不可使用。
+- TRX_ID 等于当前事务自己的 ID,表示是本事务修改的,可以使用;
+- TRX_ID \< TRX_ID_MIN,表示该数据行快照是在当前所有未提交事务之前进行更改的,因此可以使用;
+- TRX_ID \>= TRX_ID_MAX,表示该数据行快照是在 ReadView 创建之后被更改的,因此不可使用;
- TRX_ID_MIN \<= TRX_ID \< TRX_ID_MAX,如果 TRX_ID 在 TRX_IDs 列表中,表示该数据行快照对应的事务还未提交,则该快照不可使用。否则表示已经提交,可以使用。
提交读和可重复读的判断规则相同,区别在于 ReadView 的创建时机:提交读在每次 SELECT 时都创建新的 ReadView,因此能读到其它事务新提交的修改;可重复读只在事务第一次 SELECT 时创建 ReadView,之后一直复用,因此多次读取的结果相同。
@@ -329,7 +336,7 @@ MVCC 维护了一个 ReadView 结构,主要包含了创建 ReadView 时系统
-在 MySQL 8.0 上实际执行:事务 103 未提交时,可重复读的读事务读到 'b';103 提交之后,这个读事务再读仍然是 'b',而新开始的提交读事务读到 'c'。
+事务 103 提交之后,这个可重复读的事务再读仍然是 'b',而新开始的提交读事务读到 'c'(见[附录 A2](#a2-可串行化与快照读))。
### 快照读与当前读
@@ -364,7 +371,7 @@ Next-Key Locks 是 MySQL 的 InnoDB 存储引擎的一种锁实现。
在可重复读(REPEATABLE READ)隔离级别下,MVCC 使普通的 SELECT(快照读)不会读到其它事务新插入的行,但是 UPDATE、DELETE、SELECT ... FOR UPDATE 等当前读仍然可能出现幻读,Next-Key Locks 就是为了解决这个问题而存在的。InnoDB 使用 MVCC + Next-Key Locks 在可重复读隔离级别下解决了幻读问题。
-需要注意的是,这要求一个事务中的读取全部是快照读或者全部是当前读,两者混用时仍然会出现幻读。在 MySQL 8.0 中实测,表 acct 原有 id 为 1、2 的两行:
+需要注意的是,这要求一个事务中的读取全部是快照读或者全部是当前读,两者混用时仍然会出现幻读。例如表 acct 原有 id 为 1、2 的两行(MySQL 8.0 实测,见[附录 A4](#a4-快照读与当前读混用)):
```text
A:SELECT * FROM acct WHERE balance >= 100; -- id 1、2
@@ -374,13 +381,13 @@ A:UPDATE acct SET balance = balance + 10 WHERE balance >= 100; -- Rows matched
A:SELECT * FROM acct WHERE balance >= 100; -- id 1、2、3
```
-事务 A 的 UPDATE 是当前读,看到了事务 B 新插入并已提交的第 3 行,并且修改了它;这一行最新版本的事务 ID 变成了 A 自己,所以之后的快照读也能看到它。如果 A 一开始就用 SELECT ... FOR UPDATE 加锁读取,B 的插入会被 Next-Key Locks 阻塞,直到锁等待超时(ERROR 1205 Lock wait timeout exceeded)。
+事务 A 的 UPDATE 是当前读,看到了事务 B 新插入并已提交的第 3 行,并且修改了它;这一行最新版本的事务 ID 变成了 A 自己,所以之后的快照读也能看到它。如果 A 一开始就用 SELECT ... FOR UPDATE 加锁读取,B 的插入会被 Next-Key Locks 阻塞,直到 A 结束或者锁等待超时。
### Record Locks
锁定一个记录上的索引,而不是记录本身。
-如果表没有设置索引,InnoDB 会自动在主键上创建隐藏的聚簇索引,因此 Record Locks 依然可以使用。
+如果表没有定义主键,InnoDB 会选第一个所有列都 NOT NULL 的唯一索引作为聚簇索引;连这样的索引也没有时,就在隐藏的 6 字节行 ID 上创建聚簇索引(GEN_CLUST_INDEX),因此 Record Locks 依然可以使用。
### Gap Locks
@@ -402,7 +409,7 @@ SELECT c FROM t WHERE c BETWEEN 10 and 20 FOR UPDATE;
(20, +∞)
```
-在 MySQL 8.0 中建表 t(id, c),c 上有普通索引,插入 c 为 10、11、13、20 的四行,然后在可重复读下执行两种加锁读,从 performance_schema.data_locks 中查看实际加的锁,并在另一个事务中尝试插入:
+以表 t(id, c) 为例,c 上有普通索引,有 c 为 10、11、13、20 的四行。在可重复读下执行两种加锁读,实际加的锁和对插入的影响如下(从 performance_schema.data_locks 中查看,见[附录 A5](#a5-next-key-locks-的加锁范围)):
@@ -446,7 +453,7 @@ SELECT c FROM t WHERE c BETWEEN 10 and 20 FOR UPDATE;
#### 1. 第一范式 (1NF)
-属性不可分。
+属性不可分。例如“联系方式”一列中同时存放了电话和邮箱,就不满足 1NF,应该拆成两列。
#### 2. 第二范式 (2NF)
@@ -454,7 +461,7 @@ SELECT c FROM t WHERE c BETWEEN 10 and 20 FOR UPDATE;
可以通过分解来满足。
- **分解前**
+分解前:
| Sno | Sname | Sdept | Mname | Cname | Grade |
| :---: | :---: | :---: | :---: | :---: |:---:|
@@ -473,7 +480,7 @@ Grade 完全函数依赖于键码,它没有任何冗余数据,每个学生
Sname, Sdept 和 Mname 都部分依赖于键码,当一个学生选修了多门课时,这些数据就会出现多次,造成大量冗余数据。
- **分解后**
+分解后:
关系-1
@@ -528,41 +535,140 @@ Sname, Sdept 和 Mname 都部分依赖于键码,当一个学生选修了多门
## 八、ER 图
-Entity-Relationship,有三个组成部分:实体、属性、联系。
-
-用来进行关系型数据库系统的概念设计。
+实体-联系图(Entity-Relationship Diagram)用来进行关系型数据库的概念设计,有三个组成部分:实体(矩形)、属性(椭圆)、联系(菱形)。
### 实体的三种联系
-包含一对一,一对多,多对多三种。
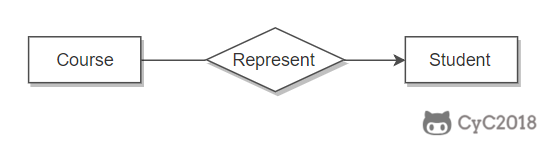
+包含一对一、多对一、多对多三种,箭头指向“一”的一方:
-- 如果 A 到 B 是一对多关系,那么画个带箭头的线段指向 B;
-- 如果是一对一,画两个带箭头的线段;
-- 如果是多对多,画两个不带箭头的线段。
+- 如果每个 A 最多对应一个 B(A 到 B 是多对一),就画一个指向 B 的箭头;
+- 如果是一对一,两端都画箭头;
+- 如果是多对多,两端都不画箭头。
-下图的 Course 和 Student 是一对多的关系。
-
-
+
### 表示出现多次的关系
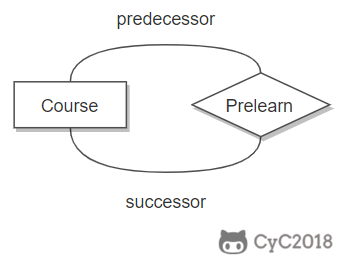
一个实体在联系出现几次,就要用几条线连接。
-下图表示一个课程的先修关系,先修关系出现两个 Course 实体,第一个是先修课程,后一个是后修课程,因此需要用两条线来表示这种关系。
+下图表示课程的先修关系,联系中出现两个 Course 实体,一个是先修课程,一个是后续课程,因此需要用两条线来表示。
-
+
### 联系的多向性
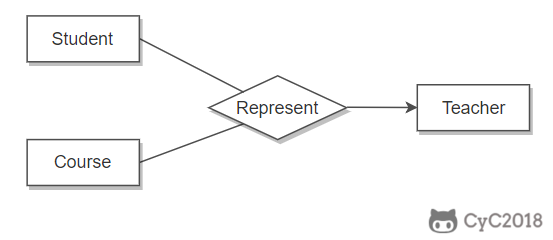
虽然老师可以开设多门课,并且可以教授多名学生,但是对于特定的学生和课程,只有一个老师教授,这就构成了一个三元联系。
-
+
### 表示子类
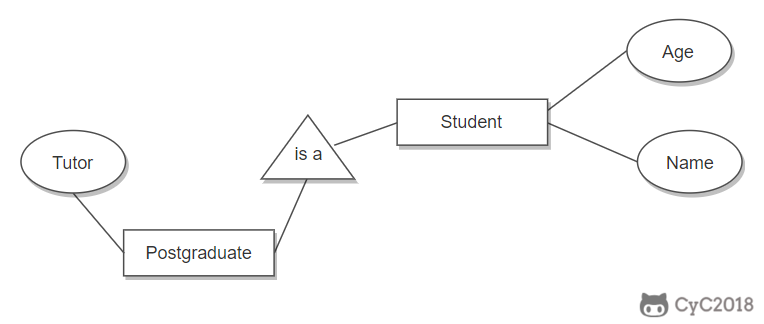
用一个三角形和两条线来连接类和子类,与子类有关的属性和联系都连到子类上,而与父类和子类都有关的连到父类上。
-
+
+
+## 附录:实测
+
+以下实验在 MySQL 8.0.44 上进行,用 Python 的 pymysql 开两个连接模拟两个事务。
+
+### A1 并发一致性问题
+
+每个例子开始前重建表:
+
+```sql
+CREATE TABLE account (id INT PRIMARY KEY, balance INT);
+INSERT INTO account VALUES (1, 100), (2, 100);
+```
+
+输出(A、B 分别是两个会话,-> 后为结果):
+
+```text
+丢失修改(两个会话都是 REPEATABLE READ,应用先查询再写回)
+ A: SELECT balance FROM account WHERE id = 1 -> 100
+ B: SELECT balance FROM account WHERE id = 1 -> 100
+ A: UPDATE account SET balance = 70 WHERE id = 1; COMMIT
+ B: UPDATE account SET balance = 150 WHERE id = 1; COMMIT
+ A: SELECT balance FROM account WHERE id = 1 -> 150
+改为 balance = balance - 30 / + 50:B 的 UPDATE 等待 A 的行锁,最终 -> 120
+
+脏读(B 为 READ UNCOMMITTED)
+ A: BEGIN; UPDATE account SET balance = 200 WHERE id = 1
+ B: SELECT balance FROM account WHERE id = 1 -> 200
+ A: ROLLBACK
+ B: SELECT balance FROM account WHERE id = 1 -> 100
+
+不可重复读(A 自动提交)
+ B 为 READ COMMITTED: 第一次 -> 100,A 改为 200 后第二次 -> 200
+ B 为 REPEATABLE READ: 第一次 -> 100,A 改为 200 后第二次 -> 100
+
+幻读(A 自动提交 INSERT INTO account VALUES (3, 100))
+ B 为 READ COMMITTED: SELECT id FROM account WHERE balance > 50 第一次 -> 1, 2,第二次 -> 1, 2, 3
+ B 为 REPEATABLE READ: 第一次 -> 1, 2,第二次 -> 1, 2
+```
+
+### A2 可串行化与快照读
+
+可串行化:A 以 SERIALIZABLE 开始事务并读取 id = 1 的行,B 设置 innodb_lock_wait_timeout = 1 后修改这一行:
+
+```text
+A 为 REPEATABLE READ:B 的 UPDATE 立即成功
+A 为 SERIALIZABLE: B 的 UPDATE 报错 ERROR 1205 Lock wait timeout exceeded
+```
+
+ReadView:表 t 中插入 x = 'a' 并更新为 'b'(都自动提交),会话 C 执行 BEGIN; UPDATE t SET x = 'c' 但不提交,此时会话 R 以 REPEATABLE READ 开始事务读取:
+
+```text
+R: SELECT x FROM t WHERE id = 1 -> b
+(innodb_trx 中 C 的 trx_id 为 3696,R 只读,显示为 281479674466992)
+C: COMMIT
+R: SELECT x FROM t WHERE id = 1 -> b
+新的 READ COMMITTED 事务读取 -> c
+```
+
+### A3 事务 ID 的分配
+
+```text
+BEGIN; SELECT * FROM account; innodb_trx.trx_id = 281479674465408
+UPDATE account SET balance = 1; innodb_trx.trx_id = 3095
+```
+
+### A4 快照读与当前读混用
+
+表 acct 原有 id 为 1、2 的两行,balance 都是 100。A 为 REPEATABLE READ:
+
+```text
+A: SELECT * FROM acct WHERE balance >= 100 -> 1, 2
+B: INSERT INTO acct VALUES (3, 100) (自动提交)
+A: SELECT * FROM acct WHERE balance >= 100 -> 1, 2
+A: UPDATE acct SET balance = balance + 10 WHERE balance >= 100 -> Rows matched: 3 Changed: 3
+A: SELECT * FROM acct WHERE balance >= 100 -> 1, 2, 3(balance 都是 110)
+```
+
+A 先执行 SELECT ... FROM acct WHERE balance >= 100 FOR UPDATE 时,B 的 INSERT 在 innodb_lock_wait_timeout = 1 下报错 ERROR 1205。
+
+### A5 Next-Key Locks 的加锁范围
+
+```sql
+CREATE TABLE t (id INT PRIMARY KEY, c INT, KEY idx_c (c));
+INSERT INTO t VALUES (1, 10), (2, 11), (3, 13), (4, 20);
+```
+
+A 执行加锁读后,从 performance_schema.data_locks 查询行锁(LOCK_DATA 为 c 的值和主键),B 依次尝试插入 c = 9、12、14、21:
+
+```text
+SELECT * FROM t WHERE c = 11 FOR UPDATE
+ idx_c X 11, 2
+ idx_c X,GAP 13, 3
+ PRIMARY X,REC_NOT_GAP 2
+ 插入 c = 9 成功,c = 12 阻塞,c = 14 成功,c = 21 成功
+
+SELECT * FROM t WHERE c BETWEEN 10 AND 20 FOR UPDATE
+ idx_c X 10, 1 / 11, 2 / 13, 3 / 20, 4 / supremum pseudo-record
+ PRIMARY X,REC_NOT_GAP 1 / 2 / 3 / 4
+ 插入 c = 9、12、14、21 都阻塞
+
+把 idx_c 改为唯一索引后,c = 11 FOR UPDATE 只有 uk_c X,REC_NOT_GAP 11, 2 和主键上的记录锁,插入 c = 12 成功。
+```
## 参考资料