diff --git a/notes/缓存.md b/notes/缓存.md
index f20d1dd5..d764eb08 100644
--- a/notes/缓存.md
+++ b/notes/缓存.md
@@ -28,11 +28,13 @@
### 淘汰策略
-- FIFO(First In First Out):先进先出策略,在实时性的场景下,需要经常访问最新的数据,那么就可以使用 FIFO,使得最先进入的数据(最晚的数据)被淘汰。
+- FIFO(First In First Out):先进先出策略,优先淘汰最早进入缓存的数据。实现简单,但是没有考虑数据的访问情况,命中率较低。
-- LRU(Least Recently Used):最近最久未使用策略,优先淘汰最久未使用的数据,也就是上次被访问时间距离现在最久的数据。该策略可以保证内存中的数据都是热点数据,也就是经常被访问的数据,从而保证缓存命中率。
+- LRU(Least Recently Used):最近最久未使用策略,优先淘汰最久未使用的数据,也就是上次被访问时间距离现在最久的数据。该策略可以保证内存中的数据都是热点数据,也就是经常被访问的数据,从而保证缓存命中率。缺点是偶发的批量访问会把热点数据挤出缓存。
-- LFU(Least Frequently Used):最不经常使用策略,优先淘汰一段时间内使用次数最少的数据。
+- LFU(Least Frequently Used):最不经常使用策略,优先淘汰一段时间内使用次数最少的数据。缺点是过去的热点数据即使很久不再访问也难以被淘汰。
+
+除了容量淘汰,缓存通常还会为数据设置过期时间,到期后自动失效。
## 二、缓存位置
@@ -50,17 +52,17 @@
### 本地缓存
-使用 Guava Cache 将数据缓存在服务器本地内存中,服务器代码可以直接读取本地内存中的缓存,速度非常快。
+使用 Guava Cache、Caffeine 等将数据缓存在服务器本地内存中,服务器代码可以直接读取本地内存中的缓存,速度非常快。
### 分布式缓存
-使用 Redis、Memcache 等分布式缓存将数据缓存在分布式缓存系统中。
+使用 Redis、Memcached 等分布式缓存将数据缓存在分布式缓存系统中。
相对于本地缓存来说,分布式缓存单独部署,可以根据需求分配硬件资源。不仅如此,服务器集群都可以访问分布式缓存,而本地缓存需要在服务器集群之间进行同步,实现难度和性能开销上都非常大。
### 数据库缓存
-MySQL 等数据库管理系统具有自己的查询缓存机制来提高查询效率。
+MySQL 等数据库管理系统具有自己的缓存机制来提高查询效率,例如 InnoDB 的 Buffer Pool 将数据页和索引页缓存在内存中。MySQL 的查询缓存因为命中率低、维护开销大,已经在 8.0 版本中被移除。
### Java 内部的缓存
@@ -74,6 +76,8 @@ CPU 为了解决运算速度与主存 IO 速度不匹配的问题,引入了多
内容分发网络(Content distribution network,CDN)是一种互连的网络系统,它利用更靠近用户的服务器从而更快更可靠地将 HTML、CSS、JavaScript、音乐、图片、视频等静态资源分发给用户。
+用户请求通过 DNS 被调度到最近的 CDN 节点,节点未命中缓存时再回源站获取。
+
CDN 主要有以下优点:
- 更快地将数据分发给用户;
@@ -90,8 +94,17 @@ CDN 主要有以下优点:
解决方案:
-- 对这些不存在的数据缓存一个空数据;
-- 对这类请求进行过滤。
+- 对这些不存在的数据缓存一个空数据,并设置较短的过期时间;
+- 使用布隆过滤器保存所有存在的 Key,对不存在的 Key 的请求直接拒绝。
+
+### 缓存击穿
+
+指的是某个热点数据的缓存过期时,大量对它的请求同时到达数据库。
+
+解决方案:
+
+- 使用互斥锁,只允许一个请求去数据库加载数据并写回缓存,其它请求等待后直接读缓存;
+- 热点数据不设置过期时间,或者由后台线程异步更新。
### 缓存雪崩
@@ -101,19 +114,25 @@ CDN 主要有以下优点:
解决方案:
-- 为了防止缓存在同一时间大面积过期导致的缓存雪崩,可以通过观察用户行为,合理设置缓存过期时间来实现;
-- 为了防止缓存服务器宕机出现的缓存雪崩,可以使用分布式缓存,分布式缓存中每一个节点只缓存部分的数据,当某个节点宕机时可以保证其它节点的缓存仍然可用。
-- 也可以进行缓存预热,避免在系统刚启动不久由于还未将大量数据进行缓存而导致缓存雪崩。
-
+- 为了防止缓存在同一时间大面积过期导致的缓存雪崩,可以在过期时间上加一个随机值,让过期时间分散开;
+- 为了防止缓存服务器宕机出现的缓存雪崩,可以使用分布式缓存,分布式缓存中每一个节点只缓存部分的数据,当某个节点宕机时可以保证其它节点的缓存仍然可用;
+- 也可以进行缓存预热,避免在系统刚启动不久由于还未将大量数据进行缓存而导致缓存雪崩;
+- 对数据库的访问进行限流,即使缓存失效也不至于压垮数据库。
### 缓存一致性
-缓存一致性要求数据更新的同时缓存数据也能够实时更新。
+缓存一致性要求数据更新之后缓存中不能长期保留旧数据。常用的是 Cache Aside 模式:
-解决方案:
+- 读:先读缓存,未命中则读数据库,并将结果写入缓存;
+- 写:先更新数据库,再删除缓存。
-- 在数据更新的同时立即去更新缓存;
-- 在读缓存之前先判断缓存是否是最新的,如果不是最新的先进行更新。
+删除缓存而不是更新缓存,是因为两个并发的写操作到达缓存的顺序可能和到达数据库的顺序不同,导致缓存中是旧值。先更新数据库再删除缓存,是因为反过来的话,删除缓存之后、更新数据库之前的读请求会把旧值重新写入缓存。
+
+这种模式仍然存在小概率的不一致,例如删除缓存失败。常用的补救措施:
+
+- 为缓存设置过期时间作为兜底;
+- 延迟双删:更新数据库之后,隔一小段时间再删除一次缓存;
+- 订阅数据库的 binlog(例如使用 Canal)来异步删除缓存,失败时重试。
要保证缓存一致性需要付出很大的代价,缓存数据最好是那些对一致性要求不高的数据,允许缓存数据存在一些脏数据。
@@ -148,15 +167,15 @@ CDN 主要有以下优点:
## 六、一致性哈希
-Distributed Hash Table(DHT) 是一种哈希分布方式,其目的是为了克服传统哈希分布在服务器节点数量变化时大量数据迁移的问题。
+一致性哈希(Consistent Hashing)是一种哈希分布方式,其目的是为了克服传统哈希分布在服务器节点数量变化时大量数据迁移的问题。
### 基本原理
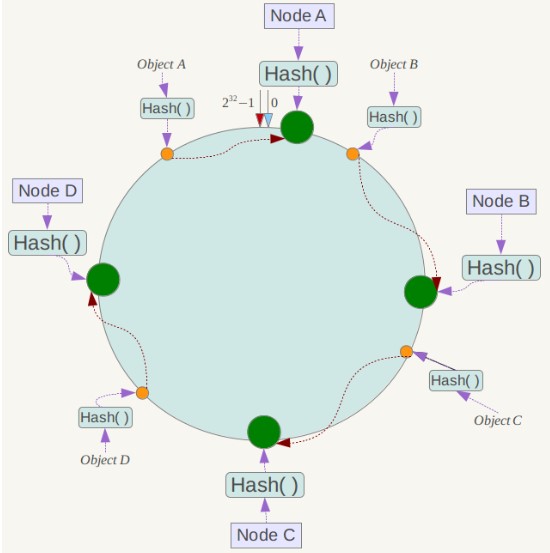
-将哈希空间 [0, 2n-1] 看成一个哈希环,每个服务器节点都配置到哈希环上。每个数据对象通过哈希取模得到哈希值之后,存放到哈希环中顺时针方向第一个大于等于该哈希值的节点上。
+将哈希空间 [0, 2n-1] 看成一个哈希环,每个服务器节点都通过哈希配置到哈希环上。每个数据对象通过哈希函数得到哈希值之后,存放到哈希环中顺时针方向第一个大于等于该哈希值的节点上。
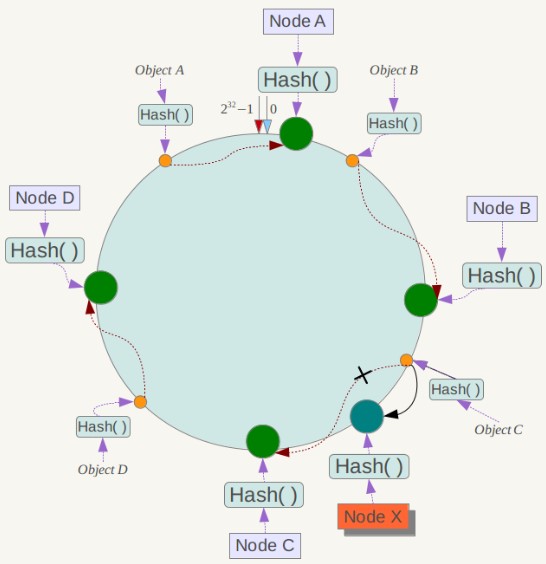
-一致性哈希在增加或者删除节点时只会影响到哈希环中相邻的节点,例如下图中新增节点 X,只需要将它前一个节点 C 上的数据重新进行分布即可,对于节点 A、B、D 都没有影响。
+一致性哈希在增加或者删除节点时只会影响到哈希环中相邻的节点,例如下图中在 B 和 C 之间新增节点 X,只需要将节点 C 上哈希值位于 B 和 X 之间的数据迁移到 X 上即可,对于节点 A、B、D 都没有影响。
@@ -168,6 +187,8 @@ Distributed Hash Table(DHT) 是一种哈希分布方式,其目的是为了
解决方式是通过增加虚拟节点,然后将虚拟节点映射到真实节点上。虚拟节点的数量比真实节点来得多,那么虚拟节点在哈希环上分布的均匀性就会比原来的真实节点好,从而使得数据分布也更加均匀。
+Redis Cluster 使用的不是一致性哈希,而是把 Key 映射到固定的 16384 个哈希槽上,再把哈希槽分配给各个节点,节点变化时只需要迁移对应的哈希槽。
+
## 七、LRU
以下是基于 双向链表 + HashMap 的 LRU 算法实现,对算法的解释如下:
@@ -175,6 +196,8 @@ Distributed Hash Table(DHT) 是一种哈希分布方式,其目的是为了
- 访问某个节点时,将其从原来的位置删除,并重新插入到链表头部。这样就能保证链表尾部存储的就是最近最久未使用的节点,当节点数量大于缓存最大空间时就淘汰链表尾部的节点。
- 为了使删除操作时间复杂度为 O(1),就不能采用遍历的方式找到某个节点。HashMap 存储着 Key 到节点的映射,通过 Key 就能以 O(1) 的时间得到节点,然后再以 O(1) 的时间将其从双向队列中删除。
+Java 的 LinkedHashMap 内部就是这种结构,把 accessOrder 设为 true 并重写 removeEldestEntry 方法,就可以直接得到一个 LRU 缓存。
+
```java
public class LRU implements Iterable {