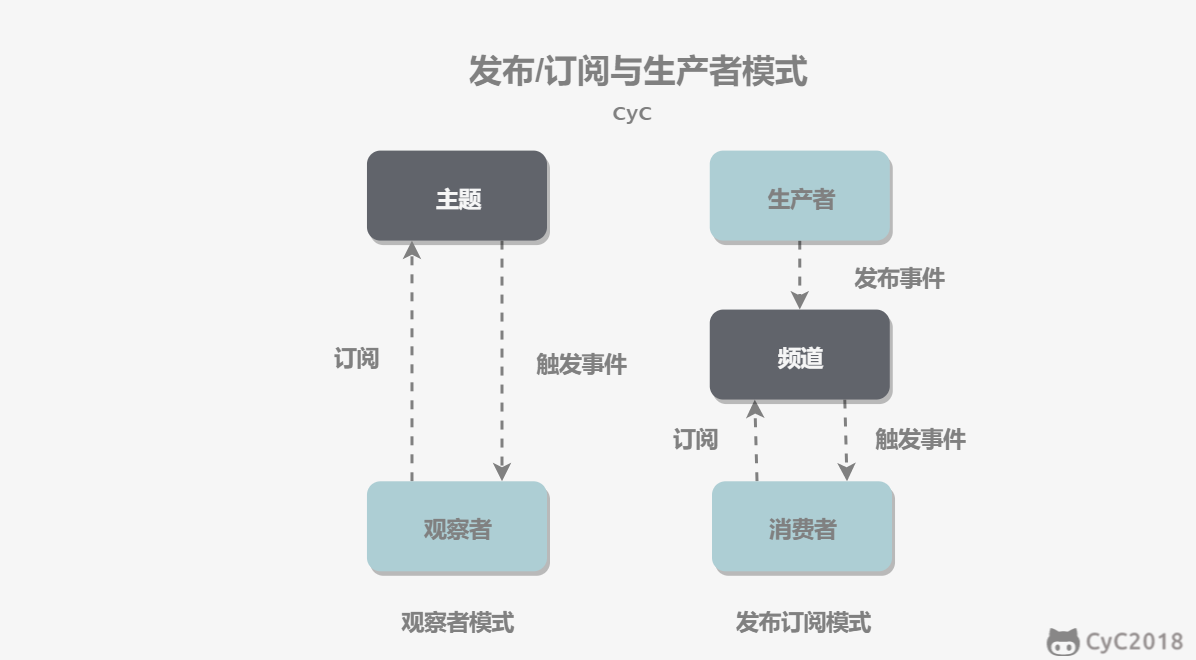
diff --git a/notes/pics/mq-observer-vs-pubsub.png b/notes/pics/mq-observer-vs-pubsub.png
new file mode 100644
index 00000000..68b811a0
Binary files /dev/null and b/notes/pics/mq-observer-vs-pubsub.png differ
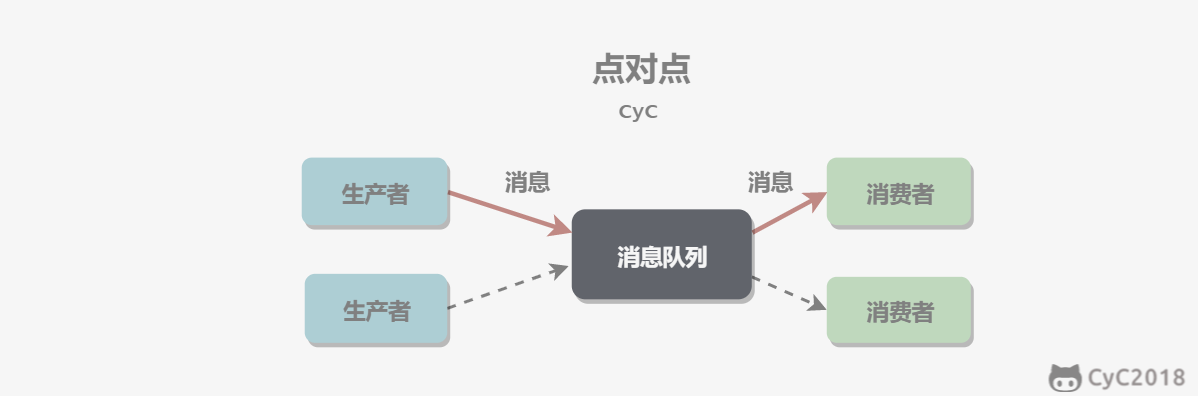
diff --git a/notes/pics/mq-p2p.png b/notes/pics/mq-p2p.png
new file mode 100644
index 00000000..0e50b9c3
Binary files /dev/null and b/notes/pics/mq-p2p.png differ
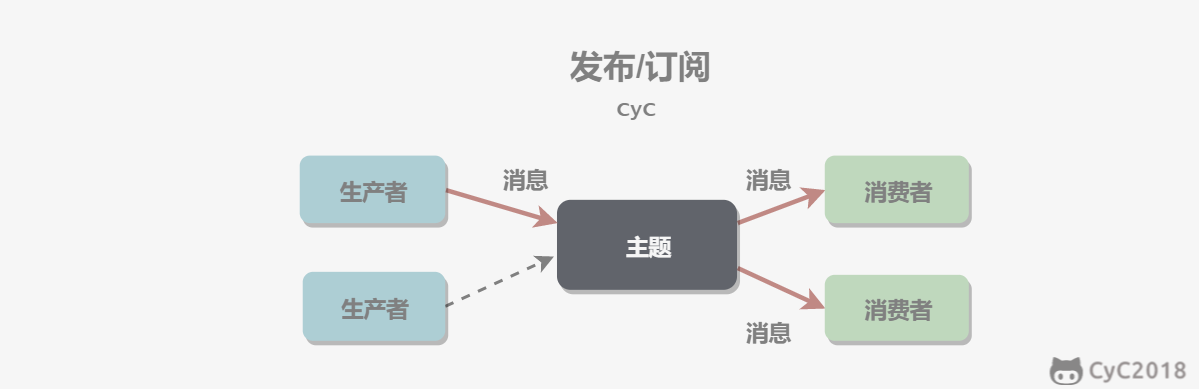
diff --git a/notes/pics/mq-pubsub.png b/notes/pics/mq-pubsub.png
new file mode 100644
index 00000000..bb208927
Binary files /dev/null and b/notes/pics/mq-pubsub.png differ
diff --git a/notes/消息队列.md b/notes/消息队列.md
index a2b2122a..a8cbf167 100644
--- a/notes/消息队列.md
+++ b/notes/消息队列.md
@@ -22,6 +22,7 @@
* [存储](#存储)
* [为什么吞吐量高](#为什么吞吐量高)
* [副本与可靠性](#副本与可靠性)
+ * [附录:实测](#附录实测)
* [参考资料](#参考资料)
@@ -32,13 +33,13 @@
消息生产者向消息队列中发送了一个消息之后,只能被一个消费者消费一次。
-
+
### 发布/订阅
消息生产者向频道发送一个消息之后,多个消费者可以从该频道订阅到这条消息并消费。
-
+
Kafka、RocketMQ 等通过消费者组把两种模型结合起来:一条消息会发送给每个订阅它的消费者组,但在一个消费者组内只会被一个消费者消费。
@@ -46,10 +47,10 @@ Kafka、RocketMQ 等通过消费者组把两种模型结合起来:一条消息
发布与订阅模式和观察者模式有以下不同:
-- 观察者模式中,观察者和主题都知道对方的存在;而在发布与订阅模式中,生产者与消费者不知道对方的存在,它们之间通过频道进行通信。
+- 观察者模式中,观察者和主题都知道对方的存在;而在发布与订阅模式中,生产者与消费者不知道对方的存在,它们之间通过频道进行通信;
- 观察者模式是同步的,当事件触发时,主题会调用观察者的方法,然后等待方法返回;而发布与订阅模式是异步的,生产者向频道发送一个消息之后,就不需要关心消费者何时去订阅这个消息,可以立即返回。
-
+
## 二、使用场景
@@ -85,7 +86,7 @@ Kafka、RocketMQ 等通过消费者组把两种模型结合起来:一条消息
实现方法:在本地数据库建一张消息表,将消息数据与业务数据保存在同一数据库实例里,这样就可以利用本地数据库的事务机制。事务提交成功后,将消息表中的消息转移到消息队列中,若转移消息成功则删除消息表中的数据,否则继续重传。
-消息队列在持久化消息之后才向发送端返回确认,发送端没有收到确认就进行重传。
+消息队列把消息可靠地保存之后才向发送端返回确认,发送端没有收到确认就进行重传。这里的“保存”不一定是刷盘,例如 Kafka 中是写入了足够多的副本,见下文的[副本与可靠性](#副本与可靠性)。
### 消息队列的可靠性
@@ -97,7 +98,7 @@ Kafka、RocketMQ 等通过消费者组把两种模型结合起来:一条消息
接收端在处理完成之后才向消息队列确认,处理过程中崩溃的话消息会被重新投递,因此一条消息可能被重复消费,需要做到:
-- 保证接收端处理消息的业务逻辑具有幂等性:只要具有幂等性,那么消费多少次消息,最后处理的结果都是一样的。
+- 保证接收端处理消息的业务逻辑具有幂等性:只要具有幂等性,那么消费多少次消息,最后处理的结果都是一样的;
- 保证消息具有唯一编号,并使用一张日志表来记录已经消费的消息编号。
## 四、顺序性
@@ -165,7 +166,7 @@ Kafka 中的消息按主题(Topic)分类,每个主题分成多个分区(
### 存储
-每个分区在磁盘上是一个目录,日志按大小切分成多个段(Segment),文件名是段中第一条消息的偏移量。本机把段的大小设为 1 MB(默认 1 GB),向一个只有一个分区的主题写入 3 万条 100 字节的消息后,目录中的文件和大小如下(省略了 .timeindex 等文件):
+每个分区在磁盘上是一个目录,日志按大小切分成多个段(Segment),文件名是段中第一条消息的偏移量。例如把段的大小设为 1 MB(默认 1 GB),向一个只有一个分区的主题写入 3 万条 100 字节的消息后,目录中的文件和大小如下(Kafka 4.4 实测,省略了 .timeindex 等文件):
```text
00000000000000000000.log 1041728
@@ -192,9 +193,9 @@ Kafka 中的消息按主题(Topic)分类,每个主题分成多个分区(
顺序写和页缓存:消息只追加到日志的末尾,是顺序写,比随机写快得多。写入时只写到操作系统的页缓存,由操作系统决定何时刷盘,消费者读取刚写入不久的数据时也通常直接命中页缓存。可靠性不依靠每条消息都刷盘,而是依靠多个副本。
-批量:生产者把发往同一个分区的消息攒成批次再发送,批次在网络传输、写入日志和副本复制时都作为一个整体处理,压缩也以批次为单位。在本机 3 个节点的集群上用 kafka-producer-perf-test.sh 发送 2 万条 100 字节的消息(acks=all),各运行 3 次:默认配置每秒约 5.7 万~6.8 万条,平均延迟 21~54 ms;设置 batch.size=0 关闭批量后,每秒只有约 6500~6800 条,发送的请求大量排队,平均延迟约 1.4 秒。
+批量:生产者把发往同一个分区的消息攒成批次再发送,批次在网络传输、写入日志和副本复制时都作为一个整体处理,压缩也以批次为单位。例如在 3 个节点的集群上发送 2 万条 100 字节的消息(acks=all),默认配置每秒约 5.7 万~6.8 万条,平均延迟 21~54 ms;设置 batch.size=0(linger.ms=0)关闭批量后,每秒只有约 6500~6800 条,发送的请求大量排队,平均延迟约 1.4 秒(Kafka 4.4 实测,见[附录:实测](#附录实测))。
-零拷贝:broker 把日志发给消费者时使用 sendfile 系统调用,数据不需要先读到用户空间再写回内核:
+零拷贝:broker 把日志发给消费者时使用 sendfile 系统调用,数据不需要先读到用户空间再写回内核(启用 SSL 时数据要在用户空间加密,不能使用 sendfile):
@@ -204,7 +205,7 @@ Kafka 中的消息按主题(Topic)分类,每个主题分成多个分区(
每个分区有多个副本,分布在不同的 broker 上,其中一个是 Leader,负责处理读写,其余的 Follower 不断从 Leader 拉取数据。与 Leader 保持同步的副本集合称为 ISR(In-Sync Replicas),Follower 超过 replica.lag.time.max.ms(默认 30 秒)没有追上 Leader 就会被移出 ISR。Kafka 4.0 起完全移除了 ZooKeeper,Leader 选举等元数据由内置的 KRaft 控制器管理,它基于 Raft 协议实现。
-本机创建 3 个分区、3 个副本的主题,然后用 kill -9 停掉 broker 3:
+例如创建 3 个分区、3 个副本的主题,然后用 kill -9 停掉 broker 3(3 个节点的 KRaft 集群实测):
```text
停止前
@@ -229,11 +230,45 @@ acks=all 要配合 min.insync.replicas 使用,否则 ISR 只剩 Leader 一个
生产者没有收到确认就会重试,这可能让同一条消息写入两次。Kafka 3.0 起默认开启幂等生产者:broker 给每个生产者分配一个 ID,生产者给发往每个分区的消息编上序号,broker 发现序号重复就丢弃。前面查看 .log 文件时,每个批次都带有 producerId: 1001 和 baseSequence 字段。幂等只保证单个分区内不重复;要让写入多个分区的消息同时成功或失败,需要使用事务,消费者设置 isolation.level=read_committed 后只读取已提交事务中的消息。
-消费者处理完消息后提交偏移量,下次从提交的位置继续读取。默认每 5 秒自动提交一次,已经处理但还没提交时崩溃,重启后就会重复消费。本机实验中,消费者读到 3 条扣款消息后被 kill -9,这时组的偏移量仍然为空;它在 session.timeout.ms(默认 45 秒)之后被移出消费者组,重新启动的消费者又收到了这 3 条消息。因此接收端必须做到幂等,方法见 [接收端的可靠性](#接收端的可靠性)。反过来,如果先提交偏移量再处理,处理失败的消息就丢失了。
+消费者处理完消息后提交偏移量,下次从提交的位置继续读取。默认每 5 秒自动提交一次,已经处理但还没提交时崩溃,重启后就会重复消费。例如消费者读到 3 条扣款消息后被 kill -9,这时组的偏移量仍然为空;它在 session.timeout.ms(默认 45 秒)之后被移出消费者组,重新启动的消费者又收到了这 3 条消息(见[附录:实测](#附录实测))。因此接收端必须做到幂等,方法见 [接收端的可靠性](#接收端的可靠性)。反过来,如果先提交偏移量再处理,处理失败的消息就丢失了。
+
+## 附录:实测
+
+环境为 Apple M1 Pro、macOS,Kafka 4.4.0 的 3 个节点的 KRaft 集群运行在同一台机器上(端口 9091~9093,命令中的 $B 为这三个地址)。
+
+批量对吞吐量的影响:主题有 3 个分区、3 个副本,每种配置运行 3 次:
+
+```text
+$ kafka-topics.sh --bootstrap-server $B --create --topic perf --partitions 3 --replication-factor 3
+$ kafka-producer-perf-test.sh --topic perf --num-records 20000 --record-size 100 --throughput -1 \
+ --command-property bootstrap.servers=$B acks=all
+20000 records sent, 64724.919094 records/sec (6.17 MB/sec), 35.14 ms avg latency, 186.00 ms max latency
+20000 records sent, 56980.056980 records/sec (5.43 MB/sec), 53.59 ms avg latency, 184.00 ms max latency
+20000 records sent, 68493.150685 records/sec (6.53 MB/sec), 21.34 ms avg latency, 190.00 ms max latency
+
+$ ...(同上) acks=all batch.size=0 linger.ms=0
+20000 records sent, 6459.948320 records/sec (0.62 MB/sec), 1446.62 ms avg latency, 2773.00 ms max latency
+20000 records sent, 6704.659739 records/sec (0.64 MB/sec), 1397.86 ms avg latency, 2674.00 ms max latency
+20000 records sent, 6795.786612 records/sec (0.65 MB/sec), 1410.16 ms avg latency, 2648.00 ms max latency
+```
+
+重复消费:消费者组 billing 使用默认的自动提交,读到 3 条消息后立即 kill -9,45 秒后再启动一个同组的消费者:
+
+```text
+第一个消费者:
+扣款 order:1024
+扣款 order:1025
+扣款 order:1026
+(kill -9)
+重新启动的消费者:
+扣款 order:1024
+扣款 order:1025
+扣款 order:1026
+Processed a total of 3 messages
+```
## 参考资料
-- [Observer vs Pub-Sub](http://developers-club.com/posts/270339/)
- [Designing Data-Intensive Applications 中文版](https://github.com/vonng/ddia)
- [消息队列中点对点与发布订阅区别](https://web.archive.org/web/20250522024511/https://blog.csdn.net/lizhitao/article/details/47723105)
- [定时/延时消息 | RocketMQ](https://rocketmq.apache.org/zh/docs/featureBehavior/02delaymessage/)