diff --git a/notes/算法 - 排序.md b/notes/算法 - 排序.md
index ed678c5a..8c54bbe8 100644
--- a/notes/算法 - 排序.md
+++ b/notes/算法 - 排序.md
@@ -307,15 +307,15 @@ private int partition(T[] nums, int l, int h) {
### 4. 算法改进
-##### 4.1 切换到插入排序
+#### 4.1 切换到插入排序
因为快速排序在小数组中也会递归调用自己,对于小数组,插入排序比快速排序的性能更好,因此在小数组中可以切换到插入排序。
-##### 4.2 三数取中
+#### 4.2 三数取中
最好的情况下是每次都能取数组的中位数作为切分元素,但是计算中位数的代价很高。一种折中方法是取 3 个元素,并将大小居中的元素作为切分元素。
-##### 4.3 三向切分
+#### 4.3 三向切分
对于有大量重复元素的数组,可以将数组切分为三部分,分别对应小于、等于和大于切分元素。
@@ -487,13 +487,13 @@ public T delMax() {
把最大元素和当前堆中数组的最后一个元素交换位置,并且不删除它,那么就可以得到一个从尾到头的递减序列,从正向来看就是一个递增序列,这就是堆排序。
-##### 5.1 构建堆
+#### 5.1 构建堆
无序数组建立堆最直接的方法是从左到右遍历数组进行上浮操作。一个更高效的方法是从右至左进行下沉操作,如果一个节点的两个子节点都已经是堆有序,那么进行下沉操作可以使得这个节点为根节点的堆有序。叶子节点不需要进行下沉操作,可以忽略叶子节点的元素,因此只需要遍历一半的元素即可。这种方法建堆是线性的:约 1/4 的节点最多下沉 1 层,1/8 的节点最多下沉 2 层……总层数不超过 N,每层比较 2 次,共少于 2N 次比较(10 万个随机元素约 18.8 万次,JDK 21 实测,见附录 A2)。
-##### 5.2 交换堆顶元素与最后一个元素
+#### 5.2 交换堆顶元素与最后一个元素
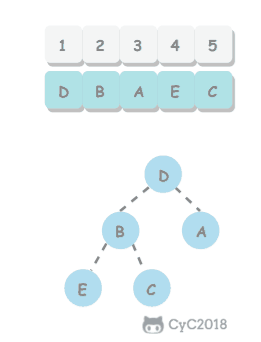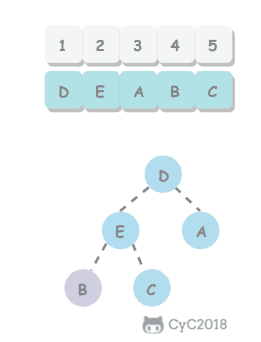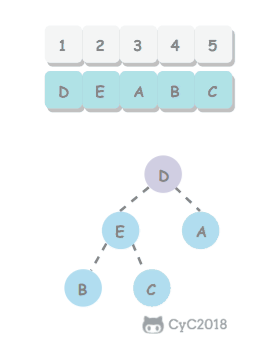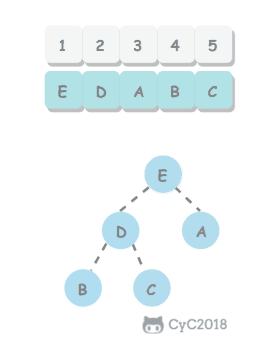
交换之后需要进行下沉操作维持堆的有序状态。