diff --git a/notes/消息队列.md b/notes/消息队列.md
index 60507bc9..9fb85cc0 100644
--- a/notes/消息队列.md
+++ b/notes/消息队列.md
@@ -6,11 +6,14 @@
* [发布/订阅](#发布订阅)
* [二、使用场景](#二使用场景)
* [异步处理](#异步处理)
- * [流量削锋](#流量削锋)
+ * [流量削峰](#流量削峰)
* [应用解耦](#应用解耦)
* [三、可靠性](#三可靠性)
* [发送端的可靠性](#发送端的可靠性)
+ * [消息队列的可靠性](#消息队列的可靠性)
* [接收端的可靠性](#接收端的可靠性)
+ * [四、顺序性](#四顺序性)
+ * [五、消息堆积](#五消息堆积)
* [参考资料](#参考资料)
@@ -29,6 +32,8 @@
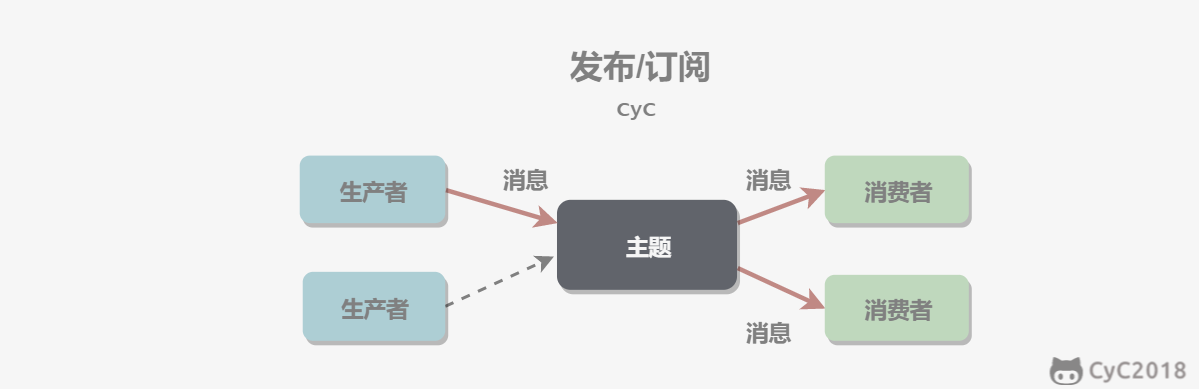
+Kafka、RocketMQ 等通过消费者组把两种模型结合起来:一条消息会发送给每个订阅它的消费者组,但在一个消费者组内只会被一个消费者消费。
+
发布与订阅模式和观察者模式有以下不同:
- 观察者模式中,观察者和主题都知道对方的存在;而在发布与订阅模式中,生产者与消费者不知道对方的存在,它们之间通过频道进行通信。
@@ -46,7 +51,7 @@
只有在业务流程允许异步处理的情况下才能这么做,例如上面的注册流程中,如果要求用户对验证邮件进行点击之后才能完成注册的话,就不能再使用消息队列。
-### 流量削锋
+### 流量削峰
在高并发的场景下,如果短时间有大量的请求到达会压垮服务器。
@@ -58,23 +63,45 @@
通过使用消息队列,一个模块只需要向消息队列中发送消息,其它模块可以选择性地从消息队列中订阅消息从而完成调用。
+引入消息队列的代价是系统多了一个需要保证高可用的组件,并且需要处理下面的可靠性和顺序性问题。
+
## 三、可靠性
+一条消息要经过发送、存储、消费三个环节,每个环节都可能丢失消息。
+
### 发送端的可靠性
发送端完成操作后一定能将消息成功发送到消息队列中。
实现方法:在本地数据库建一张消息表,将消息数据与业务数据保存在同一数据库实例里,这样就可以利用本地数据库的事务机制。事务提交成功后,将消息表中的消息转移到消息队列中,若转移消息成功则删除消息表中的数据,否则继续重传。
+消息队列在持久化消息之后才向发送端返回确认,发送端没有收到确认就进行重传。
+
+### 消息队列的可靠性
+
+消息队列收到消息后需要持久化到磁盘,并复制到多个副本上,避免单个节点宕机导致消息丢失。
+
### 接收端的可靠性
接收端能够从消息队列成功消费一次消息。
-两种实现方法:
+接收端在处理完成之后才向消息队列确认,处理过程中崩溃的话消息会被重新投递,因此一条消息可能被重复消费,需要做到:
- 保证接收端处理消息的业务逻辑具有幂等性:只要具有幂等性,那么消费多少次消息,最后处理的结果都是一样的。
- 保证消息具有唯一编号,并使用一张日志表来记录已经消费的消息编号。
+## 四、顺序性
+
+消息队列通常只保证单个队列(Kafka 中的分区)内的消息有序,多个队列之间没有顺序保证。
+
+要保证同一业务的消息有序,需要让发送端把这些消息按业务 Key(例如订单号)路由到同一个队列,并且接收端对同一个队列只用一个线程顺序消费。
+
+## 五、消息堆积
+
+消费速度长期低于生产速度时,消息会在队列中堆积。
+
+解决方法是增加消费者数量来提高消费能力,但是消费者数量超过队列(分区)数量之后就不再有效,需要同时增加队列数量。
+
## 参考资料
- [Observer vs Pub-Sub](http://developers-club.com/posts/270339/)