diff --git a/notes/pics/arp-hops.png b/notes/pics/arp-hops.png
new file mode 100644
index 00000000..a8e34915
Binary files /dev/null and b/notes/pics/arp-hops.png differ
diff --git a/notes/pics/arp-request.png b/notes/pics/arp-request.png
new file mode 100644
index 00000000..0d5c0d7e
Binary files /dev/null and b/notes/pics/arp-request.png differ
diff --git a/notes/pics/bgp.png b/notes/pics/bgp.png
new file mode 100644
index 00000000..1d6184f9
Binary files /dev/null and b/notes/pics/bgp.png differ
diff --git a/notes/pics/icmp-format.png b/notes/pics/icmp-format.png
new file mode 100644
index 00000000..9fb7e298
Binary files /dev/null and b/notes/pics/icmp-format.png differ
diff --git a/notes/pics/ip-classes.png b/notes/pics/ip-classes.png
new file mode 100644
index 00000000..3549c71b
Binary files /dev/null and b/notes/pics/ip-classes.png differ
diff --git a/notes/pics/ip-fragment.png b/notes/pics/ip-fragment.png
new file mode 100644
index 00000000..73788040
Binary files /dev/null and b/notes/pics/ip-fragment.png differ
diff --git a/notes/pics/ip-header.png b/notes/pics/ip-header.png
new file mode 100644
index 00000000..5a239cf4
Binary files /dev/null and b/notes/pics/ip-header.png differ
diff --git a/notes/pics/nat.png b/notes/pics/nat.png
new file mode 100644
index 00000000..fff6f366
Binary files /dev/null and b/notes/pics/nat.png differ
diff --git a/notes/pics/route-lookup.png b/notes/pics/route-lookup.png
new file mode 100644
index 00000000..89e8f191
Binary files /dev/null and b/notes/pics/route-lookup.png differ
diff --git a/notes/pics/router-structure.png b/notes/pics/router-structure.png
new file mode 100644
index 00000000..dd8ecac2
Binary files /dev/null and b/notes/pics/router-structure.png differ
diff --git a/notes/pics/tcp-cwnd.png b/notes/pics/tcp-cwnd.png
new file mode 100644
index 00000000..90dcb13a
Binary files /dev/null and b/notes/pics/tcp-cwnd.png differ
diff --git a/notes/pics/tcp-fast-retransmit.png b/notes/pics/tcp-fast-retransmit.png
new file mode 100644
index 00000000..0007f464
Binary files /dev/null and b/notes/pics/tcp-fast-retransmit.png differ
diff --git a/notes/pics/tcp-flow-vs-congestion.png b/notes/pics/tcp-flow-vs-congestion.png
new file mode 100644
index 00000000..7d82af7d
Binary files /dev/null and b/notes/pics/tcp-flow-vs-congestion.png differ
diff --git a/notes/pics/tcp-handshake.png b/notes/pics/tcp-handshake.png
new file mode 100644
index 00000000..3a608d65
Binary files /dev/null and b/notes/pics/tcp-handshake.png differ
diff --git a/notes/pics/tcp-header.png b/notes/pics/tcp-header.png
new file mode 100644
index 00000000..82244d03
Binary files /dev/null and b/notes/pics/tcp-header.png differ
diff --git a/notes/pics/tcp-sliding-window.png b/notes/pics/tcp-sliding-window.png
new file mode 100644
index 00000000..10c7c973
Binary files /dev/null and b/notes/pics/tcp-sliding-window.png differ
diff --git a/notes/pics/tcp-sticky.png b/notes/pics/tcp-sticky.png
new file mode 100644
index 00000000..1584d5b1
Binary files /dev/null and b/notes/pics/tcp-sticky.png differ
diff --git a/notes/pics/tcp-teardown.png b/notes/pics/tcp-teardown.png
new file mode 100644
index 00000000..897070b2
Binary files /dev/null and b/notes/pics/tcp-teardown.png differ
diff --git a/notes/pics/udp-header.png b/notes/pics/udp-header.png
new file mode 100644
index 00000000..a8a18882
Binary files /dev/null and b/notes/pics/udp-header.png differ
diff --git a/notes/pics/vpn-tunnel.png b/notes/pics/vpn-tunnel.png
new file mode 100644
index 00000000..a5252a9d
Binary files /dev/null and b/notes/pics/vpn-tunnel.png differ
diff --git a/notes/计算机网络 - 传输层.md b/notes/计算机网络 - 传输层.md
index 935d5c16..ad344187 100644
--- a/notes/计算机网络 - 传输层.md
+++ b/notes/计算机网络 - 传输层.md
@@ -12,6 +12,7 @@
* [TCP 拥塞控制](#tcp-拥塞控制)
* [1. 慢开始与拥塞避免](#1-慢开始与拥塞避免)
* [2. 快重传与快恢复](#2-快重传与快恢复)
+ * [TCP 粘包与拆包](#tcp-粘包与拆包)
@@ -25,13 +26,13 @@
## UDP 首部格式
-
+
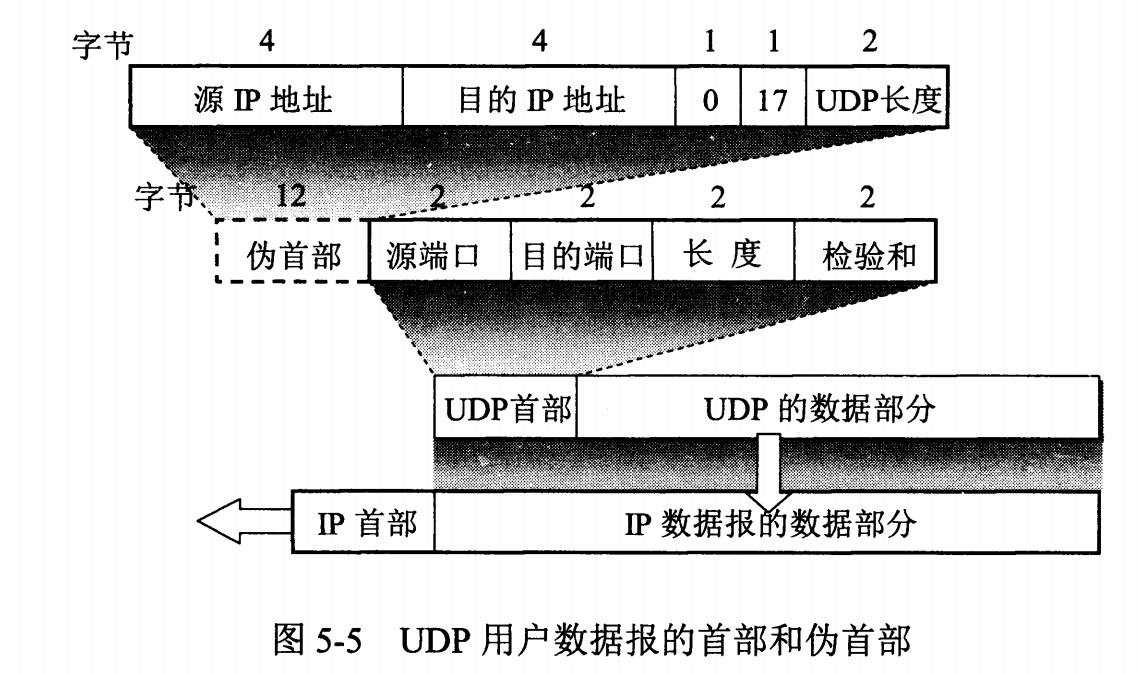
首部字段只有 8 个字节,包括源端口、目的端口、长度、检验和。12 字节的伪首部是为了计算检验和临时添加的。
## TCP 首部格式
-
+
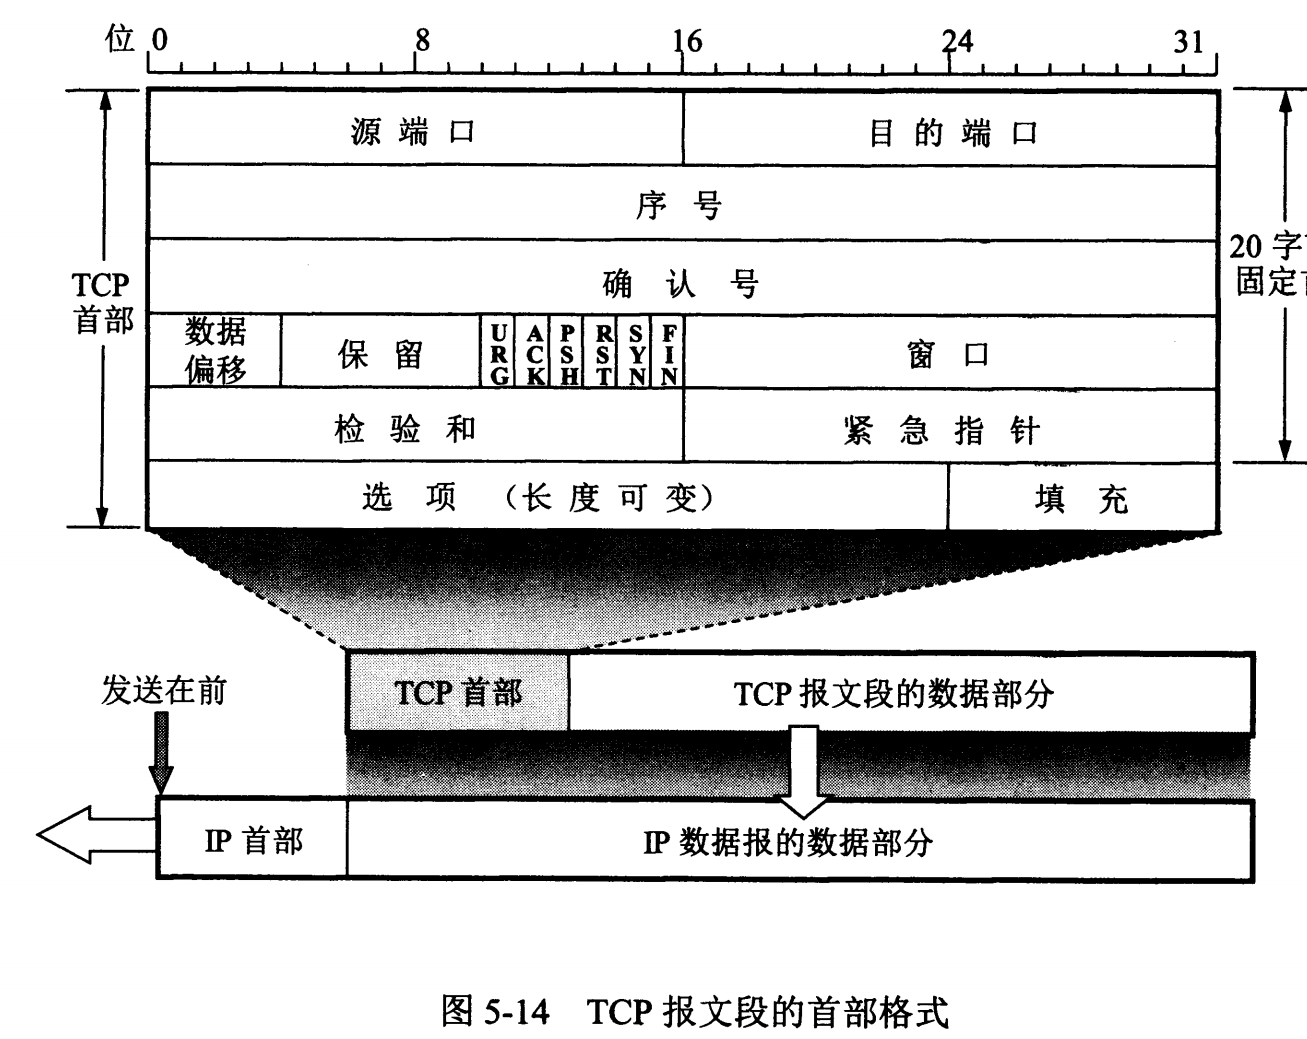
- **序号** :用于对字节流进行编号,例如序号为 301,表示第一个字节的编号为 301,如果携带的数据长度为 100 字节,那么下一个报文段的序号应为 401。
@@ -49,7 +50,7 @@
## TCP 的三次握手
-
+
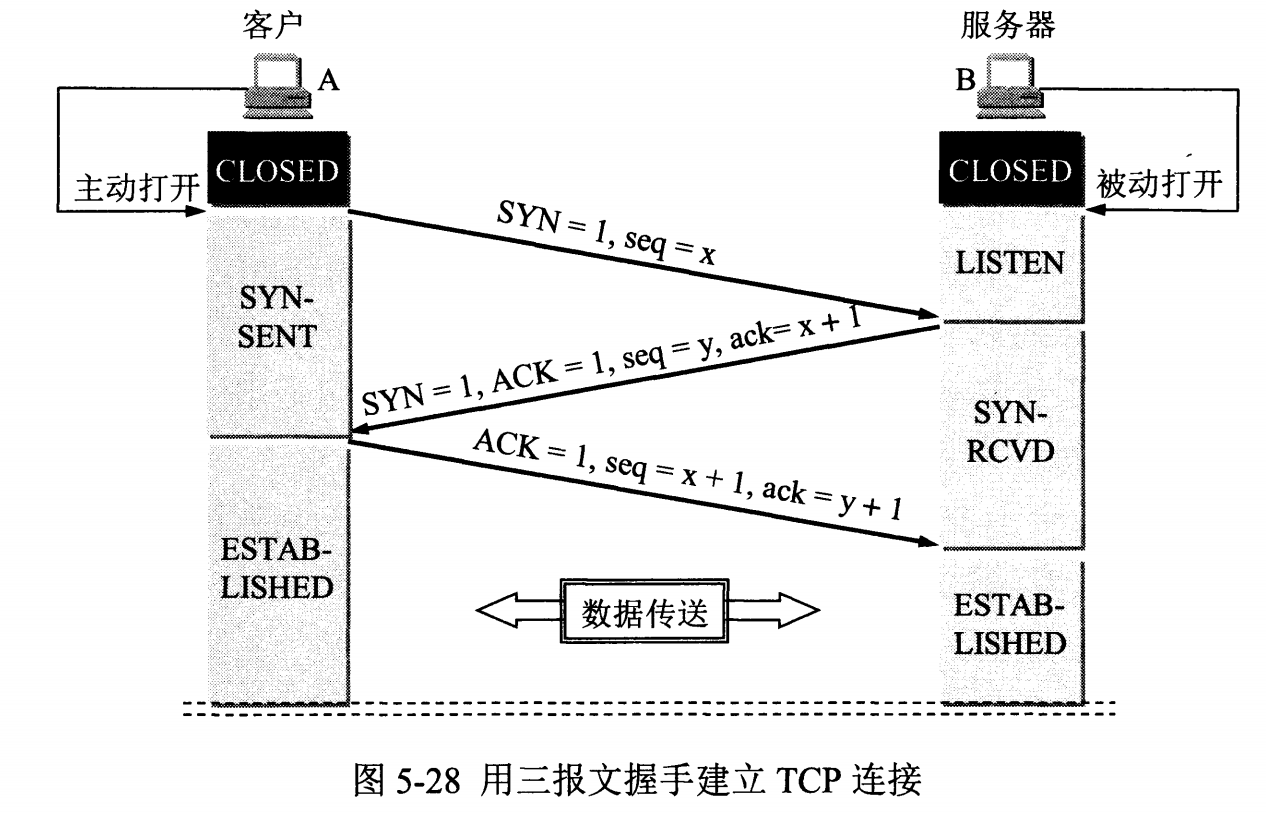
假设 A 为客户端,B 为服务器端。
@@ -67,11 +68,11 @@
第三次握手是为了防止失效的连接请求到达服务器,让服务器错误打开连接。
-客户端发送的连接请求如果在网络中滞留,那么就会隔很长一段时间才能收到服务器端发回的连接确认。客户端等待一个超时重传时间之后,就会重新请求连接。但是这个滞留的连接请求最后还是会到达服务器,如果不进行三次握手,那么服务器就会打开两个连接。如果有第三次握手,客户端会忽略服务器之后发送的对滞留连接请求的连接确认,不进行第三次握手,因此就不会再次打开连接。
+客户端发送的连接请求如果在网络中滞留,那么就会隔很长一段时间才能收到服务器端发回的连接确认。客户端等待一个超时重传时间之后,就会重新请求连接。但是这个滞留的连接请求最后还是会到达服务器,如果不进行三次握手,那么服务器就会打开两个连接。有了第三次握手,客户端收到服务器对滞留请求的确认时,发现确认号不是自己期望的,就回复 RST,服务器收到后放弃这个连接,不会多打开一个连接。
## TCP 的四次挥手
-
+
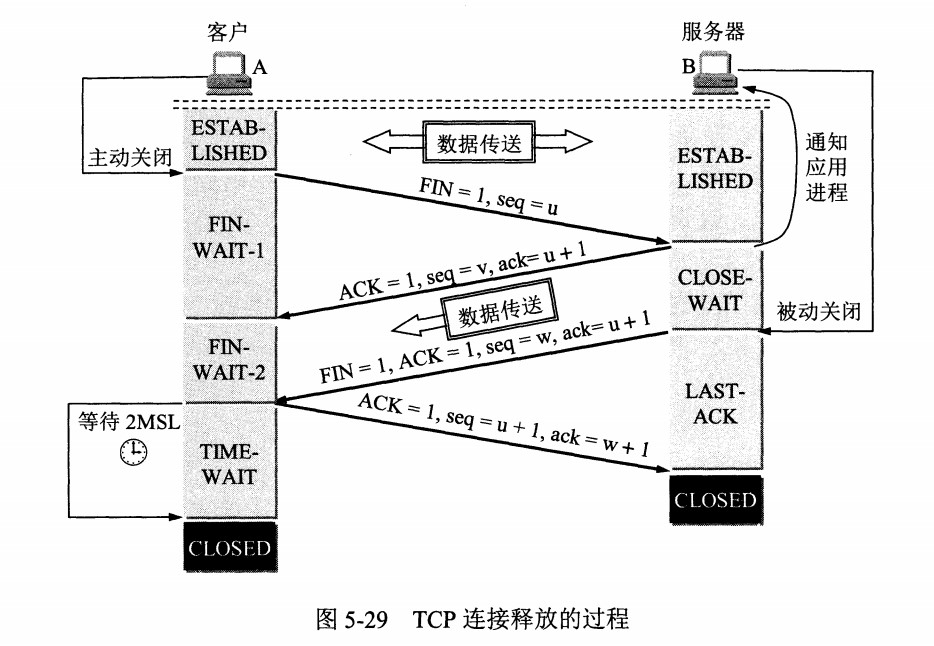
以下描述不讨论序号和确认号,因为序号和确认号的规则比较简单。并且不讨论 ACK,因为 ACK 在连接建立之后都为 1。
@@ -97,19 +98,41 @@
- 等待一段时间是为了让本连接持续时间内所产生的所有报文都从网络中消失,使得下一个新的连接不会出现旧的连接请求报文。
+2MSL 正好覆盖一个来回:A 的确认最多在网络中存活 1 MSL,B 超时重传的 FIN 最多再存活 1 MSL。Linux 中 TIME_WAIT 固定为 60 秒(TCP_TIMEWAIT_LEN)。
+
+**大量 TIME_WAIT 与 CLOSE_WAIT**
+
+TIME_WAIT 出现在主动关闭的一方,使用短连接的机器会积累大量 TIME_WAIT,例如每次请求都新建连接去访问下游服务。每个 TIME_WAIT 连接占用一个本地端口 60 秒,Linux 默认的本地端口范围是 32768~60999,共 28232 个,连接同一个目标地址和端口时,每秒新建超过约 470 个连接就会耗尽端口。
+
+解决方案:
+
+- 使用长连接或连接池,例如 HTTP 的 keep-alive、数据库连接池;
+- 在发起连接的一方开启 net.ipv4.tcp_tw_reuse,允许新连接复用处于 TIME_WAIT 的端口,它依靠 TCP 时间戳选项识别旧连接的报文;
+- 扩大本地端口范围 net.ipv4.ip_local_port_range。
+
+另一个参数 tcp_tw_recycle 在 NAT 环境下会丢弃正常的连接,Linux 4.12 已将其移除。
+
+CLOSE_WAIT 出现在被动关闭的一方,表示对方已经关闭,本方的应用还没有调用 close()。连接大量停在 CLOSE_WAIT 通常是程序的问题,例如异常分支没有关闭连接、从连接池借出的连接没有归还,需要排查代码,保证每个连接最终都会被关闭。
+
## TCP 可靠传输
TCP 使用超时重传来实现可靠传输:如果一个已经发送的报文段在超时时间内没有收到确认,那么就重传这个报文段。
一个报文段从发送再到接收到确认所经过的时间称为往返时间 RTT,加权平均往返时间 RTTs 计算如下:
-
+```text
+RTTs = (1 - a) × RTTs + a × RTT
+```
+
其中,0 ≤ a < 1,RTTs 随着 a 的增加更容易受到 RTT 的影响。
超时时间 RTO 应该略大于 RTTs,TCP 使用的超时时间计算如下:
-
-其中 RTTd 为偏差的加权平均值。
+```text
+RTO = RTTs + 4 × RTTd
+```
+
+其中 RTTd 为偏差的加权平均值。RFC 6298 建议 a 取 1/8,计算 RTTd 时的权重取 1/4,并要求 RTO 不小于 1 秒;Linux 的下限为 200 ms。
## TCP 滑动窗口
@@ -117,9 +140,9 @@ TCP 使用超时重传来实现可靠传输:如果一个已经发送的报文
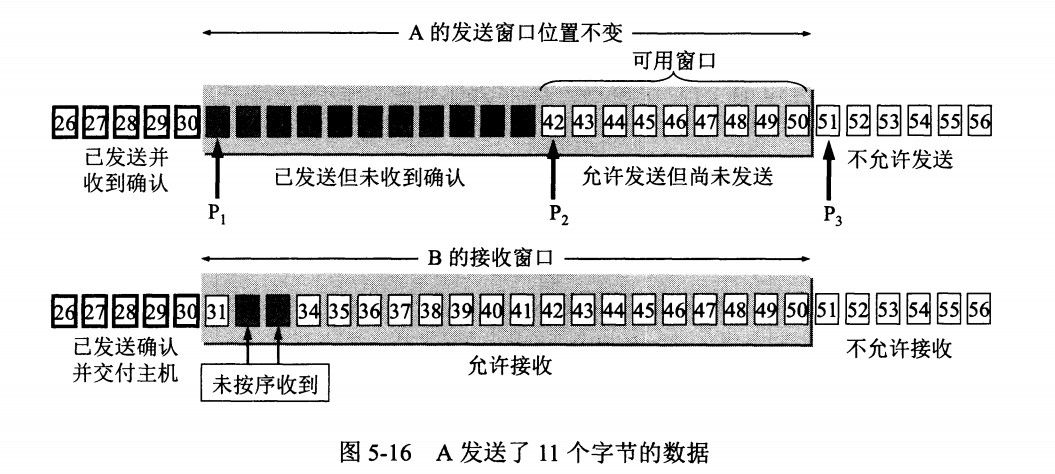
发送窗口内的字节都允许被发送,接收窗口内的字节都允许被接收。如果发送窗口左部的字节已经发送并且收到了确认,那么就将发送窗口向右滑动一定距离,直到左部第一个字节不是已发送并且已确认的状态;接收窗口的滑动类似,接收窗口左部字节已经发送确认并交付主机,就向右滑动接收窗口。
-接收窗口只会对窗口内最后一个按序到达的字节进行确认,例如接收窗口已经收到的字节为 {31, 34, 35},其中 {31} 按序到达,而 {34, 35} 就不是,因此只对字节 31 进行确认。发送方得到一个字节的确认之后,就知道这个字节之前的所有字节都已经被接收。
+接收窗口只会对窗口内最后一个按序到达的字节进行确认,例如接收窗口已经收到的字节为 {31, 34, 35},其中 {31} 按序到达,而 {34, 35} 就不是,因此只对字节 31 进行确认,确认号为 32。发送方得到一个字节的确认之后,就知道这个字节之前的所有字节都已经被接收。
-
+
## TCP 流量控制
@@ -131,18 +154,18 @@ TCP 使用超时重传来实现可靠传输:如果一个已经发送的报文
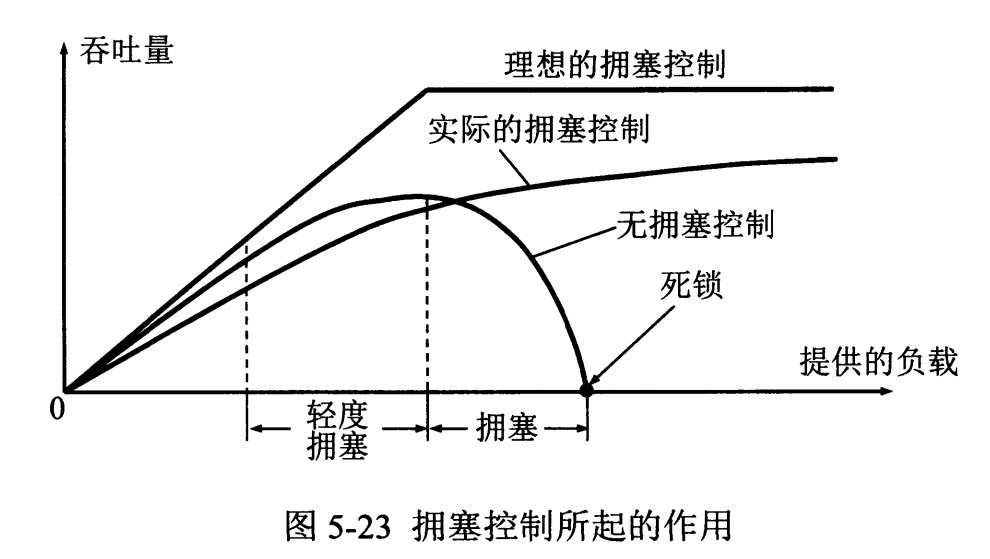
如果网络出现拥塞,分组将会丢失,此时发送方会继续重传,从而导致网络拥塞程度更高。因此当出现拥塞时,应当控制发送方的速率。这一点和流量控制很像,但是出发点不同。流量控制是为了让接收方能来得及接收,而拥塞控制是为了降低整个网络的拥塞程度。
-
+
TCP 主要通过四个算法来进行拥塞控制:慢开始、拥塞避免、快重传、快恢复。
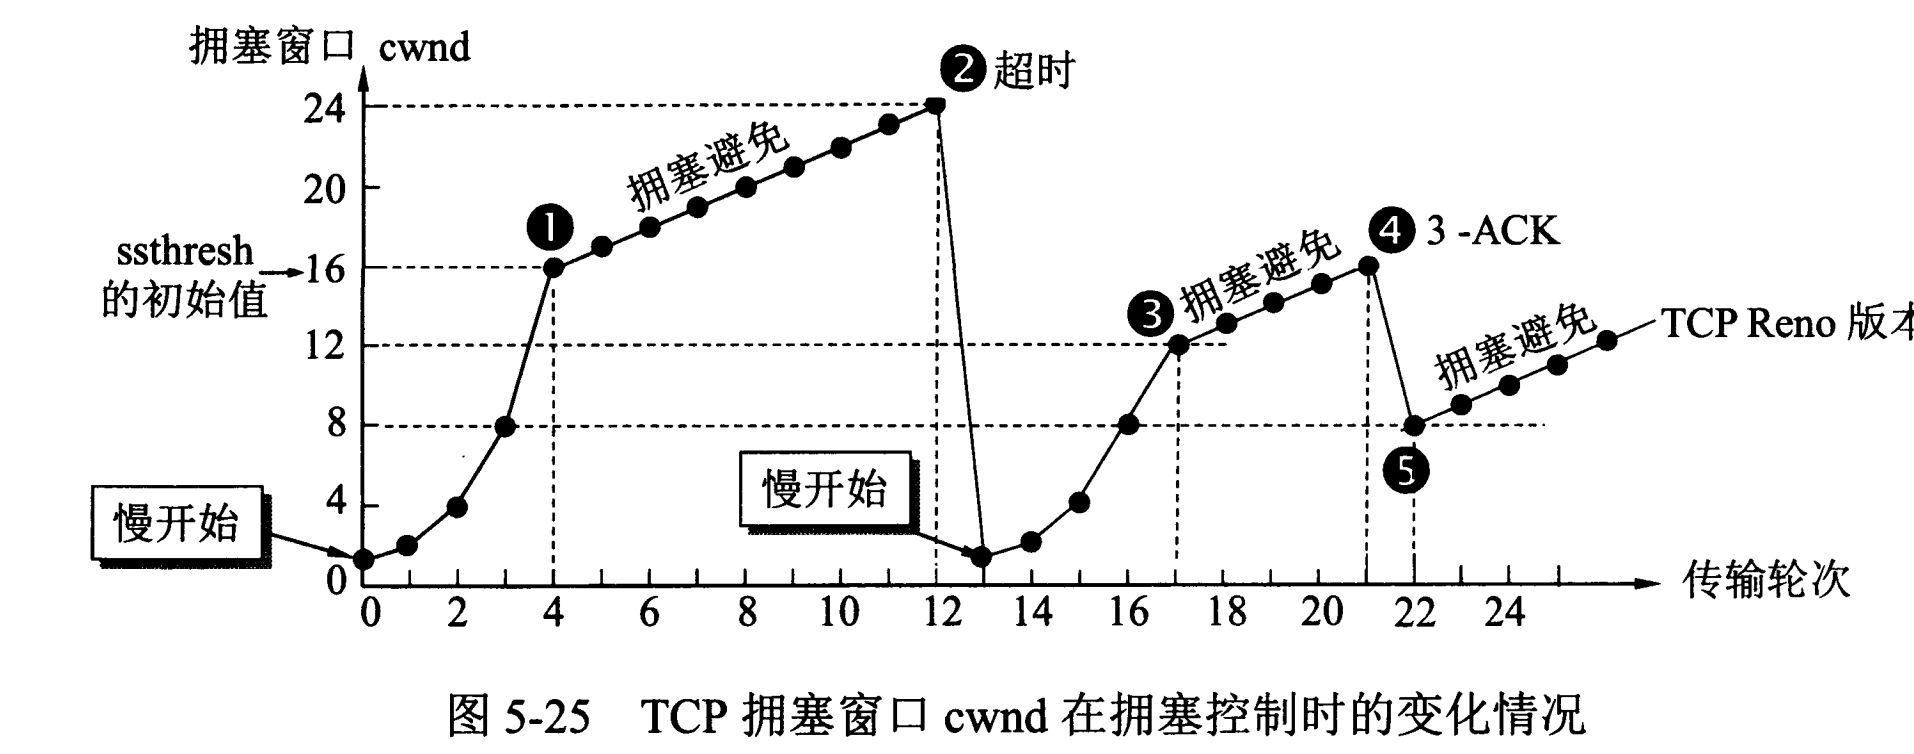
-发送方需要维护一个叫做拥塞窗口(cwnd)的状态变量,注意拥塞窗口与发送方窗口的区别:拥塞窗口只是一个状态变量,实际决定发送方能发送多少数据的是发送方窗口。
+发送方需要维护一个叫做拥塞窗口(cwnd)的状态变量,注意拥塞窗口与发送方窗口的区别:拥塞窗口只是一个状态变量,实际决定发送方能发送多少数据的是发送方窗口,它取拥塞窗口和接收方通告的窗口中的较小值。
为了便于讨论,做如下假设:
- 接收方有足够大的接收缓存,因此不会发生流量控制;
- 虽然 TCP 的窗口基于字节,但是这里设窗口的大小单位为报文段。
-
+
### 1. 慢开始与拥塞避免
@@ -164,4 +187,53 @@ TCP 主要通过四个算法来进行拥塞控制:慢开始、拥塞避免、
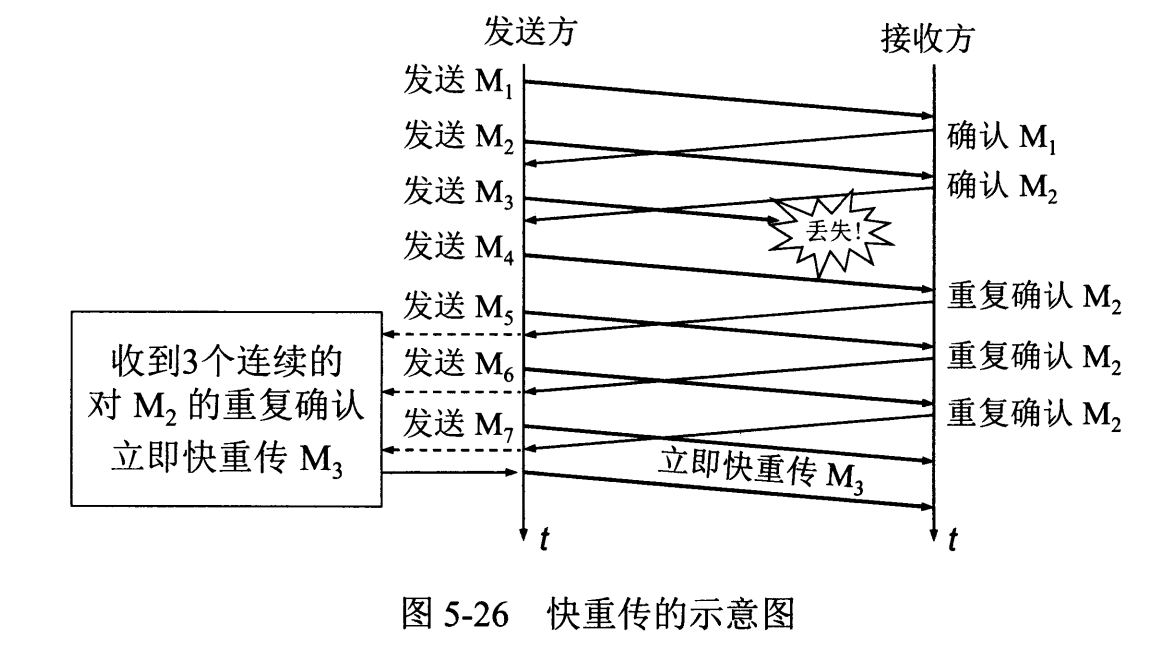
慢开始和快恢复的快慢指的是 cwnd 的设定值,而不是 cwnd 的增长速率。慢开始 cwnd 设定为 1,而快恢复 cwnd 设定为 ssthresh。
-
+
+
+## TCP 粘包与拆包
+
+TCP 面向字节流,只保证字节按顺序到达,不保留应用每次写入的边界。发送方写入两次,接收方的一次读取可能读到两条消息拼在一起,称为粘包;也可能只读到一条消息的一部分,称为拆包(也叫半包)。
+
+例如客户端依次写入 hello、world 和一条 200000 字节的消息,服务器等待 200 ms 后,用 1024 字节的缓冲区反复读取:
+
+
+
+产生的原因主要有以下几种:
+
+- 数据先进入接收缓冲区,应用读取时缓冲区里有多少就读出多少,最多读满自己的缓冲区;
+- 发送方的 Nagle 算法会把多次写入的小数据合并成一个报文段发送;
+- 超过最大报文段长度(Maximum Segment Size, MSS)的消息会被分成多个报文段,可能分多次读到。
+
+UDP 面向报文,一次读取得到的就是对方一次发送的完整数据报,不存在粘包。
+
+解决方法是在应用层约定消息的边界,常用以下三种:
+
+- 固定长度:每条消息长度相同,不足的部分补齐,浪费空间;
+- 分隔符:用特殊字符标记消息结束,例如 Redis 协议的每一行以 `\r\n` 结束,消息中出现分隔符时需要转义;
+- 长度字段:在消息头部写明消息体的长度,接收方先读长度,再读够这么多字节。
+
+HTTP/1.1 同时用了后两种:首部以一个空行结束,消息体的长度由 Content-Length 给出,或者用分块传输编码在每一块前写明长度。Netty 提供了对应的解码器 FixedLengthFrameDecoder、DelimiterBasedFrameDecoder 和 LengthFieldBasedFrameDecoder。
+
+用长度字段收发消息的最小实现如下,按这种格式重复上面的例子,接收方依次得到 hello、world 和 200000 字节的消息:
+
+```java
+static final int MAX = 1 << 20;
+
+static void send(DataOutputStream out, String msg) throws IOException {
+ byte[] body = msg.getBytes(StandardCharsets.UTF_8);
+ out.writeInt(body.length); // 4 字节的长度
+ out.write(body);
+ out.flush();
+}
+
+static String receive(DataInputStream in) throws IOException {
+ int len = in.readInt(); // 读满 4 字节
+ if (len < 0 || len > MAX) {
+ throw new IOException("bad length " + len);
+ }
+ byte[] body = new byte[len];
+ in.readFully(body); // 读满 len 字节,不够就继续等待
+ return new String(body, StandardCharsets.UTF_8);
+}
+```
+
+需要注意的是,长度字段来自网络,必须限制上限,否则对方发来一个 2 GB 的长度,服务器就会为它分配 2 GB 内存。
diff --git a/notes/计算机网络 - 网络层.md b/notes/计算机网络 - 网络层.md
index 2f382744..e8227300 100644
--- a/notes/计算机网络 - 网络层.md
+++ b/notes/计算机网络 - 网络层.md
@@ -38,7 +38,7 @@
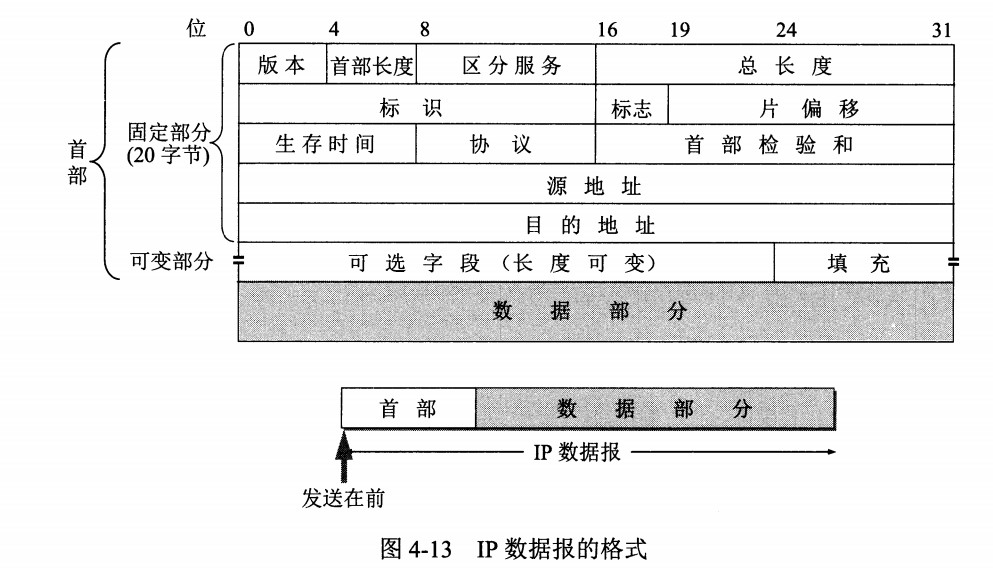
## IP 数据报格式
-
+
- **版本** : 有 4(IPv4)和 6(IPv6)两个值;
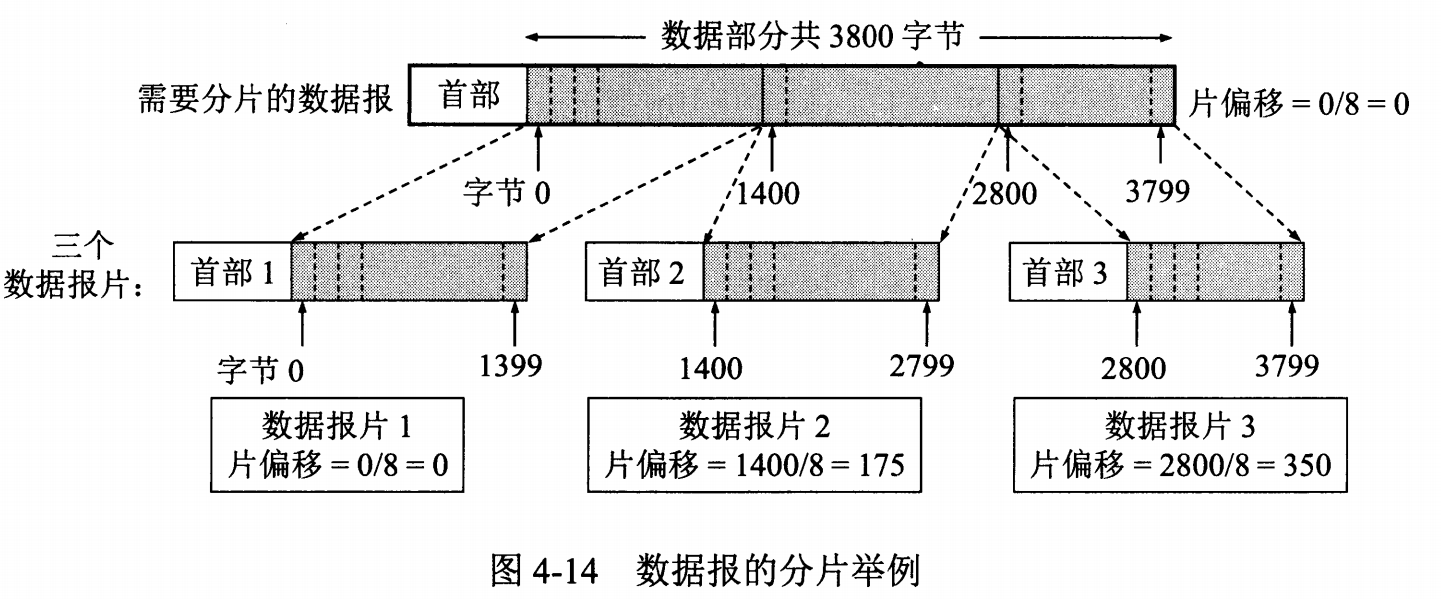
@@ -58,7 +58,7 @@
- **片偏移** : 和标识符一起,用于发生分片的情况。片偏移的单位为 8 字节。
-
+
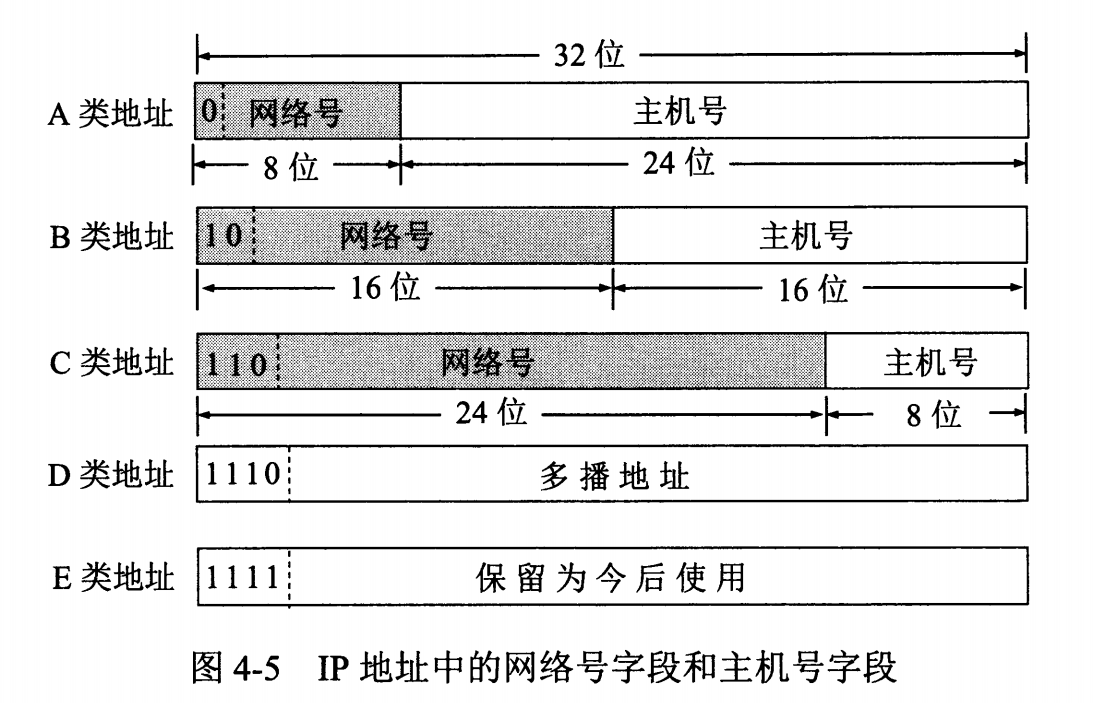
## IP 地址编址方式
@@ -74,7 +74,7 @@ IP 地址的编址方式经历了三个历史阶段:
IP 地址 ::= {\< 网络号 \>, \< 主机号 \>}
-
+
### 2. 子网划分
@@ -104,27 +104,33 @@ CIDR 的地址掩码可以继续称为子网掩码,子网掩码首 1 长度为
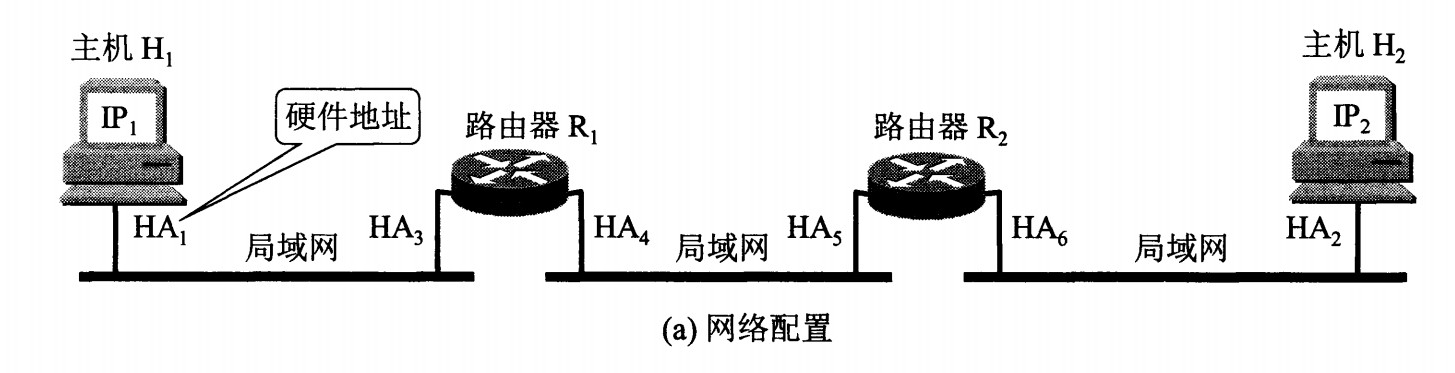
网络层实现主机之间的通信,而链路层实现具体每段链路之间的通信。因此在通信过程中,IP 数据报的源地址和目的地址始终不变,而 MAC 地址随着链路的改变而改变。
-
+
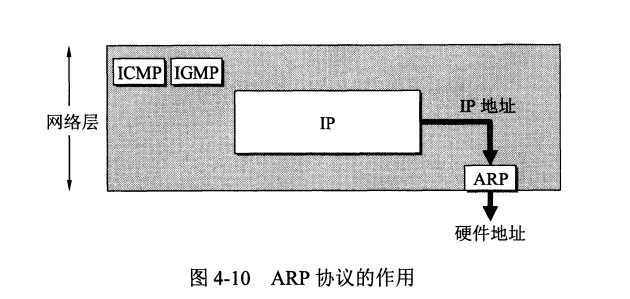
ARP 实现由 IP 地址得到 MAC 地址。
-
-
每个主机都有一个 ARP 高速缓存,里面有本局域网上的各主机和路由器的 IP 地址到 MAC 地址的映射表。
如果主机 A 知道主机 B 的 IP 地址,但是 ARP 高速缓存中没有该 IP 地址到 MAC 地址的映射,此时主机 A 通过广播的方式发送 ARP 请求分组,主机 B 收到该请求后会发送 ARP 响应分组给主机 A 告知其 MAC 地址,随后主机 A 向其高速缓存中写入主机 B 的 IP 地址到 MAC 地址的映射。
-
+
## 网际控制报文协议 ICMP
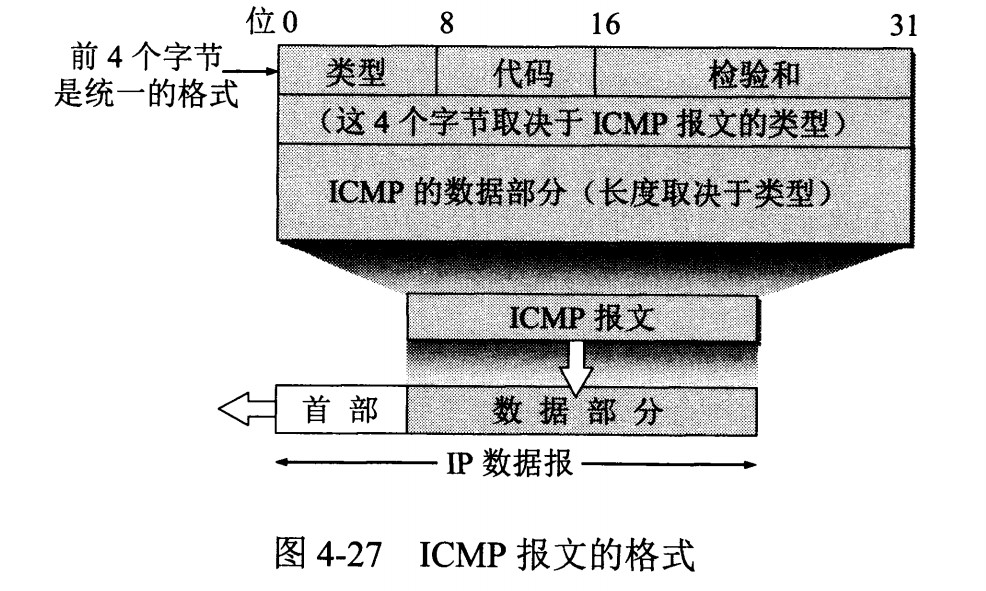
ICMP 是为了更有效地转发 IP 数据报和提高交付成功的机会。它封装在 IP 数据报中,但是不属于高层协议。
-
+
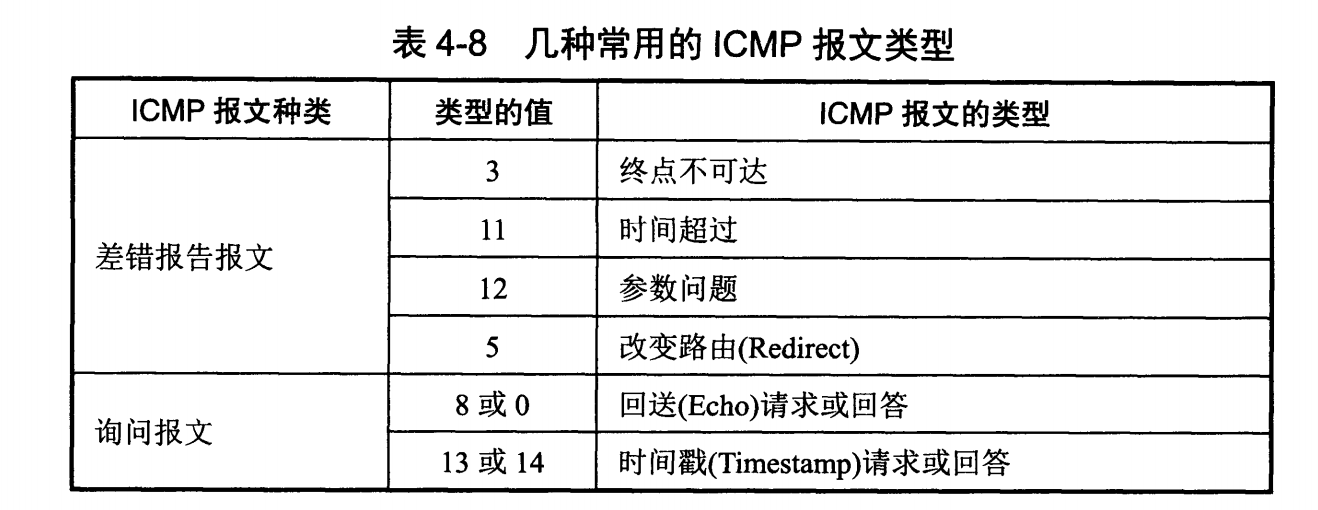
ICMP 报文分为差错报告报文和询问报文。
-
+| 类型 | 名称 | 种类 | 用途 |
+| --- | --- | --- | --- |
+| 0 | 回送回答 | 询问 | ping 收到的回答 |
+| 3 | 终点不可达 | 差错报告 | 主机、网络或端口不可达,Traceroute 到达终点时收到端口不可达 |
+| 5 | 改变路由(重定向) | 差错报告 | 路由器告诉主机有更好的下一跳 |
+| 8 | 回送请求 | 询问 | ping 发出的请求 |
+| 11 | 时间超过 | 差错报告 | TTL 减到 0 时由路由器发出,Traceroute 靠它得到沿途的路由器 |
+| 12 | 参数问题 | 差错报告 | 首部字段的值有错 |
+| 13、14 | 时间戳请求、回答 | 询问 | 很少使用 |
### 1. Ping
@@ -155,9 +161,9 @@ Traceroute 发送的 IP 数据报封装的是无法交付的 UDP 用户数据报
VPN 使用公用的互联网作为本机构各专用网之间的通信载体。专用指机构内的主机只与本机构内的其它主机通信;虚拟指好像是,而实际上并不是,它有经过公用的互联网。
-下图中,场所 A 和 B 的通信经过互联网,如果场所 A 的主机 X 要和另一个场所 B 的主机 Y 通信,IP 数据报的源地址是 10.1.0.1,目的地址是 10.2.0.3。数据报先发送到与互联网相连的路由器 R1,R1 对内部数据进行加密,然后重新加上数据报的首部,源地址是路由器 R1 的全球地址 125.1.2.3,目的地址是路由器 R2 的全球地址 194.4.5.6。路由器 R2 收到数据报后将数据部分进行解密,恢复原来的数据报,此时目的地址为 10.2.0.3,就交付给 Y。
+下图中,场所 A 和 B 的通信经过互联网,如果场所 A 的主机 X 要和另一个场所 B 的主机 Y 通信,IP 数据报的源地址是 10.1.0.5,目的地址是 10.2.0.8。数据报先发送到与互联网相连的路由器 R1,R1 对内部数据进行加密,然后重新加上数据报的首部,源地址是路由器 R1 的全球地址 203.0.113.1,目的地址是路由器 R2 的全球地址 198.51.100.2。路由器 R2 收到数据报后将数据部分进行解密,恢复原来的数据报,此时目的地址为 10.2.0.8,就交付给 Y。
-
+
## 网络地址转换 NAT
@@ -165,7 +171,7 @@ VPN 使用公用的互联网作为本机构各专用网之间的通信载体。
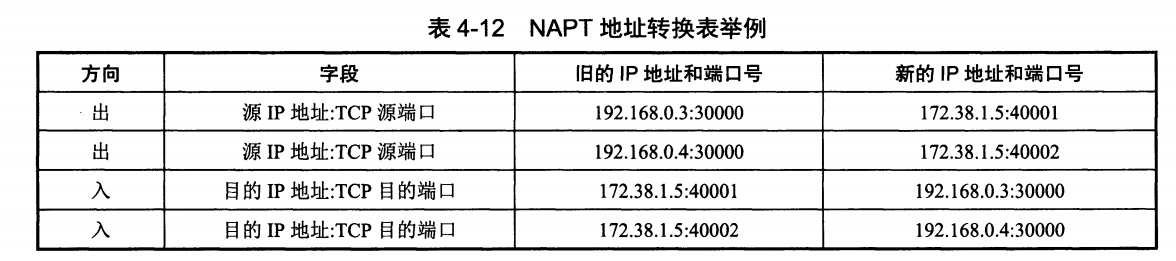
在以前,NAT 将本地 IP 和全球 IP 一一对应,这种方式下拥有 n 个全球 IP 地址的专用网内最多只可以同时有 n 台主机接入互联网。为了更有效地利用全球 IP 地址,现在常用的 NAT 转换表把传输层的端口号也用上了,使得多个专用网内部的主机共用一个全球 IP 地址。使用端口号的 NAT 也叫做网络地址与端口转换 NAPT。
-
+
## 路由器的结构
@@ -173,7 +179,7 @@ VPN 使用公用的互联网作为本机构各专用网之间的通信载体。
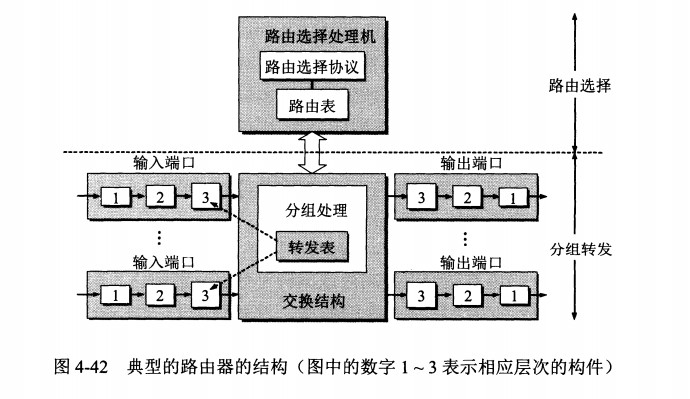
分组转发结构由三个部分组成:交换结构、一组输入端口和一组输出端口。
-
+
## 路由器分组转发流程
@@ -184,7 +190,9 @@ VPN 使用公用的互联网作为本机构各专用网之间的通信载体。
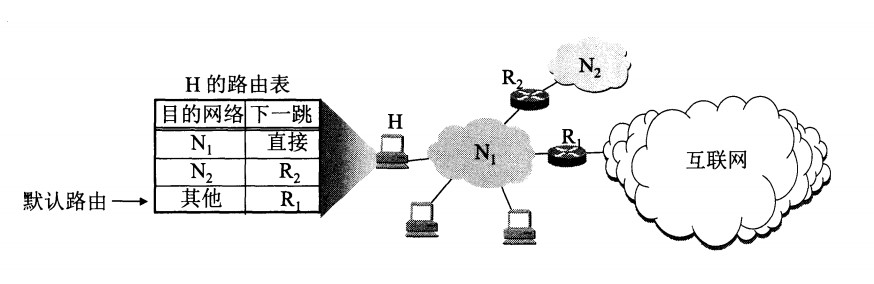
- 若路由表中有一个默认路由,则把数据报传送给路由表中所指明的默认路由器;
- 报告转发分组出错。
-
+实际的路由器用最长前缀匹配统一处理以上几种情况:特定主机路由的前缀长度为 32,默认路由为 0,查找时在匹配的表项中选前缀最长的一个。
+
+
## 路由选择协议
@@ -241,4 +249,4 @@ BGP 只能寻找一条比较好的路由,而不是最佳路由。
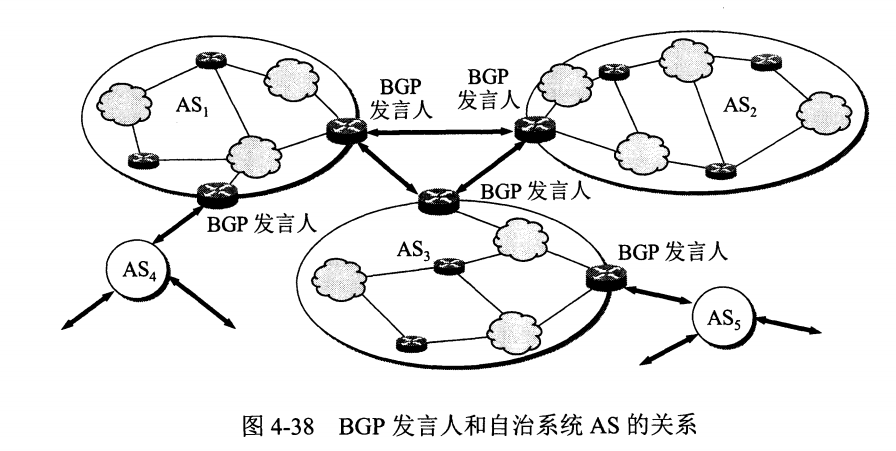
每个 AS 都必须配置 BGP 发言人,通过在两个相邻 BGP 发言人之间建立 TCP 连接来交换路由信息。
-
+