diff --git a/README.md b/README.md
index 759bb9fe..1bd349be 100644
--- a/README.md
+++ b/README.md
@@ -8,9 +8,9 @@
-| 算法 | 操作系统 | 网络 |面向对象| 数据库 | Java |系统设计| 工具 |编码实践| 后记 |
-| :---: | :----: | :---: | :----: | :----: | :----: | :----: | :----: | :----: | :----: |
-| [:pencil2:](#pencil2-算法) | [:computer:](#computer-操作系统) | [:cloud:](#cloud-网络) | [:art:](#art-面向对象) | [:floppy_disk:](#floppy_disk-数据库) |[:coffee:](#coffee-java)| [:bulb:](#bulb-系统设计) |[:wrench:](#wrench-工具)| [:watermelon:](#watermelon-编码实践) |[:memo:](#memo-后记)|
+| 算法 | 操作系统 | 网络 |面向对象| 数据库 | Java |系统设计| 工具 | 后记 |
+| :---: | :----: | :---: | :----: | :----: | :----: | :----: | :----: | :----: |
+| [:pencil2:](#pencil2-算法) | [:computer:](#computer-操作系统) | [:cloud:](#cloud-网络) | [:art:](#art-面向对象) | [:floppy_disk:](#floppy_disk-数据库) |[:coffee:](#coffee-java)| [:bulb:](#bulb-系统设计) |[:wrench:](#wrench-工具)| [:memo:](#memo-后记)|
@@ -80,12 +80,6 @@
- [Git](https://github.com/CyC2018/CS-Notes/blob/master/notes/Git.md)
- [Docker](https://github.com/CyC2018/CS-Notes/blob/master/notes/Docker.md)
- [构建工具](https://github.com/CyC2018/CS-Notes/blob/master/notes/构建工具.md)
-- [正则表达式](https://github.com/CyC2018/CS-Notes/blob/master/notes/正则表达式.md)
-
-## :watermelon: 编码实践
-
-- [代码可读性](https://github.com/CyC2018/CS-Notes/blob/master/notes/代码可读性.md)
-- [代码风格规范](https://github.com/CyC2018/CS-Notes/blob/master/notes/代码风格规范.md)
## :memo: 后记
diff --git a/notes/代码可读性.md b/notes/代码可读性.md
deleted file mode 100644
index 9d9618d1..00000000
--- a/notes/代码可读性.md
+++ /dev/null
@@ -1,331 +0,0 @@
-
-* [一、可读性的重要性](#一可读性的重要性)
-* [二、用名字表达代码含义](#二用名字表达代码含义)
-* [三、名字不能带来歧义](#三名字不能带来歧义)
-* [四、良好的代码风格](#四良好的代码风格)
-* [五、为何编写注释](#五为何编写注释)
-* [六、如何编写注释](#六如何编写注释)
-* [七、提高控制流的可读性](#七提高控制流的可读性)
-* [八、拆分长表达式](#八拆分长表达式)
-* [九、变量与可读性](#九变量与可读性)
-* [十、抽取函数](#十抽取函数)
-* [十一、一次只做一件事](#十一一次只做一件事)
-* [十二、用自然语言表述代码](#十二用自然语言表述代码)
-* [十三、减少代码量](#十三减少代码量)
-* [参考资料](#参考资料)
-
-
-
-# 一、可读性的重要性
-
-编程有很大一部分时间是在阅读代码,不仅要阅读自己的代码,而且要阅读别人的代码。因此,可读性良好的代码能够大大提高编程效率。
-
-可读性良好的代码往往会让代码架构更好,因为程序员更愿意去修改这部分代码,而且也更容易修改。
-
-只有在核心领域为了效率才可以放弃可读性,否则可读性是第一位。
-
-# 二、用名字表达代码含义
-
-一些比较有表达力的单词:
-
-| 单词 | 可替代单词 |
-| :---: | --- |
-| send | deliver、dispatch、announce、distribute、route |
-| find | search、extract、locate、recover |
-| start| launch、create、begin、open|
-| make | create、set up、build、generate、compose、add、new |
-
-使用 i、j、k 作为循环迭代器的名字过于简单,user_i、member_i 这种名字会更有表达力。因为循环层次越多,代码越难理解,有表达力的迭代器名字可读性会更高。
-
-为名字添加形容词等信息能让名字更具有表达力,但是名字也会变长。名字长短的准则是:作用域越大,名字越长。因此只有在短作用域才能使用一些简单名字。
-
-# 三、名字不能带来歧义
-
-起完名字要思考一下别人会对这个名字有何解读,会不会误解了原本想表达的含义。
-
-布尔相关的命名加上 is、can、should、has 等前缀。
-
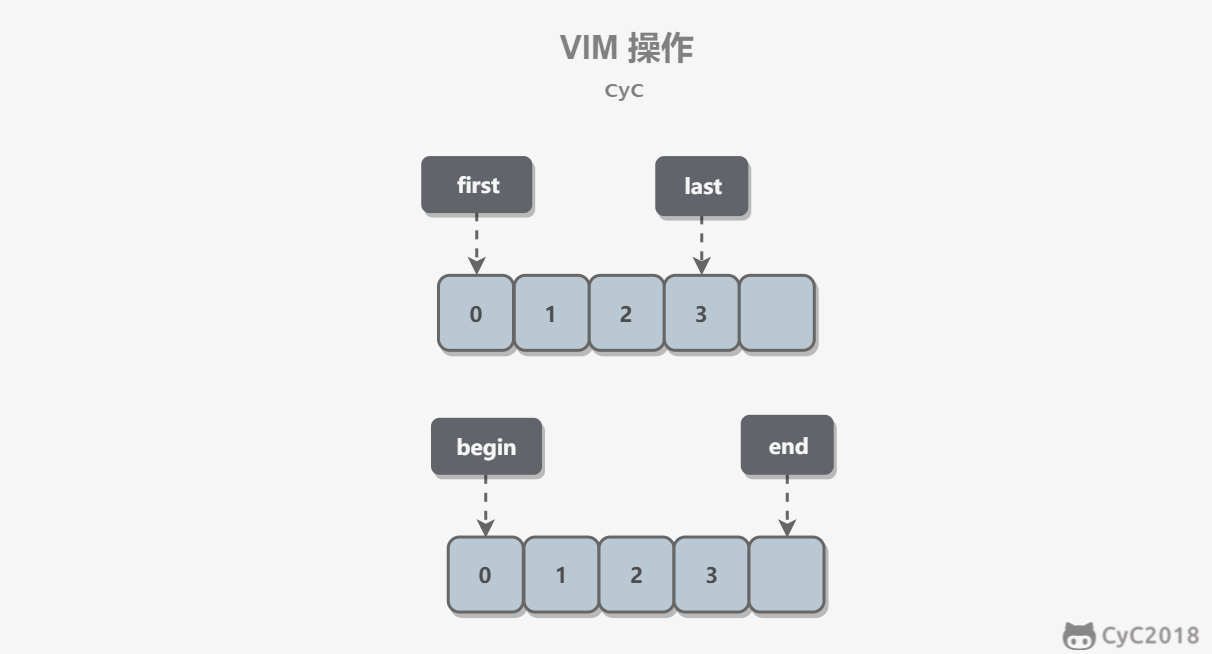
-- 用 min、max 表示数量范围;
-- 用 first、last 表示访问空间的包含范围;
-
-- begin、end 表示访问空间的排除范围,即 end 不包含尾部。
-
- 
-
-# 四、良好的代码风格
-
-适当的空行和缩进。
-
-排列整齐的注释:
-
-```java
-int a = 1; // 注释
-int b = 11; // 注释
-int c = 111; // 注释
-```
-
-语句顺序不能随意,比如与 html 表单相关联的变量的赋值应该和表单在 html 中的顺序一致。
-
-# 五、为何编写注释
-
-阅读代码首先会注意到注释,如果注释没太大作用,那么就会浪费代码阅读的时间。那些能直接看出含义的代码不需要写注释,特别是不需要为每个方法都加上注释,比如那些简单的 getter 和 setter 方法,为这些方法写注释反而让代码可读性更差。
-
-不能因为有注释就随便起个名字,而是争取起个好名字而不写注释。
-
-可以用注释来记录采用当前解决办法的思考过程,从而让读者更容易理解代码。
-
-注释用来提醒一些特殊情况。
-
-用 TODO 等做标记:
-
-| 标记 | 用法 |
-|---|---|
-|TODO| 待做 |
-|FIXME| 待修复 |
-|HACK| 粗糙的解决方案 |
-|XXX| 危险!这里有重要的问题 |
-
-# 六、如何编写注释
-
-尽量简洁明了:
-
-```java
-// The first String is student's name
-// The Second Integer is student's score
-Map scoreMap = new HashMap<>();
-```
-
-```java
-// Student's name -> Student's score
-Map scoreMap = new HashMap<>();
-```
-
-添加测试用例来说明:
-
-```java
-// ...
-// Example: add(1, 2), return 3
-int add(int x, int y) {
- return x + y;
-}
-```
-
-使用专业名词来缩短概念上的解释,比如用设计模式名来说明代码。
-
-# 七、提高控制流的可读性
-
-条件表达式中,左侧是变量,右侧是常数。比如下面第一个语句正确:
-
-```java
-if (len < 10)
-if (10 > len)
-```
-
-只有在逻辑简单的情况下使用 ? : 三目运算符来使代码更紧凑,否则应该拆分成 if / else;
-
-do / while 的条件放在后面,不够简单明了,并且会有一些迷惑的地方,最好使用 while 来代替。
-
-如果只有一个 goto 目标,那么 goto 尚且还能接受,但是过于复杂的 goto 会让代码可读性特别差,应该避免使用 goto。
-
-在嵌套的循环中,用一些 return 语句往往能减少嵌套的层数。
-
-# 八、拆分长表达式
-
-长表达式的可读性很差,可以引入一些解释变量从而拆分表达式:
-
-```python
-if line.split(':')[0].strip() == "root":
- ...
-```
-```python
-username = line.split(':')[0].strip()
-if username == "root":
- ...
-```
-
-使用摩根定理简化一些逻辑表达式:
-
-```java
-if (!a && !b) {
- ...
-}
-```
-```java
-if (!(a || b)) {
- ...
-}
-```
-
-# 九、变量与可读性
-
-**去除控制流变量** 。在循环中通过使用 break 或者 return 可以减少控制流变量的使用。
-
-```java
-boolean done = false;
-while (/* condition */ && !done) {
- ...
- if ( ... ) {
- done = true;
- continue;
- }
-}
-```
-
-```java
-while(/* condition */) {
- ...
- if ( ... ) {
- break;
- }
-}
-```
-
-**减小变量作用域** 。作用域越小,越容易定位到变量所有使用的地方。
-
-JavaScript 可以用闭包减小作用域。以下代码中 submit_form 是函数变量,submitted 变量控制函数不会被提交两次。第一个实现中 submitted 是全局变量,第二个实现把 submitted 放到匿名函数中,从而限制了起作用域范围。
-
-```js
-submitted = false;
-var submit_form = function(form_name) {
- if (submitted) {
- return;
- }
- submitted = true;
-};
-```
-
-```js
-var submit_form = (function() {
- var submitted = false;
- return function(form_name) {
- if(submitted) {
- return;
- }
- submitted = true;
- }
-}()); // () 使得外层匿名函数立即执行
-```
-
-JavaScript 中没有声明就直接赋值的变量会成为全局变量,而全局变量很容易造成迷惑,因此应当总是先声明变量,并且优先使用 let 和 const 而不是 var。
-
-变量定义的位置应当离它使用的位置最近。
-
-**实例解析**
-
-在一个网页中有以下文本输入字段:
-
-```html
-
-
-
-
-```
-
-现在要接受一个字符串并把它放到第一个空的 input 字段中,初始实现如下:
-
-```js
-var setFirstEmptyInput = function(new_alue) {
- var found = false;
- var i = 1;
- var elem = document.getElementById('input' + i);
- while (elem != null) {
- if (elem.value === '') {
- found = true;
- break;
- }
- i++;
- elem = document.getElementById('input' + i);
- }
- if (found) elem.value = new_value;
- return elem;
-}
-```
-
-以上实现有以下问题:
-
-- found 可以去除;
-- elem 作用域过大;
-- 可以用 for 循环代替 while 循环;
-
-```js
-var setFirstEmptyInput = function(new_value) {
- for (var i = 1; true; i++) {
- var elem = document.getElementById('input' + i);
- if (elem === null) {
- return null;
- }
- if (elem.value === '') {
- elem.value = new_value;
- return elem;
- }
- }
-};
-```
-
-# 十、抽取函数
-
-工程学就是把大问题拆分成小问题再把这些问题的解决方案放回一起。
-
-首先应该明确一个函数的高层次目标,然后对于不是直接为了这个目标工作的代码,抽取出来放到独立的函数中。
-
-介绍性的代码:
-
-```java
-int findClostElement(int[] arr) {
- int clostIdx = -1;
- int clostDist = Integer.MAX_VALUE;
- for (int i = 0; i < arr.length; i++) {
- int x = ...;
- int y = ...;
- int z = ...;
- int value = x * y * z;
- int dist = (int) Math.sqrt(Math.pow(value, 2) + Math.pow(arr[i], 2));
- if (dist < clostDist) {
- clostIdx = i;
- clostDist = dist;
- }
- }
- return clostIdx;
-}
-```
-
-以上代码中循环部分主要计算距离,这部分不属于代码高层次目标,高层次目标是寻找最小距离的值,因此可以把这部分代替提取到独立的函数中。这样做也带来一个额外的好处有:可以单独进行测试、可以快速找到程序错误并修改。
-
-```java
-public int findClostElement(int[] arr) {
- int clostIdx = -1;
- int clostDist = Integer.MAX_VALUE;
- for (int i = 0; i < arr.length; i++) {
- int dist = computDist(arr, i);
- if (dist < clostDist) {
- clostIdx = i;
- clostDist = dist;
- }
- }
- return clostIdx;
-}
-```
-
-并不是函数抽取的越多越好,如果抽取过多,在阅读代码的时候可能需要不断跳来跳去。只有在当前函数不需要去了解某一块代码细节而能够表达其内容时,把这块代码抽取成子函数才是好的。
-
-函数抽取也用于减小代码的冗余。
-
-# 十一、一次只做一件事
-
-只做一件事的代码很容易让人知道其要做的事;
-
-基本流程:列出代码所做的所有任务;把每个任务拆分到不同的函数,或者不同的段落。
-
-# 十二、用自然语言表述代码
-
-先用自然语言书写代码逻辑,也就是伪代码,然后再写代码,这样代码逻辑会更清晰。
-
-# 十三、减少代码量
-
-不要过度设计,编码过程会有很多变化,过度设计的内容到最后往往是无用的。
-
-多用标准库实现。
-
-# 参考资料
-
-- Dustin, Boswell, Trevor, 等. 编写可读代码的艺术 [M]. 机械工业出版社, 2012.
diff --git a/notes/代码风格规范.md b/notes/代码风格规范.md
deleted file mode 100644
index a30b537b..00000000
--- a/notes/代码风格规范.md
+++ /dev/null
@@ -1,4 +0,0 @@
-- [Twitter Java Style Guide](https://github.com/twitter/commons/blob/master/src/java/com/twitter/common/styleguide.md)
-- [Google Java Style Guide](http://google.github.io/styleguide/javaguide.html)
-- [阿里巴巴Java开发手册](https://github.com/alibaba/p3c)
-
diff --git a/notes/正则表达式.md b/notes/正则表达式.md
deleted file mode 100644
index 0aeadd61..00000000
--- a/notes/正则表达式.md
+++ /dev/null
@@ -1,392 +0,0 @@
-# 正则表达式
-
-* [正则表达式](#正则表达式)
- * [一、概述](#一概述)
- * [二、匹配单个字符](#二匹配单个字符)
- * [三、匹配一组字符](#三匹配一组字符)
- * [四、使用元字符](#四使用元字符)
- * [五、重复匹配](#五重复匹配)
- * [六、位置匹配](#六位置匹配)
- * [七、使用子表达式](#七使用子表达式)
- * [八、回溯引用](#八回溯引用)
- * [九、前后查找](#九前后查找)
- * [十、嵌入条件](#十嵌入条件)
- * [参考资料](#参考资料)
-
-
-
-## 一、概述
-
-正则表达式用于文本内容的查找和替换。
-
-正则表达式内置于其它语言或者软件产品中,它本身不是一种语言或者软件。
-
-[正则表达式在线工具](https://regexr.com/)
-
-## 二、匹配单个字符
-
-**.** 可以用来匹配任何的单个字符,但是在绝大多数实现里面,不能匹配换行符;
-
-**.** 是元字符,表示它有特殊的含义,而不是字符本身的含义。如果需要匹配 . ,那么要用 \ 进行转义,即在 . 前面加上 \ 。
-
-正则表达式一般是区分大小写的,但也有些实现不区分。
-
-**正则表达式**
-
-```text
-C.C2018
-```
-
-**匹配结果**
-
-My name is **CyC2018** .
-
-## 三、匹配一组字符
-
-**[ ]** 定义一个字符集合;
-
-0-9、a-z 定义了一个字符区间,区间使用 ASCII 码来确定,字符区间在 [ ] 中使用。
-
-**-** 只有在 [ ] 之间才是元字符,在 [ ] 之外就是一个普通字符;
-
-**^** 在 [ ] 中是取非操作。
-
-**应用**
-
-匹配以 abc 为开头,并且最后一个字母不为数字的字符串:
-
-**正则表达式**
-
-```text
-abc[^0-9]
-```
-
-**匹配结果**
-
-1. **abcd**
-2. abc1
-3. abc2
-
-## 四、使用元字符
-
-### 匹配空白字符
-
-| 元字符 | 说明 |
-| :---: | :---: |
-| [\b] | 回退(删除)一个字符 |
-| \f | 换页符 |
-| \n | 换行符 |
-| \r | 回车符 |
-| \t | 制表符 |
-| \v | 垂直制表符 |
-
-\r\n 是 Windows 中的文本行结束标签,在 Unix/Linux 则是 \n。
-
-\r\n\r\n 可以匹配 Windows 下的空白行,因为它匹配两个连续的行尾标签,而这正是两条记录之间的空白行;
-
-### 匹配特定的字符
-
-#### 1. 数字元字符
-
-| 元字符 | 说明 |
-| :---: | :---: |
-| \d | 数字字符,等价于 [0-9] |
-| \D | 非数字字符,等价于 [^0-9] |
-
-#### 2. 字母数字元字符
-
-| 元字符 | 说明 |
-| :---: | :---: |
-| \w | 大小写字母,下划线和数字,等价于 [a-zA-Z0-9\_] |
-| \W | 对 \w 取非 |
-
-#### 3. 空白字符元字符
-
-| 元字符 | 说明 |
-| :---: | :---: |
-| \s | 任何一个空白字符,等价于 [ \f\n\r\t\v] |
-| \S | 对 \s 取非 |
-
-\x 匹配十六进制字符,\0 匹配八进制,例如 \xA 对应值为 10 的 ASCII 字符 ,即 \n。
-
-## 五、重复匹配
-
-- **\+** 匹配 1 个或者多个字符
-- **\*** 匹配 0 个或者多个字符
-- **?** 匹配 0 个或者 1 个字符
-
-**应用**
-
-匹配邮箱地址。
-
-**正则表达式**
-
-```text
-[\w.]+@\w+\.\w+
-```
-
-[\w.] 匹配的是字母数字或者 . ,在其后面加上 + ,表示匹配多次。在字符集合 [ ] 里,. 不是元字符;
-
-**匹配结果**
-
-**abc.def\@\qq.com**
-
-- **{n}** 匹配 n 个字符
-- **{m,n}** 匹配 m\~n 个字符
-- **{m,}** 至少匹配 m 个字符
-
-\* 和 + 都是贪婪型元字符,会匹配尽可能多的内容。在后面加 ? 可以转换为懒惰型元字符,例如 \*?、+? 和 {m,n}? 。
-
-**正则表达式**
-
-```text
-a.+c
-```
-
-**匹配结果**
-
-**abcabcabc**
-
-由于 + 是贪婪型的,因此 .+ 会匹配更可能多的内容,所以会把整个 abcabcabc 文本都匹配,而不是只匹配前面的 abc 文本。用懒惰型可以实现匹配前面的。
-
-## 六、位置匹配
-
-### 单词边界
-
-**\b** 可以匹配一个单词的边界,边界是指位于 \w 和 \W 之间的位置;**\B** 匹配一个不是单词边界的位置。
-
-\b 只匹配位置,不匹配字符,因此 \babc\b 匹配出来的结果为 3 个字符。
-
-### 字符串边界
-
-**^** 匹配整个字符串的开头,**$** 匹配结尾。
-
-^ 元字符在字符集合中用作求非,在字符集合外用作匹配字符串的开头。
-
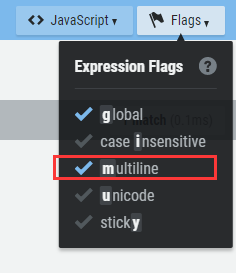
-分行匹配模式(multiline)下,换行被当做字符串的边界。
-
-**应用**
-
-匹配代码中以 // 开始的注释行
-
-**正则表达式**
-
-```text
-^\s*\/\/.*$
-```
-
-
-
-**匹配结果**
-
-1. public void fun() {
-2. **// 注释 1**
-3. int a = 1;
-4. int b = 2;
-5. **// 注释 2**
-6. int c = a + b;
-7. }
-
-## 七、使用子表达式
-
-使用 **( )** 定义一个子表达式。子表达式的内容可以当成一个独立元素,即可以将它看成一个字符,并且使用 * 等元字符。
-
-子表达式可以嵌套,但是嵌套层次过深会变得很难理解。
-
-**正则表达式**
-
-```text
-(ab){2,}
-```
-
-**匹配结果**
-
-**ababab**
-
-**|** 是或元字符,它把左边和右边所有的部分都看成单独的两个部分,两个部分只要有一个匹配就行。
-
-**正则表达式**
-
-```text
-(19|20)\d{2}
-```
-
-**匹配结果**
-
-1. **1900**
-2. **2010**
-3. 1020
-
-**应用**
-
-匹配 IP 地址。
-
-IP 地址中每部分都是 0-255 的数字,用正则表达式匹配时以下情况是合法的:
-
-- 一位数字
-- 不以 0 开头的两位数字
-- 1 开头的三位数
-- 2 开头,第 2 位是 0-4 的三位数
-- 25 开头,第 3 位是 0-5 的三位数
-
-**正则表达式**
-
-```text
-((25[0-5]|(2[0-4]\d)|(1\d{2})|([1-9]\d)|(\d))\.){3}(25[0-5]|(2[0-4]\d)|(1\d{2})|([1-9]\d)|(\d))
-```
-
-**匹配结果**
-
-1. **192.168.0.1**
-2. 00.00.00.00
-3. 555.555.555.555
-
-## 八、回溯引用
-
-回溯引用使用 **\n** 来引用某个子表达式,其中 n 代表的是子表达式的序号,从 1 开始。它和子表达式匹配的内容一致,比如子表达式匹配到 abc,那么回溯引用部分也需要匹配 abc 。
-
-**应用**
-
-匹配 HTML 中合法的标题元素。
-
-**正则表达式**
-
-\1 将回溯引用子表达式 (h[1-6]) 匹配的内容,也就是说必须和子表达式匹配的内容一致。
-
-```text
-<(h[1-6])>\w*?<\/\1>
-```
-
-**匹配结果**
-
-1. **<h1\>x</h1\>**
-2. **<h2\>x</h2\>**
-3. <h3\>x</h1\>
-
-### 替换
-
-需要用到两个正则表达式。
-
-**应用**
-
-修改电话号码格式。
-
-**文本**
-
-313-555-1234
-
-**查找正则表达式**
-
-```text
-(\d{3})(-)(\d{3})(-)(\d{4})
-```
-
-**替换正则表达式**
-
-在第一个子表达式查找的结果加上 () ,然后加一个空格,在第三个和第五个子表达式查找的结果中间加上 - 进行分隔。
-
-```text
-($1) $3-$5
-```
-
-**结果**
-
-(313) 555-1234
-
-### 大小写转换
-
-| 元字符 | 说明 |
-| :---: | :---: |
-| \l | 把下个字符转换为小写 |
-| \u| 把下个字符转换为大写 |
-| \L | 把\L 和\E 之间的字符全部转换为小写 |
-| \U | 把\U 和\E 之间的字符全部转换为大写 |
-| \E | 结束\L 或者\U |
-
-**应用**
-
-把文本的第二个和第三个字符转换为大写。
-
-**文本**
-
-abcd
-
-**查找**
-
-```text
-(\w)(\w{2})(\w)
-```
-
-**替换**
-
-```text
-$1\U$2\E$3
-```
-
-**结果**
-
-aBCd
-
-## 九、前后查找
-
-前后查找规定了匹配的内容首尾应该匹配的内容,但是又不包含首尾匹配的内容。
-
-向前查找使用 **?=** 定义,它规定了尾部匹配的内容,这个匹配的内容在 ?= 之后定义。所谓向前查找,就是规定了一个匹配的内容,然后以这个内容为尾部向前面查找需要匹配的内容。向后匹配用 ?\<= 定义(注: JavaScript 不支持向后匹配,Java 对其支持也不完善)。
-
-**应用**
-
-查找出邮件地址 @ 字符前面的部分。
-
-**正则表达式**
-
-```text
-\w+(?=@)
-```
-
-**结果**
-
-**abc** @qq.com
-
-对向前和向后查找取非,只要把 = 替换成 ! 即可,比如 (?=) 替换成 (?!) 。取非操作使得匹配那些首尾不符合要求的内容。
-
-## 十、嵌入条件
-
-### 回溯引用条件
-
-条件为某个子表达式是否匹配,如果匹配则需要继续匹配条件表达式后面的内容。
-
-**正则表达式**
-
-子表达式 (\\() 匹配一个左括号,其后的 ? 表示匹配 0 个或者 1 个。 ?(1) 为条件,当子表达式 1 匹配时条件成立,需要执行 \) 匹配,也就是匹配右括号。
-
-```text
-(\()?abc(?(1)\))
-```
-
-**结果**
-
-1. **(abc)**
-2. **abc**
-3. (abc
-
-### 前后查找条件
-
-条件为定义的首尾是否匹配,如果匹配,则继续执行后面的匹配。注意,首尾不包含在匹配的内容中。
-
-**正则表达式**
-
- ?(?=-) 为前向查找条件,只有在以 - 为前向查找的结尾能匹配 \d{5} ,才继续匹配 -\d{4} 。
-
-```text
-\d{5}(?(?=-)-\d{4})
-```
-
-**结果**
-
-1. **11111**
-2. 22222-
-3. **33333-4444**
-
-## 参考资料
-
-- Ben Forta. 正则表达式必知必会 [M]. 人民邮电出版社, 2007.
diff --git a/website/builder/build.py b/website/builder/build.py
index 2229b778..4e773ac2 100644
--- a/website/builder/build.py
+++ b/website/builder/build.py
@@ -145,7 +145,7 @@ def build(optimize=True):
homepage = homepage.replace(':' + name + ':', symbol)
topics = [('算法', '✏️'), ('操作系统', '💻'), ('网络', '☁️'), ('面向对象', '🎨'),
('数据库', '💾'), ('Java', '☕'), ('系统设计', '💡'), ('工具', '🔧'),
- ('编码实践', '🍉'), ('后记', '📝')]
+ ('后记', '📝')]
cards = ''
diff --git a/website/templates/legacy-routes.json b/website/templates/legacy-routes.json
index 4831b0c2..30602dd6 100644
--- a/website/templates/legacy-routes.json
+++ b/website/templates/legacy-routes.json
@@ -38,18 +38,9 @@
"/其它/编码实践/Git": "/notes/Git",
"/其它/编码实践/Git.html": "/notes/Git",
"/其它/编码实践/Git.md": "/notes/Git",
- "/其它/编码实践/代码可读性": "/notes/代码可读性",
- "/其它/编码实践/代码可读性.html": "/notes/代码可读性",
- "/其它/编码实践/代码可读性.md": "/notes/代码可读性",
- "/其它/编码实践/代码风格规范": "/notes/代码风格规范",
- "/其它/编码实践/代码风格规范.html": "/notes/代码风格规范",
- "/其它/编码实践/代码风格规范.md": "/notes/代码风格规范",
"/其它/编码实践/构建工具": "/notes/构建工具",
"/其它/编码实践/构建工具.html": "/notes/构建工具",
"/其它/编码实践/构建工具.md": "/notes/构建工具",
- "/其它/编码实践/正则表达式": "/notes/正则表达式",
- "/其它/编码实践/正则表达式.html": "/notes/正则表达式",
- "/其它/编码实践/正则表达式.md": "/notes/正则表达式",
"/其它/编码实践/面向对象思想": "/notes/面向对象思想",
"/其它/编码实践/面向对象思想.html": "/notes/面向对象思想",
"/其它/编码实践/面向对象思想.md": "/notes/面向对象思想",