diff --git a/notes/Java 虚拟机.md b/notes/Java 虚拟机.md
index b76b26b4..6f854b24 100644
--- a/notes/Java 虚拟机.md
+++ b/notes/Java 虚拟机.md
@@ -33,15 +33,20 @@
* [内存溢出与内存泄漏](#内存溢出与内存泄漏)
* [CPU 占用过高](#cpu-占用过高)
* [死锁](#死锁)
+ * [附录:实测](#附录实测)
+ * [A1 默认的线程栈大小](#a1-默认的线程栈大小)
+ * [A2 逃逸分析](#a2-逃逸分析)
+ * [A3 不同收集器的停顿](#a3-不同收集器的停顿)
+ * [A4 堆大小对 G1 的影响](#a4-堆大小对-g1-的影响)
* [参考资料](#参考资料)
-本文大部分内容参考 **周志明《深入理解 Java 虚拟机》** ,想要深入学习的话请看原书。
+本文大部分内容参考周志明《深入理解 Java 虚拟机》,想要深入学习的话请看原书。
## 一、运行时数据区域
- 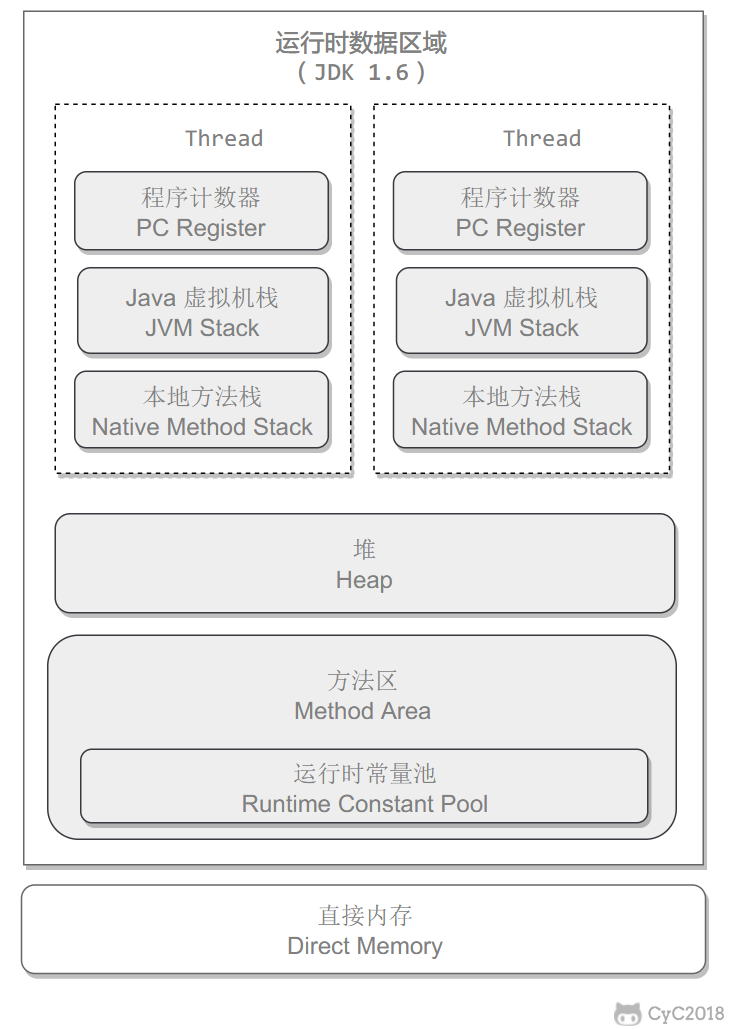
+ 
### 程序计数器
@@ -51,11 +56,11 @@
每个 Java 方法在执行的同时会创建一个栈帧用于存储局部变量表、操作数栈、常量池引用等信息。从方法调用直至执行完成的过程,对应着一个栈帧在 Java 虚拟机栈中入栈和出栈的过程。
- 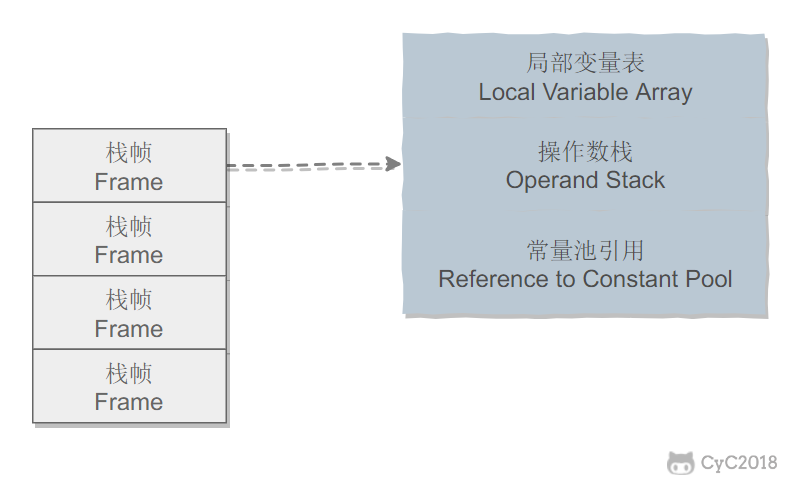
+ 
-可以通过 -Xss 这个虚拟机参数来指定每个线程的 Java 虚拟机栈内存大小,默认值与平台有关,64 位 Linux 上为 1 MB,本机 macOS(Apple 芯片)上的 JDK 21 用 -XX:+PrintFlagsFinal 查看 ThreadStackSize 为 2048 KB:
+可以通过 -Xss 这个虚拟机参数来指定每个线程的 Java 虚拟机栈内存大小,默认值与平台有关,64 位 Linux 上为 1 MB,macOS(Apple 芯片)上的 JDK 21 为 2 MB(-XX:+PrintFlagsFinal 中的 ThreadStackSize,见[附录 A1](#a1-默认的线程栈大小)):
-```java
+```bash
java -Xss2M HackTheJava
```
@@ -70,13 +75,13 @@ java -Xss2M HackTheJava
本地方法一般是用其它语言(C、C++ 或汇编语言等)编写的,并且被编译为基于本机硬件和操作系统的程序,对待这些方法需要特别处理。
- 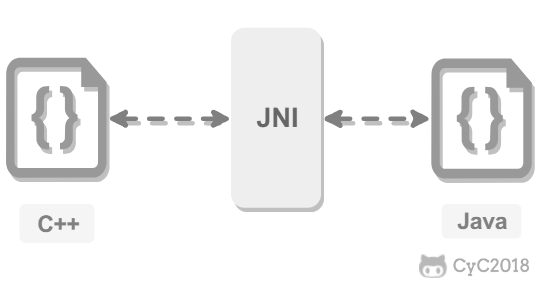
+ 
### 堆
-所有对象都在这里分配内存,是垃圾收集的主要区域("GC 堆")。
+几乎所有对象都在这里分配内存(例外见下文的逃逸分析),是垃圾收集的主要区域(“GC 堆”)。
-现代的垃圾收集器基本都是采用分代收集算法,其主要的思想是针对不同类型的对象采取不同的垃圾回收算法。可以将堆分成两块:
+现代的垃圾收集器基本都是采用分代收集算法,其主要的思想是针对不同类型的对象采取不同的垃圾收集算法。可以将堆分成两块:
- 新生代(Young Generation)
- 老年代(Old Generation)
@@ -85,7 +90,7 @@ java -Xss2M HackTheJava
可以通过 -Xms 和 -Xmx 这两个虚拟机参数来指定一个程序的堆内存大小,第一个参数设置初始值,第二个参数设置最大值。
-```java
+```bash
java -Xms1M -Xmx2M HackTheJava
```
@@ -95,9 +100,9 @@ java -Xms1M -Xmx2M HackTheJava
和堆一样不需要连续的内存,并且可以动态扩展,动态扩展失败一样会抛出 OutOfMemoryError 异常。
-对这块区域进行垃圾回收的主要目标是对常量池的回收和对类的卸载,但是一般比较难实现。
+对这块区域进行垃圾收集的主要目标是对常量池的回收和对类的卸载,但是一般比较难实现。
-HotSpot 虚拟机把它当成永久代来进行垃圾回收。但很难确定永久代的大小,因为它受到很多因素影响,并且每次 Full GC 之后永久代的大小都会改变,所以经常会抛出 OutOfMemoryError 异常。为了更容易管理方法区,从 JDK 1.8 开始,移除永久代,并把方法区移至元空间,它位于本地内存中,而不是虚拟机内存中。
+JDK 1.8 之前,HotSpot 虚拟机用永久代实现方法区,和堆一样进行垃圾收集。但很难确定永久代的大小,因为它受到很多因素影响,并且每次 Full GC 之后永久代的大小都会改变,所以经常会抛出 OutOfMemoryError 异常。为了更容易管理方法区,从 JDK 1.8 开始,移除永久代,并把方法区移至元空间,它位于本地内存中,而不是虚拟机内存中。
方法区是一个 JVM 规范,永久代与元空间都是其一种实现方式。JDK 1.7 把字符串常量池和类的静态变量从永久代移到了堆中,JDK 1.8 移除永久代,改用本地内存中的元空间存储类的元信息和运行时常量池。
@@ -107,7 +112,7 @@ HotSpot 虚拟机把它当成永久代来进行垃圾回收。但很难确定永
Class 文件中的常量池(编译器生成的字面量和符号引用)会在类加载后被放入这个区域。
-除了在编译期生成的常量,还允许动态生成,例如 String 类的 intern()。
+除了在编译期生成的常量,还允许在运行期间放入新的常量。需要注意的是,JDK 7 起字符串常量池已经移到堆中,String 类的 intern() 操作的是堆中的字符串常量池。
### 直接内存
@@ -117,7 +122,7 @@ Class 文件中的常量池(编译器生成的字面量和符号引用)会
- 存放的内容:虚拟机栈中是方法调用的栈帧,保存局部变量、操作数和返回地址;堆中是对象和数组,JDK 7 起静态变量和字符串常量池也在堆中;
- 共享范围:每个线程有自己的栈,其它线程访问不到;堆被所有线程共享,所以只有堆中的对象才存在线程安全问题;
-- 生命周期:栈帧在方法调用时创建、返回时销毁,不需要垃圾回收;堆中的对象由垃圾收集器回收;
+- 生命周期:栈帧在方法调用时创建、返回时销毁,不需要垃圾收集;堆中的对象由垃圾收集器回收;
- 大小和异常:栈的大小由 -Xss 设置,调用层次太深时抛出 StackOverflowError;堆的大小由 -Xms、-Xmx 设置,放不下时抛出 OutOfMemoryError。
```java
@@ -129,7 +134,7 @@ void pay(long orderId) {
方法返回后,栈帧中的 amount 和 order 立即消失;Order 对象如果没有被其它地方引用,会在之后的 GC 中被回收。操作系统中进程地址空间的栈和堆也是类似的划分:栈由编译器生成的代码自动分配和释放,堆由程序调用 malloc、free 管理。
-需要注意的是,对象不一定都在堆中创建。JIT 编译时会做逃逸分析,如果一个对象不会离开创建它的方法(没有被返回、没有赋给字段、没有传给其它线程),HotSpot 会把它拆成几个局部变量,这称为标量替换,堆中不再创建这个对象。例如在循环中创建 2 亿个只在方法内部使用的 Point 对象,在 JDK 21 上默认没有发生 GC,耗时约 134 ms;加上 -XX:-DoEscapeAnalysis 关闭逃逸分析后,发生了 31 次 GC,耗时约 305 ms。
+需要注意的是,对象不一定都在堆中创建。JIT 编译时会做逃逸分析,如果一个对象不会离开创建它的方法(没有被返回、没有赋给字段、没有传给其它线程),HotSpot 会把它拆成几个局部变量,这称为标量替换,堆中不再创建这个对象。例如在循环中创建 2 亿个只在方法内部使用的 Point 对象,默认没有发生 GC,耗时约 130 ms;加上 -XX:-DoEscapeAnalysis 关闭逃逸分析后,发生了 13 次 GC,耗时约 335 ms(JDK 21 实测,见[附录 A2](#a2-逃逸分析))。
### 对象的创建与内存布局
@@ -171,7 +176,7 @@ Instance size: 32 bytes
## 二、垃圾收集
-垃圾收集主要是针对堆和方法区进行。程序计数器、虚拟机栈和本地方法栈这三个区域属于线程私有的,只存在于线程的生命周期内,线程结束之后就会消失,因此不需要对这三个区域进行垃圾回收。
+垃圾收集主要是针对堆和方法区进行。程序计数器、虚拟机栈和本地方法栈这三个区域属于线程私有的,只存在于线程的生命周期内,线程结束之后就会消失,因此不需要对这三个区域进行垃圾收集。
### 判断一个对象是否可被回收
@@ -198,7 +203,7 @@ public class Test {
}
```
-在上述代码中,a 与 b 引用的对象实例互相持有了对象的引用,因此当我们把对 a 对象与 b 对象的引用去除之后,由于两个对象还存在互相之间的引用,导致两个 Test 对象无法被回收。
+在上述代码中,a 与 b 引用的对象实例互相持有了对象的引用,因此把对 a 对象与 b 对象的引用去除之后,由于两个对象还存在互相之间的引用,导致两个 Test 对象无法被回收。
#### 2. 可达性分析算法
@@ -206,17 +211,17 @@ public class Test {
Java 虚拟机使用该算法来判断对象是否可被回收,GC Roots 一般包含以下内容:
-- 虚拟机栈中局部变量表中引用的对象
-- 本地方法栈中 JNI 中引用的对象
-- 方法区中类静态属性引用的对象
-- 方法区中的常量引用的对象
+- 虚拟机栈中局部变量表中引用的对象;
+- 本地方法栈中 JNI 中引用的对象;
+- 方法区中类静态属性引用的对象;
+- 方法区中的常量引用的对象。
- 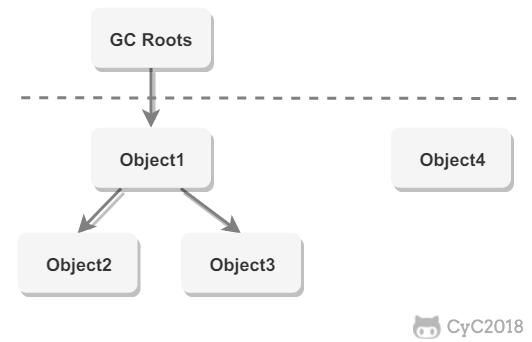
+ 
#### 3. 方法区的回收
-因为方法区主要存放永久代对象,而永久代对象的回收率比新生代低很多,所以在方法区上进行回收性价比不高。
+方法区中的类和常量很少变成垃圾,回收的收益比新生代低很多,所以在方法区上进行回收性价比不高。
主要是对常量池的回收和对类的卸载。
@@ -224,13 +229,13 @@ Java 虚拟机使用该算法来判断对象是否可被回收,GC Roots 一般
类的卸载条件很多,需要满足以下三个条件,并且满足了条件也不一定会被卸载:
-- 该类所有的实例都已经被回收,此时堆中不存在该类的任何实例。
-- 加载该类的 ClassLoader 已经被回收。
+- 该类所有的实例都已经被回收,此时堆中不存在该类的任何实例;
+- 加载该类的 ClassLoader 已经被回收;
- 该类对应的 Class 对象没有在任何地方被引用,也就无法在任何地方通过反射访问该类方法。
#### 4. finalize()
-类似 C++ 的析构函数,用于关闭外部资源。但是 try-finally 等方式可以做得更好,并且该方法运行代价很高,不确定性大,无法保证各个对象的调用顺序,因此最好不要使用。
+类似 C++ 的析构函数,用于关闭外部资源。但是 try-finally 等方式可以做得更好,并且该方法运行代价很高,不确定性大,无法保证各个对象的调用顺序,因此最好不要使用。finalize() 从 JDK 9 起已经废弃,JDK 18 起标记为将要删除(JEP 421),需要在对象被回收后清理资源时可以使用 java.lang.ref.Cleaner。
当一个对象可被回收时,如果需要执行该对象的 finalize() 方法,那么就有可能在该方法中让对象重新被引用,从而实现自救。自救只能进行一次,如果回收的对象之前调用了 finalize() 方法自救,后面回收时不会再调用该方法。
@@ -264,7 +269,7 @@ obj = null; // 使对象只被软引用关联
#### 3. 弱引用
-被弱引用关联的对象一定会被回收,也就是说它只能存活到下一次垃圾回收发生之前。
+被弱引用关联的对象一定会被回收,也就是说它只能存活到下一次垃圾收集发生之前。
使用 WeakReference 类来创建弱引用。
@@ -293,9 +298,9 @@ obj = null;
#### 1. 标记 - 清除
- 
+ 
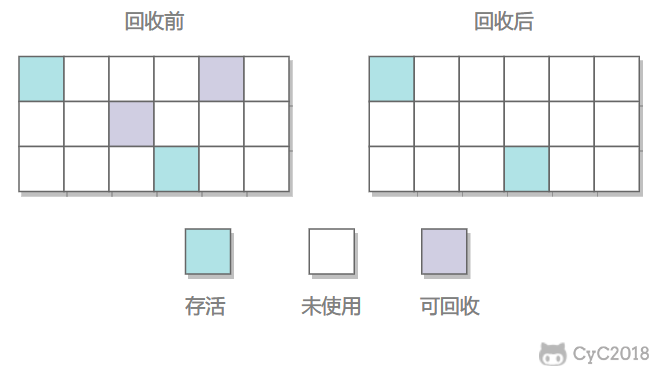
-在标记阶段,程序会检查每个对象是否为活动对象,如果是活动对象,则程序会在对象头部打上标记。
+在标记阶段,程序会检查每个对象是否为活动对象,如果是活动对象,则程序会在对象头中打上标记。
在清除阶段,会进行对象回收并取消标志位,另外,还会判断回收后的分块与前一个空闲分块是否连续,若连续,会合并这两个分块。回收对象就是把对象占用的内存作为空闲分块,连接到被称为 “空闲链表” 的单向链表,之后进行分配时只需要遍历这个空闲链表,就可以找到分块。
@@ -308,21 +313,17 @@ obj = null;
#### 2. 标记 - 整理
- 
+ 
让所有存活的对象都向一端移动,然后直接清理掉端边界以外的内存。
-优点:
+优点:不会产生内存碎片。
-- 不会产生内存碎片
-
-不足:
-
-- 需要移动大量对象,处理效率比较低。
+不足:需要移动大量对象,处理效率比较低。
#### 3. 复制
- 
+ 
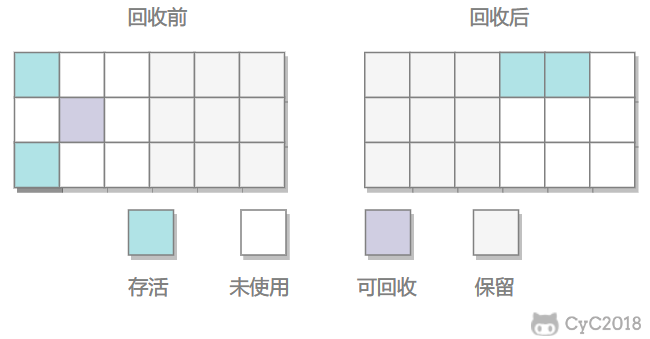
将内存划分为大小相等的两块,每次只使用其中一块,当这一块内存用完了就将还存活的对象复制到另一块上面,然后再把使用过的内存空间进行一次清理。
@@ -338,17 +339,17 @@ HotSpot 虚拟机的 Eden 和 Survivor 大小比例默认为 8:1,保证了内
一般将堆分为新生代和老年代。
-- 新生代使用:复制算法
-- 老年代使用:标记 - 清除 或者 标记 - 整理 算法
+- 新生代使用:复制算法;
+- 老年代使用:标记 - 清除 或者 标记 - 整理 算法。
### 垃圾收集器

-以上是 HotSpot 虚拟机中的 7 个垃圾收集器,连线表示垃圾收集器可以配合使用。
+以上是 JDK 8 中 HotSpot 虚拟机的 7 个垃圾收集器,连线表示垃圾收集器可以配合使用。OpenJDK 21 中保留了 Serial、Serial Old、Parallel Scavenge、Parallel Old 和 G1,CMS 和 ParNew 已经移除,另外新增了 ZGC 和 Shenandoah 这两个以并发为主的收集器(Oracle JDK 不包含 Shenandoah)。
- 单线程与多线程:单线程指的是垃圾收集器只使用一个线程,而多线程使用多个线程;
-- 串行与并发:串行指的是垃圾收集器与用户程序交替执行,这意味着在执行垃圾收集的时候需要停顿用户程序;并发指的是垃圾收集器和用户程序同时执行。除了 CMS 和 G1 之外,其它垃圾收集器都是以串行的方式执行。
+- 串行与并发:串行指的是垃圾收集器与用户程序交替执行,这意味着在执行垃圾收集的时候需要停顿用户程序;并发指的是垃圾收集器和用户程序同时执行。图中除了 CMS 和 G1 之外,其它垃圾收集器都是以串行的方式执行。
#### 1. Serial 收集器
@@ -378,7 +379,7 @@ Serial 翻译为串行,也就是说它以串行的方式执行。
停顿时间越短就越适合需要与用户交互的程序,良好的响应速度能提升用户体验。而高吞吐量则可以高效率地利用 CPU 时间,尽快完成程序的运算任务,适合在后台运算而不需要太多交互的任务。
-缩短停顿时间是以牺牲吞吐量和新生代空间来换取的:新生代空间变小,垃圾回收变得频繁,导致吞吐量下降。
+缩短停顿时间是以牺牲吞吐量和新生代空间来换取的:新生代空间变小,垃圾收集变得频繁,导致吞吐量下降。
可以通过一个开关参数打开 GC 自适应的调节策略(GC Ergonomics),就不需要手工指定新生代的大小(-Xmn)、Eden 和 Survivor 区的比例、晋升老年代对象年龄等细节参数了。虚拟机会根据当前系统的运行情况收集性能监控信息,动态调整这些参数以提供最合适的停顿时间或者最大的吞吐量。
@@ -388,7 +389,7 @@ Serial 翻译为串行,也就是说它以串行的方式执行。
是 Serial 收集器的老年代版本,也是给 Client 场景下的虚拟机使用。如果用在 Server 场景下,它有两大用途:
-- 在 JDK 1.5 以及之前版本(Parallel Old 诞生以前)中与 Parallel Scavenge 收集器搭配使用。
+- 在 JDK 1.5 以及之前版本(Parallel Old 诞生以前)中与 Parallel Scavenge 收集器搭配使用;
- 作为 CMS 收集器的后备预案,在并发收集发生 Concurrent Mode Failure 时使用。
#### 5. Parallel Old 收集器
@@ -407,17 +408,17 @@ CMS(Concurrent Mark Sweep),Mark Sweep 指的是标记 - 清除算法。
分为以下四个流程:
-- 初始标记:仅仅只是标记一下 GC Roots 能直接关联到的对象,速度很快,需要停顿。
-- 并发标记:进行 GC Roots Tracing 的过程,它在整个回收过程中耗时最长,不需要停顿。
-- 重新标记:为了修正并发标记期间因用户程序继续运作而导致标记产生变动的那一部分对象的标记记录,需要停顿。
+- 初始标记:仅仅只是标记一下 GC Roots 能直接关联到的对象,速度很快,需要停顿;
+- 并发标记:进行 GC Roots Tracing 的过程,它在整个回收过程中耗时最长,不需要停顿;
+- 重新标记:为了修正并发标记期间因用户程序继续运作而导致标记产生变动的那一部分对象的标记记录,需要停顿;
- 并发清除:不需要停顿。
在整个过程中耗时最长的并发标记和并发清除过程中,收集器线程都可以与用户线程一起工作,不需要进行停顿。
具有以下缺点:
-- 吞吐量低:低停顿时间是以牺牲吞吐量为代价的,导致 CPU 利用率不够高。
-- 无法处理浮动垃圾,可能出现 Concurrent Mode Failure。浮动垃圾是指并发清除阶段由于用户线程继续运行而产生的垃圾,这部分垃圾只能到下一次 GC 时才能进行回收。由于浮动垃圾的存在,因此需要预留出一部分内存,意味着 CMS 收集不能像其它收集器那样等待老年代快满的时候再回收。如果预留的内存不够存放浮动垃圾,就会出现 Concurrent Mode Failure,这时虚拟机将临时启用 Serial Old 来替代 CMS。
+- 吞吐量低:低停顿时间是以牺牲吞吐量为代价的,导致 CPU 利用率不够高;
+- 无法处理浮动垃圾,可能出现 Concurrent Mode Failure。浮动垃圾是指并发清除阶段由于用户线程继续运行而产生的垃圾,这部分垃圾只能到下一次 GC 时才能进行回收。由于浮动垃圾的存在,因此需要预留出一部分内存,意味着 CMS 收集不能像其它收集器那样等待老年代快满的时候再回收。如果预留的内存不够存放浮动垃圾,就会出现 Concurrent Mode Failure,这时虚拟机将临时启用 Serial Old 来替代 CMS;
- 标记 - 清除算法导致的空间碎片,往往出现老年代空间剩余,但无法找到足够大连续空间来分配当前对象,不得不提前触发一次 Full GC。
#### 7. G1 收集器
@@ -432,7 +433,7 @@ G1 把堆划分成多个大小相等的独立区域(Region),新生代和

-通过引入 Region 的概念,从而将原来的一整块内存空间划分成多个的小空间,使得每个小空间可以单独进行垃圾回收。这种划分方法带来了很大的灵活性,使得可预测的停顿时间模型成为可能。通过记录每个 Region 垃圾回收时间以及回收所获得的空间(这两个值是通过过去回收的经验获得),并维护一个优先列表,每次根据允许的收集时间,优先回收价值最大的 Region。
+通过引入 Region 的概念,从而将原来的一整块内存空间划分成多个的小空间,使得每个小空间可以单独进行垃圾收集。这种划分方法带来了很大的灵活性,使得可预测的停顿时间模型成为可能。通过记录每个 Region 的回收时间以及回收所获得的空间(这两个值是通过过去回收的经验获得),并维护一个优先列表,每次根据允许的收集时间,优先回收价值最大的 Region。
每个 Region 都有一个 Remembered Set,用来记录该 Region 对象的引用对象所在的 Region。通过使用 Remembered Set,在做可达性分析的时候就可以避免全堆扫描。
@@ -440,23 +441,23 @@ G1 把堆划分成多个大小相等的独立区域(Region),新生代和
如果不计算维护 Remembered Set 的操作,G1 收集器的运作大致可划分为以下几个步骤:
-- 初始标记:在一次年轻代回收中顺带完成(Concurrent Start),标记 GC Roots 直接关联的对象,需要停顿;
-- 并发标记:与用户线程同时运行,找出老年代中所有存活的对象,期间年轻代回收照常进行;
+- 初始标记:在一次新生代回收中顺带完成(Concurrent Start),标记 GC Roots 直接关联的对象,需要停顿;
+- 并发标记:与用户线程同时运行,找出老年代中所有存活的对象,期间新生代回收照常进行;
- 最终标记(Remark):短暂停顿,处理并发标记期间用户线程修改引用留下的记录,完成标记,并直接回收完全空的 Region;
-- 清理与混合回收:清理(Cleanup)停顿根据各 Region 的回收价值决定是否进入回收阶段;之后的多次混合回收(Mixed)除了年轻代,再挑选一部分垃圾最多的老年代 Region,把其中存活的对象复制出去,每次回收的数量受停顿时间目标(MaxGCPauseMillis,默认 200 ms)限制。
+- 清理与混合回收:清理(Cleanup)停顿根据各 Region 的回收价值决定是否进入回收阶段;之后的多次混合回收(Mixed)除了新生代,再挑选一部分垃圾最多的老年代 Region,把其中存活的对象复制出去,每次回收的数量受停顿时间目标(MaxGCPauseMillis,默认 200 ms)限制。
具备如下特点:
-- 空间整合:整体来看是基于“标记 - 整理”算法实现的收集器,从局部(两个 Region 之间)上来看是基于“复制”算法实现的,这意味着运行期间不会产生内存空间碎片。
+- 空间整合:整体来看是基于“标记 - 整理”算法实现的收集器,从局部(两个 Region 之间)上来看是基于“复制”算法实现的,这意味着运行期间不会产生内存空间碎片;
- 可预测的停顿:能让使用者明确指定在一个长度为 M 毫秒的时间片段内,消耗在 GC 上的时间不得超过 N 毫秒。
-同一个程序(不断分配 1~5 KB 的数组,其中四分之一存活较久)在本机用 JDK 21、128 MB 的堆分别运行,停顿情况如下:
+例如一个不断分配 1~5 KB 的数组、其中四分之一存活较久的程序,用 128 MB 的堆分别运行,停顿情况如下(JDK 21 实测,见[附录 A3](#a3-不同收集器的停顿)):
| 收集器 | 停顿次数 | 停顿总时长 | 最长停顿 |
| --- | --- | --- | --- |
-| Serial | 39 | 121.6 ms | 12.13 ms |
-| Parallel | 75 | 117.7 ms | 6.18 ms |
-| G1 | 88 | 49.1 ms | 2.38 ms |
+| Serial | 39 | 90.4 ms | 9.14 ms |
+| Parallel | 75 | 96.8 ms | 5.16 ms |
+| G1 | 84 | 40.0 ms | 2.01 ms |
G1 停顿的次数更多,但每次都很短,适合对响应时间敏感的服务。
@@ -464,28 +465,27 @@ G1 停顿的次数更多,但每次都很短,适合对响应时间敏感的
ZGC 的目标是让停顿时间不随堆的大小增长,JDK 15 起可以用于生产(JEP 377),JDK 21 加入了分代模式(JEP 439),JDK 23 起分代成为默认模式(JEP 474),JDK 24 移除了不分代的模式(JEP 490)。
-G1 的年轻代回收和混合回收都要在停顿中把存活对象复制到新的 Region,存活对象越多,停顿越长。ZGC 把标记和复制都放到与用户线程并发执行的阶段,停顿中只做扫描 GC Roots 这类少量工作,所以停顿很短,而且与堆的大小无关。
+G1 的新生代回收和混合回收都要在停顿中把存活对象复制到新的 Region,存活对象越多,停顿越长。ZGC 把标记和复制都放到与用户线程并发执行的阶段,停顿中只做扫描 GC Roots 这类少量工作,所以停顿很短,而且与堆的大小无关。
并发复制的难点在于,对象被移走时,用户线程手里可能还拿着指向旧地址的引用。ZGC 用着色指针和读屏障解决这个问题:
- 着色指针:ZGC 的对象引用固定为 64 位,除了对象的地址,还用其中几位元数据记录状态,例如对象是否已被标记、引用中的地址是否已经更新,看一眼引用就知道它是否可能指向旧地址;
-- 读屏障:JIT 在每次从堆中读取引用的地方插入一小段检查,发现引用还指向旧地址,就查转发表换成新地址,并把字段中的引用一起改掉,下次再读就不需要修正了。分代 ZGC 还在写入引用的地方加了写屏障,用来记录老年代对象指向年轻代对象的引用。
+- 读屏障:JIT 在每次从堆中读取引用的地方插入一小段检查,发现引用还指向旧地址,就查转发表换成新地址,并把字段中的引用一起改掉,下次再读就不需要修正了。分代 ZGC 还在写入引用的地方加了写屏障,用来记录老年代对象指向新生代对象的引用。
-同一个程序在本机用 JDK 21 的分代 ZGC 运行:
+同一个程序用 JDK 21 的分代 ZGC 运行(见[附录 A3](#a3-不同收集器的停顿)):
| 堆大小 | 停顿次数 | 停顿总时长 | 最长停顿 | 分配停顿(Allocation Stall) |
| --- | --- | --- | --- | --- |
-| 128 MB | 125 | 0.60 ms | 0.016 ms | 46 次,共 108.6 ms,最长 16.5 ms |
-| 512 MB | 43 | 0.27 ms | 0.012 ms | 0 次 |
+| 128 MB | 125 | 0.4 ms | 0.008 ms | 41 次,共 93.5 ms,最长 6.1 ms |
+| 512 MB | 46 | 0.2 ms | 0.009 ms | 0 次 |
-ZGC 的停顿都在 0.03 ms 以内,比 G1 短两个数量级。但堆只有 128 MB 时,程序分配内存的速度超过了并发回收的速度,没有空闲的内存可用,分配内存的线程只能等待回收完成,日志中记为 Allocation Stall,对用户来说与停顿无异。所以使用 ZGC 要给堆留出足够的余量,代价是占用更多的内存,读屏障也会让吞吐量略有下降。
+ZGC 的停顿都在 0.01 ms 以内,比 G1 短两个数量级。但堆只有 128 MB 时,程序分配内存的速度超过了并发回收的速度,没有空闲的内存可用,分配内存的线程只能等待回收完成,日志中记为 Allocation Stall,对用户来说与停顿无异。所以使用 ZGC 要给堆留出足够的余量,代价是占用更多的内存,读屏障也会让吞吐量略有下降。
## 三、内存分配与回收策略
### Minor GC 和 Full GC
-- Minor GC:回收新生代,因为新生代对象存活时间很短,因此 Minor GC 会频繁执行,执行的速度一般也会比较快。
-
+- Minor GC:回收新生代,因为新生代对象存活时间很短,因此 Minor GC 会频繁执行,执行的速度一般也会比较快;
- Full GC:回收老年代和新生代,老年代对象其存活时间长,因此 Full GC 很少执行,执行速度会比 Minor GC 慢很多。
### 内存分配策略
@@ -500,7 +500,7 @@ ZGC 的停顿都在 0.03 ms 以内,比 G1 短两个数量级。但堆只有 12
经常出现大对象会提前触发垃圾收集以获取足够的连续空间分配给大对象。
--XX:PretenureSizeThreshold,大于此值的对象直接在老年代分配,避免在 Eden 和 Survivor 之间的大量内存复制。该参数只对 Serial 和 ParNew 收集器有效。
+-XX:PretenureSizeThreshold,大于此值的对象直接在老年代分配,避免在 Eden 和 Survivor 之间的大量内存复制。该参数只对 Serial 和 ParNew 收集器有效(JDK 21 中 ParNew 已移除,只剩 Serial)。G1 中大小达到 Region 一半的对象称为 Humongous 对象,直接分配在老年代的连续 Region 中。
#### 3. 长期存活的对象进入老年代
@@ -546,7 +546,7 @@ ZGC 的停顿都在 0.03 ms 以内,比 G1 短两个数量级。但堆只有 12
#### 5. Concurrent Mode Failure
-执行 CMS GC 的过程中同时有对象要放入老年代,而此时老年代空间不足(可能是 GC 过程中浮动垃圾过多导致暂时性的空间不足),便会报 Concurrent Mode Failure 错误,并触发 Full GC。
+这一条只针对 CMS,CMS 已在 JDK 14 中移除。执行 CMS GC 的过程中同时有对象要放入老年代,而此时老年代空间不足(可能是 GC 过程中浮动垃圾过多导致暂时性的空间不足),便会报 Concurrent Mode Failure 错误,并触发 Full GC。
## 四、类加载机制
@@ -554,15 +554,15 @@ ZGC 的停顿都在 0.03 ms 以内,比 G1 短两个数量级。但堆只有 12
### 类的生命周期
- 
+ 
包括以下 7 个阶段:
-- **加载(Loading)**
-- **验证(Verification)**
-- **准备(Preparation)**
-- **解析(Resolution)**
-- **初始化(Initialization)**
+- 加载(Loading)
+- 验证(Verification)
+- 准备(Preparation)
+- 解析(Resolution)
+- 初始化(Initialization)
- 使用(Using)
- 卸载(Unloading)
@@ -576,16 +576,16 @@ ZGC 的停顿都在 0.03 ms 以内,比 G1 短两个数量级。但堆只有 12
加载过程完成以下三件事:
-- 通过类的完全限定名称获取定义该类的二进制字节流。
-- 将该字节流表示的静态存储结构转换为方法区的运行时存储结构。
+- 通过类的完全限定名称获取定义该类的二进制字节流;
+- 将该字节流表示的静态存储结构转换为方法区的运行时存储结构;
- 在内存中生成一个代表该类的 Class 对象,作为方法区中该类各种数据的访问入口。
其中二进制字节流可以从以下方式中获取:
-- 从 ZIP 包读取,成为 JAR、EAR、WAR 格式的基础。
-- 从网络中获取,最典型的应用是 Applet。
-- 运行时计算生成,例如动态代理技术,在 java.lang.reflect.Proxy 使用 ProxyGenerator.generateProxyClass 的代理类的二进制字节流。
+- 从 ZIP 包读取,成为 JAR、EAR、WAR 格式的基础;
+- 从网络中获取,最典型的应用是早期的 Applet;
+- 运行时计算生成,例如动态代理技术,在 java.lang.reflect.Proxy 使用 ProxyGenerator.generateProxyClass 的代理类的二进制字节流;
- 由其他文件生成,例如由 JSP 文件生成对应的 Class 类。
#### 2. 验证
@@ -618,7 +618,6 @@ public static final int value = 123;
#### 5. 初始化
-
初始化阶段才真正开始执行类中定义的 Java 程序代码。初始化阶段是虚拟机执行类构造器 <clinit\>() 方法的过程。在准备阶段,类变量已经赋过一次系统要求的初始值,而在初始化阶段,根据程序员通过程序制定的主观计划去初始化类变量和其它资源。
<clinit\>() 是由编译器自动收集类中所有类变量的赋值动作和静态语句块中的语句合并产生的,编译器收集的顺序由语句在源文件中出现的顺序决定。特别注意的是,静态语句块只能访问到定义在它之前的类变量,定义在它之后的类变量只能赋值,不能访问。例如以下代码:
@@ -662,35 +661,30 @@ public static void main(String[] args) {
虚拟机规范中并没有强制约束何时进行加载,但是规范严格规定了有且只有下列六种情况必须对类进行初始化(加载、验证、准备都会随之发生):
-- 遇到 new、getstatic、putstatic、invokestatic 这四条字节码指令时,如果类没有进行过初始化,则必须先触发其初始化。最常见的生成这 4 条指令的场景是:使用 new 关键字实例化对象的时候;读取或设置一个类的静态字段(被 final 修饰、已在编译期把结果放入常量池的静态字段除外)的时候;以及调用一个类的静态方法的时候。
-
-- 使用 java.lang.reflect 包的方法对类进行反射调用的时候,如果类没有进行初始化,则需要先触发其初始化。
-
-- 当初始化一个类的时候,如果发现其父类还没有进行过初始化,则需要先触发其父类的初始化。
-
+- 遇到 new、getstatic、putstatic、invokestatic 这四条字节码指令时,如果类没有进行过初始化,则必须先触发其初始化。最常见的生成这 4 条指令的场景是:使用 new 关键字实例化对象的时候;读取或设置一个类的静态字段(被 final 修饰、已在编译期把结果放入常量池的静态字段除外)的时候;以及调用一个类的静态方法的时候;
+- 使用 java.lang.reflect 包的方法对类进行反射调用的时候,如果类没有进行初始化,则需要先触发其初始化;
+- 当初始化一个类的时候,如果发现其父类还没有进行过初始化,则需要先触发其父类的初始化;
- 当虚拟机启动时,用户需要指定一个要执行的主类(包含 main() 方法的那个类),虚拟机会先初始化这个主类;
-
-- 当使用 JDK 1.7 的动态语言支持时,如果一个 java.lang.invoke.MethodHandle 实例最后的解析结果为 REF_getStatic, REF_putStatic, REF_invokeStatic 的方法句柄,并且这个方法句柄所对应的类没有进行过初始化,则需要先触发其初始化;
-
-- 当一个接口定义了 default 方法时,如果它的实现类发生了初始化,要先初始化这个接口。例如 Impl 同时实现了带 default 方法的 WithDefault 和不带 default 方法的 NoDefault,new Impl() 时在 JDK 21 上依次输出“WithDefault 初始化”“Impl 初始化”,NoDefault 没有被初始化。
+- 当使用 JDK 1.7 的动态语言支持时,如果一个 java.lang.invoke.MethodHandle 实例最后的解析结果为 REF_getStatic、REF_putStatic、REF_invokeStatic 的方法句柄,并且这个方法句柄所对应的类没有进行过初始化,则需要先触发其初始化;
+- 当一个接口定义了 default 方法时,如果它的实现类发生了初始化,要先初始化这个接口。例如 Impl 同时实现了带 default 方法的 WithDefault 和不带 default 方法的 NoDefault,new Impl() 时依次输出“WithDefault 初始化”“Impl 初始化”,NoDefault 没有被初始化(JDK 21 实测)。
#### 2. 被动引用
以上 6 种场景中的行为称为对一个类进行主动引用。除此之外,所有引用类的方式都不会触发初始化,称为被动引用。被动引用的常见例子包括:
-- 通过子类引用父类的静态字段,不会导致子类初始化。
+- 通过子类引用父类的静态字段,不会导致子类初始化:
```java
System.out.println(SubClass.value); // value 字段在 SuperClass 中定义
```
-- 通过数组定义来引用类,不会触发此类的初始化。该过程会对数组类进行初始化,数组类是一个由虚拟机自动生成的、直接继承自 Object 的子类,其中包含了数组的属性和方法。
+- 通过数组定义来引用类,不会触发此类的初始化。该过程会对数组类进行初始化,数组类是一个由虚拟机自动生成的、直接继承自 Object 的子类,其中包含了数组的属性和方法:
```java
SuperClass[] sca = new SuperClass[10];
```
-- 常量在编译阶段会存入调用类的常量池中,本质上并没有直接引用到定义常量的类,因此不会触发定义常量的类的初始化。
+- 常量在编译阶段会存入调用类的常量池中,本质上并没有直接引用到定义常量的类,因此不会触发定义常量的类的初始化:
```java
System.out.println(ConstClass.HELLOWORLD);
@@ -707,16 +701,13 @@ System.out.println(ConstClass.HELLOWORLD);
从 Java 虚拟机的角度来讲,只存在以下两种不同的类加载器:
- 启动类加载器(Bootstrap ClassLoader),使用 C++ 实现,是虚拟机自身的一部分;
-
- 所有其它类的加载器,使用 Java 实现,独立于虚拟机,继承自抽象类 java.lang.ClassLoader。
从 Java 开发人员的角度看,类加载器可以划分得更细致一些:
-- 启动类加载器(Bootstrap ClassLoader)此类加载器负责将存放在 <JRE_HOME\>\lib 目录中的,或者被 -Xbootclasspath 参数所指定的路径中的,并且是虚拟机识别的(仅按照文件名识别,如 rt.jar,名字不符合的类库即使放在 lib 目录中也不会被加载)类库加载到虚拟机内存中。启动类加载器无法被 Java 程序直接引用,用户在编写自定义类加载器时,如果需要把加载请求委派给启动类加载器,直接使用 null 代替即可。
-
-- 扩展类加载器(Extension ClassLoader)这个类加载器是由 ExtClassLoader(sun.misc.Launcher$ExtClassLoader)实现的。它负责将 <JAVA_HOME\>/lib/ext 或者被 java.ext.dir 系统变量所指定路径中的所有类库加载到内存中,开发者可以直接使用扩展类加载器。
-
-- 应用程序类加载器(Application ClassLoader)这个类加载器是由 AppClassLoader(sun.misc.Launcher$AppClassLoader)实现的。由于这个类加载器是 ClassLoader 中的 getSystemClassLoader() 方法的返回值,因此一般称为系统类加载器。它负责加载用户类路径(ClassPath)上所指定的类库,开发者可以直接使用这个类加载器,如果应用程序中没有自定义过自己的类加载器,一般情况下这个就是程序中默认的类加载器。
+- 启动类加载器(Bootstrap ClassLoader):此类加载器负责将存放在 <JRE_HOME\>\lib 目录中的,或者被 -Xbootclasspath 参数所指定的路径中的,并且是虚拟机识别的(仅按照文件名识别,如 rt.jar,名字不符合的类库即使放在 lib 目录中也不会被加载)类库加载到虚拟机内存中。启动类加载器无法被 Java 程序直接引用,用户在编写自定义类加载器时,如果需要把加载请求委派给启动类加载器,直接使用 null 代替即可;
+- 扩展类加载器(Extension ClassLoader):这个类加载器是由 ExtClassLoader(sun.misc.Launcher$ExtClassLoader)实现的。它负责将 <JAVA_HOME\>/lib/ext 或者被 java.ext.dir 系统变量所指定路径中的所有类库加载到内存中,开发者可以直接使用扩展类加载器;
+- 应用程序类加载器(Application ClassLoader):这个类加载器是由 AppClassLoader(sun.misc.Launcher$AppClassLoader)实现的。由于这个类加载器是 ClassLoader 中的 getSystemClassLoader() 方法的返回值,因此一般称为系统类加载器。它负责加载用户类路径(ClassPath)上所指定的类库,开发者可以直接使用这个类加载器,如果应用程序中没有自定义过自己的类加载器,一般情况下这个就是程序中默认的类加载器。
以上是 JDK 8 的情况。JDK 9 引入模块系统后,rt.jar 和 lib/ext 目录都被移除,扩展类加载器被平台类加载器(Platform ClassLoader)取代,负责加载 java.sql 等部分平台模块。三层加载器的父子关系不变,只是加载命名模块中的类时,会直接交给定义该模块的加载器。在 JDK 21 上打印:
@@ -734,7 +725,7 @@ String: null
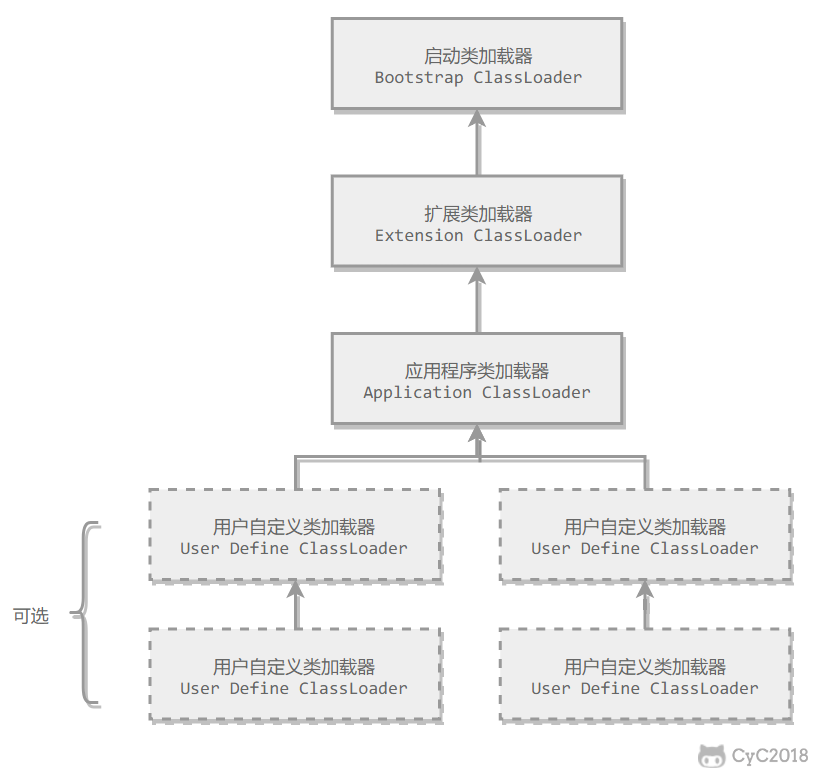
下图展示了类加载器之间的层次关系,称为双亲委派模型(Parents Delegation Model)。该模型要求除了顶层的启动类加载器外,其它的类加载器都要有自己的父类加载器。这里的父子关系一般通过组合关系(Composition)来实现,而不是继承关系(Inheritance)。
- 
+ 
#### 1. 工作过程
@@ -862,14 +853,14 @@ public class FileSystemClassLoader extends ClassLoader {
| -Xlog:gc*:file=gc.log | 输出 GC 日志(JDK 9 起;JDK 8 使用 -XX:+PrintGCDetails -Xloggc:gc.log) |
| -XX:+HeapDumpOnOutOfMemoryError | 内存溢出时保存堆转储 |
-例如一个程序长期持有约 60 MB 的对象,同时不断创建短命的对象。在本机用 JDK 21 和 G1 分别以 72 MB 和 256 MB 的堆运行:
+例如一个程序长期持有约 60 MB 的对象,同时不断创建短命的对象,用 G1 分别以 72 MB 和 256 MB 的堆运行(JDK 21 实测,见[附录 A4](#a4-堆大小对-g1-的影响)):
-| 堆大小 | 年轻代回收 | Full GC | 停顿总时长 | 最长停顿 | 运行时间 |
+| 堆大小 | 新生代回收 | Full GC | 停顿总时长 | 最长停顿 | 运行时间 |
| --- | --- | --- | --- | --- | --- |
-| 72 MB | 449 次 | 6 次 | 195.4 ms | 7.34 ms | 460 ms |
-| 256 MB | 43 次 | 0 次 | 48.1 ms | 1.34 ms | 318 ms |
+| 72 MB | 454 次 | 6 次 | 168.1 ms | 5.88 ms | 398 ms |
+| 256 MB | 43 次 | 0 次 | 42.7 ms | 1.22 ms | 317 ms |
-堆太小时,存活的对象几乎占满了老年代,日志中反复出现 Pause Full (G1 Compaction Pause) 70M->28M(72M):每次 Full GC 后仍有一半以上的空间被占用,很快又满了。
+堆太小时,存活的对象几乎占满了老年代,日志中反复出现 Pause Full (G1 Compaction Pause) 71M->27M(72M):每次 Full GC 后仍有一半以上的空间被占用,很快又满了。
线上频繁 Full GC 的排查思路:
@@ -953,6 +944,90 @@ Found one Java-level deadlock:
后面还会列出这两个线程的调用栈,指出它们在哪一行获取锁。避免死锁的方法见 [计算机操作系统 - 死锁](计算机操作系统%20-%20死锁.md)。
+## 附录:实测
+
+以下实验的环境为 Apple M1 Pro(10 核)、macOS,JDK 为 Adoptium OpenJDK 21.0.13(Temurin)。GC 的停顿次数和时长从 -Xlog:gc 的日志中统计,统计的是所有 Pause 行。
+
+### A1 默认的线程栈大小
+
+```text
+$ java -XX:+PrintFlagsFinal -version | grep ThreadStackSize
+ intx ThreadStackSize = 2048 {pd product} {default}
+```
+
+### A2 逃逸分析
+
+```java
+record Point(int x, int y) {}
+
+static long sum(int n) {
+ long s = 0;
+ for (int i = 0; i < n; i++) {
+ Point p = new Point(i, i + 1); // p 没有离开这个方法
+ s += p.x() + p.y();
+ }
+ return s;
+}
+// main 中调用 20 次 sum(10_000_000),共创建 2 亿个 Point
+```
+
+```text
+$ java -Xlog:gc:file=esc-on.log Escape
+2000000000000000,耗时 130 ms
+$ grep -c Pause esc-on.log
+0
+$ java -XX:-DoEscapeAnalysis -Xlog:gc:file=esc-off.log Escape
+2000000000000000,耗时 335 ms
+$ grep -c Pause esc-off.log
+13
+```
+
+### A3 不同收集器的停顿
+
+测试程序分配 40 万个 1~5 KB 的数组,每 4 个中保留 1 个,保留的数组超过 3 万个时丢弃最早的 1.5 万个:
+
+```java
+for (int i = 0; i < 400_000; i++) {
+ byte[] b = new byte[1024 + r.nextInt(4096)];
+ if (i % 4 == 0) keep.add(b);
+ if (keep.size() > 30_000) keep.subList(0, 15_000).clear();
+}
+```
+
+```text
+$ java -Xmx128m -Xms128m -XX:+UseSerialGC -Xlog:gc:file=UseSerialGC.log GCDemo(Parallel、G1 同理)
+UseSerialGC:停顿 39 次(Young 31,Full 8),共 90.4 ms,最长 9.135 ms
+UseParallelGC:停顿 75 次(Young 56,Full 19),共 96.8 ms,最长 5.157 ms
+UseG1GC:停顿 84 次(Young 64,Full 0),共 40.0 ms,最长 2.011 ms
+[0.020s][info][gc] GC(0) Pause Young (Normal) (G1 Evacuation Pause) 24M->6M(128M) 0.937ms
+
+$ java -Xmx128m -Xms128m -XX:+UseZGC -XX:+ZGenerational -Xlog:gc+phases=info,gc=info:file=zgc-128m.log GCDemo
+ZGC 128m:停顿 125 次,共 0.4 ms,最长 0.008 ms;Allocation Stall 41 次,共 93.5 ms,最长 6.1 ms
+ZGC 512m:停顿 46 次,共 0.2 ms,最长 0.009 ms;Allocation Stall 0 次
+[0.041s][info][gc ] Allocation Stall (main) 0.162ms
+```
+
+### A4 堆大小对 G1 的影响
+
+```java
+Map sessions = new HashMap<>(); // 长期存活约 60 MB
+for (int i = 0; i < 3_000_000; i++) {
+ byte[] tmp = new byte[2048]; // 短命对象
+ if (i % 50 == 0) sessions.put(r.nextInt(30_000), new byte[2048]);
+ tmp[0] = 1;
+}
+```
+
+```text
+$ java -Xmx72m -Xms72m -XX:+UseG1GC -Xlog:gc:file=tune-72m.log Tune
+398 ms
+G1 72m:停顿 512 次(Young 454,Full 6),共 168.1 ms,最长 5.877 ms
+[0.127s][info][gc] GC(50) Pause Full (G1 Compaction Pause) 71M->27M(72M) 3.721ms
+$ java -Xmx256m -Xms256m -XX:+UseG1GC -Xlog:gc:file=tune-256m.log Tune
+317 ms
+G1 256m:停顿 43 次(Young 43,Full 0),共 42.7 ms,最长 1.223 ms
+```
+
## 参考资料
- [Troubleshooting Memory Leaks (Java SE 21)](https://docs.oracle.com/en/java/javase/21/troubleshoot/troubleshooting-memory-leaks.html)
@@ -964,7 +1039,6 @@ Found one Java-level deadlock:
- [Getting Started with the G1 Garbage Collector](http://www.oracle.com/webfolder/technetwork/tutorials/obe/java/G1GettingStarted/index.html)
- [JNI Part1: Java Native Interface Introduction and “Hello World” application](http://electrofriends.com/articles/jni/jni-part1-java-native-interface/)
- [Memory Architecture Of JVM(Runtime Data Areas)](https://hackthejava.wordpress.com/2015/01/09/memory-architecture-by-jvmruntime-data-areas/)
-- [JVM Run-Time Data Areas](https://www.programcreek.com/2013/04/jvm-run-time-data-areas/)
- [Android on x86: Java Native Interface and the Android Native Development Kit](https://web.archive.org/web/20240706002000/https://www.drdobbs.com/architecture-and-design/android-on-x86-java-native-interface-and/240166271)
- [深入理解 JVM(2)——GC 算法与内存分配策略](https://web.archive.org/web/20201120232823/https://crowhawk.github.io/2017/08/10/jvm_2/)
- [深入理解 JVM(3)——7 种垃圾收集器](https://web.archive.org/web/20201120232823/https://crowhawk.github.io/2017/08/15/jvm_3/)
@@ -973,6 +1047,9 @@ Found one Java-level deadlock:
- [Guide to WeakHashMap in Java](http://www.baeldung.com/java-weakhashmap)
- [Tomcat example source code file (ConcurrentCache.java)](https://alvinalexander.com/java/jwarehouse/apache-tomcat-6.0.16/java/org/apache/el/util/ConcurrentCache.java.shtml)
- [Garbage-First (G1) Garbage Collector | Java SE 17 GC Tuning Guide](https://docs.oracle.com/en/java/javase/17/gctuning/garbage-first-g1-garbage-collector1.html)
-- [The Z Garbage Collector | Java SE 21 GC Tuning Guide](https://docs.oracle.com/en/java/javase/21/gctuning/z-garbage-collector.html)
+- [The Z Garbage Collector | Java SE 21 GC Tuning Guide](https://docs.oracle.com/en/java/javase/21/gctuning/z-garbage-collector2.html)
- [JEP 439: Generational ZGC](https://openjdk.org/jeps/439)
- [JEP 490: ZGC: Remove the Non-Generational Mode](https://openjdk.org/jeps/490)
+- [JEP 421: Deprecate Finalization for Removal](https://openjdk.org/jeps/421)
+- [JEP 363: Remove the Concurrent Mark Sweep (CMS) Garbage Collector](https://openjdk.org/jeps/363)
+- [JEP 379: Shenandoah: A Low-Pause-Time Garbage Collector (Production)](https://openjdk.org/jeps/379)
diff --git a/notes/pics/jvm-areas.png b/notes/pics/jvm-areas.png
new file mode 100644
index 00000000..0e61a04e
Binary files /dev/null and b/notes/pics/jvm-areas.png differ
diff --git a/notes/pics/jvm-class-lifecycle.png b/notes/pics/jvm-class-lifecycle.png
new file mode 100644
index 00000000..8bee045b
Binary files /dev/null and b/notes/pics/jvm-class-lifecycle.png differ
diff --git a/notes/pics/jvm-classloaders.png b/notes/pics/jvm-classloaders.png
new file mode 100644
index 00000000..17754bea
Binary files /dev/null and b/notes/pics/jvm-classloaders.png differ
diff --git a/notes/pics/jvm-copying.png b/notes/pics/jvm-copying.png
new file mode 100644
index 00000000..c68b2d77
Binary files /dev/null and b/notes/pics/jvm-copying.png differ
diff --git a/notes/pics/jvm-gc-roots.png b/notes/pics/jvm-gc-roots.png
new file mode 100644
index 00000000..0e48fb89
Binary files /dev/null and b/notes/pics/jvm-gc-roots.png differ
diff --git a/notes/pics/jvm-mark-compact.png b/notes/pics/jvm-mark-compact.png
new file mode 100644
index 00000000..30bb8ec4
Binary files /dev/null and b/notes/pics/jvm-mark-compact.png differ
diff --git a/notes/pics/jvm-mark-sweep.png b/notes/pics/jvm-mark-sweep.png
new file mode 100644
index 00000000..27902b54
Binary files /dev/null and b/notes/pics/jvm-mark-sweep.png differ
diff --git a/notes/pics/jvm-native.png b/notes/pics/jvm-native.png
new file mode 100644
index 00000000..bdff6775
Binary files /dev/null and b/notes/pics/jvm-native.png differ
diff --git a/notes/pics/jvm-stack-frame.png b/notes/pics/jvm-stack-frame.png
new file mode 100644
index 00000000..fc1d086b
Binary files /dev/null and b/notes/pics/jvm-stack-frame.png differ