diff --git a/notes/MySQL.md b/notes/MySQL.md
index abc81758..5b7f2780 100644
--- a/notes/MySQL.md
+++ b/notes/MySQL.md
@@ -9,6 +9,7 @@
* [索引的优点](#索引的优点)
* [索引的使用条件](#索引的使用条件)
* [二、查询性能优化](#二查询性能优化)
+ * [一条 SQL 的执行过程](#一条-sql-的执行过程)
* [使用 Explain 进行分析](#使用-explain-进行分析)
* [优化数据访问](#优化数据访问)
* [重构查询方式](#重构查询方式)
@@ -44,7 +45,7 @@
#### 1. 数据结构
-B Tree 指的是 Balance Tree,也就是平衡树。平衡树是一棵查找树,并且所有叶子节点位于同一层。
+B Tree 是一种多路平衡查找树,每个节点可以有多个子节点,并且所有叶子节点位于同一层。
B+ Tree 是基于 B Tree 和叶子节点顺序访问指针进行实现,它具有 B Tree 的平衡性,并且通过顺序访问指针来提高区间查询的性能。
@@ -56,7 +57,7 @@ B+ Tree 是基于 B Tree 和叶子节点顺序访问指针进行实现,它具
进行查找操作时,首先在根节点进行二分查找,找到一个 key 所在的指针,然后递归地在指针所指向的节点进行查找。直到查找到叶子节点,然后在叶子节点上进行二分查找,找出 key 所对应的 data。
-插入删除操作会破坏平衡树的平衡性,因此在进行插入删除操作之后,需要对树进行分裂、合并、旋转等操作来维护平衡性。
+插入删除操作会破坏平衡树的平衡性,因此在进行插入删除操作之后,需要对节点进行分裂、合并或者从相邻节点借用 key 来维护平衡性。
#### 3. 与红黑树的比较
@@ -66,6 +67,8 @@ B+ Tree 是基于 B Tree 和叶子节点顺序访问指针进行实现,它具
平衡树的树高 O(h)=O(logdN),其中 d 为每个节点的出度。红黑树的出度为 2,而 B+ Tree 的出度一般都非常大,所以红黑树的树高 h 很明显比 B+ Tree 大非常多。
+例如本机 MySQL 8.0 中一张 200 万行的 orders 表(平均每行约 200 字节),从 .ibd 文件中读取主键索引根页的 PAGE_LEVEL,值为 2,也就是树高为 3:根页中有 27 条记录,指向 27 个中间页,叶子页约 2.5 万个,每页约 80 行。查找任意一行只需要读 3 个页,而且根页和中间页通常常驻在缓冲池中,实际最多 1 次磁盘 I/O;换成二叉树,200 万个节点的高度约为 21。
+
(二)磁盘访问原理
操作系统一般将内存和磁盘分割成固定大小的块,每一块称为一页,内存与磁盘以页为单位交换数据。数据库系统将索引的一个节点的大小设置为页的大小,使得一次 I/O 就能完全载入一个节点。
@@ -76,6 +79,12 @@ B+ Tree 是基于 B Tree 和叶子节点顺序访问指针进行实现,它具
为了减少磁盘 I/O 操作,磁盘往往不是严格按需读取,而是每次都会预读。预读过程中,磁盘进行顺序读取,顺序读取不需要进行磁盘寻道,并且只需要很短的磁盘旋转时间,速度会非常快。并且可以利用预读特性,相邻的节点也能够被预先载入。
+#### 4. 与 B Tree 的比较
+
+- B Tree 的每个节点都存放数据,B+ Tree 只有叶子节点存放数据,内部节点只存放 key 和指针,同样大小的页能放下更多的 key,树更矮;
+- B+ Tree 的叶子节点按 key 的顺序用指针连接,范围查询找到起点后顺序扫描叶子节点即可,B Tree 则要在不同层的节点之间来回遍历;
+- B+ Tree 的每次查找都要走到叶子节点,查询的磁盘 I/O 次数稳定。
+
### MySQL 索引
索引是在存储引擎层实现的,而不是在服务器层实现的,所以不同存储引擎具有不同的索引类型和实现。
@@ -214,6 +223,8 @@ WHERE user_id = 5 AND status > 0 AND create_time > '2025-01-05' -- key_len = 5
不过第二条语句的 Extra 为 Using index condition,也就是索引下推:create_time 虽然不能缩小扫描范围,但仍然在索引上过滤,不满足条件的行不需要回表,所以范围条件之后的列并不是完全没有作用。
+例如 `user_id = 1001 AND create_time >= '2025-01-20'` 跳过了 status,只能用 user_id 定位(key_len = 4),user_id 为 1001 的 20 行中只有 3 行满足时间条件。开启索引下推时 Handler_read_next 为 3,用 `SET optimizer_switch='index_condition_pushdown=off'` 关闭后为 20,也就是多回表了 17 次。
+
需要注意的是,是否使用索引是优化器按成本估算决定的。走二级索引的每一行都要回表,匹配的行越多回表越多,超过一定比例后全表扫描反而更快:`create_time > '2025-01-23'` 匹配 9.9 万行,走 idx_create_time;`create_time > '2025-01-02'` 匹配 191 万行,就选择了全表扫描。IN 也一样,`user_id IN` 5 个值时走索引,3 万多个值时全表扫描。因此同一种写法有时走索引有时不走,可能是因为匹配的数据量不同。
### 索引的优点
@@ -238,6 +249,18 @@ WHERE user_id = 5 AND status > 0 AND create_time > '2025-01-05' -- key_len = 5
## 二、查询性能优化
+### 一条 SQL 的执行过程
+
+MySQL 分为 Server 层和存储引擎层:Server 层负责连接、解析、优化和执行,存储引擎负责数据的存储和读取,例如 InnoDB。
+
+
+
+图中的数据来自本机 MySQL 8.0 上 200 万行的 orders 表。优化器并不是“有索引就用”:idx_create_time 也能用于这个查询,但估算要扫描 98 万行、再回表 98 万次,代价比全表扫描还高;联合索引 idx_user_status_time 的第一列就是 user_id,只需要扫描 20 行。用 EXPLAIN 可以看到最终的选择(key: idx_user_status_time,rows: 20),开启 optimizer_trace 可以看到每种方案的估算代价。
+
+需要注意的是,MySQL 5.7 及以前在解析之前还会查询缓存,表一有修改相关的缓存就全部失效,命中率很低,8.0 已经移除了查询缓存。
+
+更新语句的执行过程与查询相同,只是在执行器调用 InnoDB 修改数据时,还要写 undo log、redo log 和 binlog,见下文的 [日志](#七日志)。
+
### 使用 Explain 进行分析
Explain 用来分析 SELECT 查询语句,开发人员可以通过分析 Explain 结果来优化查询语句。
@@ -395,7 +418,7 @@ LIMIT 10;
- 崩溃恢复:MyISAM 崩溃后发生损坏的概率比 InnoDB 高很多,而且恢复的速度也更慢。
-- 其它特性:MyISAM 支持压缩表和空间数据索引。
+- 其它特性:MyISAM 支持压缩表,空间数据索引 InnoDB 从 MySQL 5.7 起也支持。
## 四、数据类型
@@ -403,13 +426,13 @@ LIMIT 10;
TINYINT, SMALLINT, MEDIUMINT, INT, BIGINT 分别使用 8, 16, 24, 32, 64 位存储空间,一般情况下越小的列越好。
-INT(11) 中的数字只是规定了交互工具显示字符的个数,对于存储和计算来说是没有意义的。
+INT(11) 中的数字只是规定了交互工具显示字符的个数,对于存储和计算来说是没有意义的。MySQL 8.0.17 起这种写法已被废弃,建表时会给出警告 Integer display width is deprecated,SHOW CREATE TABLE 中也只显示 int。
### 浮点数
FLOAT 和 DOUBLE 为浮点类型,DECIMAL 为高精度小数类型。CPU 原生支持浮点运算,但是不支持 DECIMAL 类型的计算,因此 DECIMAL 的计算比浮点类型需要更高的代价。
-FLOAT、DOUBLE 和 DECIMAL 都可以指定列宽,例如 DECIMAL(18, 9) 表示总共 18 位,取 9 位存储小数部分,剩下 9 位存储整数部分。
+DECIMAL 可以指定精度,例如 DECIMAL(18, 9) 表示总共 18 位,取 9 位存储小数部分,剩下 9 位存储整数部分。FLOAT 和 DOUBLE 也能写成 FLOAT(7, 4) 这种形式,但 MySQL 8.0.17 起已被废弃。金额等需要精确计算的数据应该使用 DECIMAL。
### 字符串
@@ -425,7 +448,7 @@ MySQL 提供了两种相似的日期时间类型:DATETIME 和 TIMESTAMP。
#### 1. DATETIME
-能够保存从 1000 年到 9999 年的日期和时间,精度为秒,使用 5 字节的存储空间(MySQL 5.6.4 之前为 8 字节)。
+能够保存从 1000 年到 9999 年的日期和时间,精度默认为秒,可以用 DATETIME(6) 精确到微秒,使用 5 字节的存储空间(MySQL 5.6.4 之前为 8 字节),小数部分另外占用 0~3 字节。
它与时区无关。
@@ -451,7 +474,7 @@ TIMESTAMP 比 DATETIME 少占用 1 字节,但是只能表示到 2038 年,需
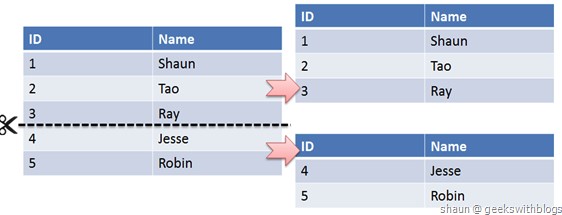
当一个表的数据不断增多时,Sharding 是必然的选择,它可以将数据分布到集群的不同节点上,从而缓解单个数据库的压力。
-
+
### 垂直切分
@@ -459,7 +482,7 @@ TIMESTAMP 比 DATETIME 少占用 1 字节,但是只能表示到 2038 年,需
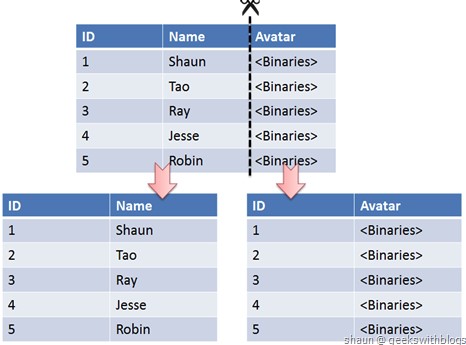
在数据库的层面使用垂直切分将按数据库中表的密集程度部署到不同的库中,例如将原来的电商数据库垂直切分成商品数据库、用户数据库等。
-
+
### Sharding 策略
@@ -493,7 +516,7 @@ TIMESTAMP 比 DATETIME 少占用 1 字节,但是只能表示到 2038 年,需
- **I/O 线程** :负责从主服务器上读取二进制日志,并写入从服务器的中继日志(Relay log)。
- **SQL 线程** :负责读取中继日志,解析出主服务器已经执行的数据更改并在从服务器中重放(Replay)。
-
+
### 读写分离
@@ -502,12 +525,11 @@ TIMESTAMP 比 DATETIME 少占用 1 字节,但是只能表示到 2038 年,需
读写分离能提高性能的原因在于:
- 主从服务器负责各自的读和写,极大程度缓解了锁的争用;
-- 从服务器可以使用 MyISAM,提升查询性能以及节约系统开销;
- 增加冗余,提高可用性。
读写分离常用代理方式来实现,代理服务器接收应用层传来的读写请求,然后决定转发到哪个服务器。
-
+
## 七、日志
@@ -588,3 +610,4 @@ innodb_flush_log_at_trx_commit 和 sync_binlog 的默认值都是 1,也就是
- [MySQL 8.0: Type Conversion in Expression Evaluation](https://dev.mysql.com/doc/refman/8.0/en/type-conversion.html)
- [MySQL 8.0: Redo Log](https://dev.mysql.com/doc/refman/8.0/en/innodb-redo-log.html)
- [MySQL 8.0: The Binary Log](https://dev.mysql.com/doc/refman/8.0/en/binary-log.html)
+- [Replication Implementation | MySQL 8.0 Reference Manual](https://dev.mysql.com/doc/refman/8.0/en/replication-implementation.html)
diff --git a/notes/pics/mysql-replication.png b/notes/pics/mysql-replication.png
new file mode 100644
index 00000000..2424d792
Binary files /dev/null and b/notes/pics/mysql-replication.png differ
diff --git a/notes/pics/mysql-rw-split.png b/notes/pics/mysql-rw-split.png
new file mode 100644
index 00000000..e7562068
Binary files /dev/null and b/notes/pics/mysql-rw-split.png differ
diff --git a/notes/pics/shard-horizontal.png b/notes/pics/shard-horizontal.png
new file mode 100644
index 00000000..9789e3ce
Binary files /dev/null and b/notes/pics/shard-horizontal.png differ
diff --git a/notes/pics/shard-vertical.png b/notes/pics/shard-vertical.png
new file mode 100644
index 00000000..c505cf32
Binary files /dev/null and b/notes/pics/shard-vertical.png differ
diff --git a/notes/pics/sql-flow.png b/notes/pics/sql-flow.png
new file mode 100644
index 00000000..37a4aae6
Binary files /dev/null and b/notes/pics/sql-flow.png differ