diff --git a/notes/分布式.md b/notes/分布式.md
index ee390f9b..5653b23d 100644
--- a/notes/分布式.md
+++ b/notes/分布式.md
@@ -87,7 +87,7 @@ Redis 8.4 新增了 `DELEX lock_key IFEQ unique_value` 指令,可以直接原
- 计算获取锁消耗的时间,只有时间小于锁的过期时间,并且从大多数(N / 2 + 1)实例上获取了锁,才认为获取锁成功;
- 如果获取锁失败,就到每个实例上释放锁。
-RedLock 依赖各个节点的时钟基本同步,并且无法应对进程暂停(例如 GC)导致锁过期后客户端仍然认为自己持有锁的情况,因此存在争议。更可靠的做法是让锁服务返回一个单调递增的令牌(Fencing Token),被访问的资源拒绝令牌更小的请求。
+RedLock 依赖各个节点的时钟基本同步,并且无法应对进程暂停(例如 GC)导致锁过期后客户端仍然认为自己持有锁的情况,因此存在争议。更可靠的做法是让锁服务每次加锁时返回一个单调递增的栅栏令牌(Fencing Token),客户端访问资源时带上令牌,资源拒绝令牌比已处理过的更小的请求。
### Zookeeper 的有序节点
@@ -159,7 +159,9 @@ Zookeeper 提供了一种树形结构的命名空间,/app1/p_1 节点的父节
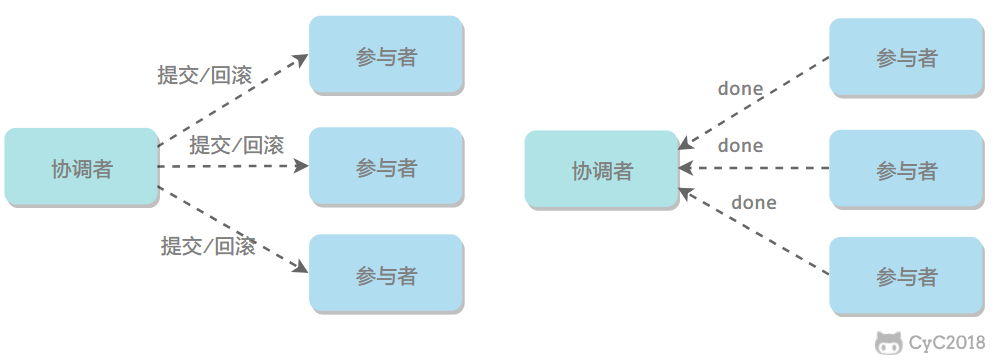
如果事务在每个参与者上都执行成功,事务协调者发送通知让参与者提交事务;否则,协调者发送通知让参与者回滚事务。
-需要注意的是,在准备阶段,参与者执行了事务(写入了 Undo 和 Redo 日志,并且持有锁),但是还未提交。只有在提交阶段接收到协调者发来的通知后,才进行提交或者回滚。
+需要注意的是,在准备阶段,参与者执行了事务(写入了 Undo 和 Redo 日志,并且持有锁),但是还未提交。只有在提交阶段接收到协调者发来的通知后,才进行提交或者回滚。参与者一旦回复同意,就不能再自行回滚,必须等待协调者的决定。
+
+协调者在发送通知之前,必须先把决定写入日志,这样崩溃恢复后才知道该继续提交还是回滚。发送失败或者超时时,协调者会不断重试。
@@ -171,17 +173,17 @@ Zookeeper 提供了一种树形结构的命名空间,/app1/p_1 节点的父节
##### 2.2 单点问题
-协调者在 2PC 中起到非常大的作用,发生故障将会造成很大影响。特别是在提交阶段发生故障,所有参与者会一直同步阻塞等待,无法完成其它操作。
+协调者在 2PC 中起到非常大的作用,发生故障将会造成很大影响。特别是在提交阶段发生故障,已经回复同意的参与者既不能提交也不能回滚(称为存疑事务),只能一直阻塞等待协调者恢复。
##### 2.3 数据不一致
-在提交阶段,如果协调者只发送了部分 Commit 消息,此时网络发生异常,那么只有部分参与者接收到 Commit 消息,也就是说只有部分参与者提交了事务,使得系统数据不一致。
+在提交阶段,如果协调者只发送了部分 Commit 消息就崩溃,那么只有部分参与者提交了事务,其它参与者处于存疑状态,在协调者恢复并重发通知之前,系统数据不一致。
##### 2.4 太过保守
任意一个节点失败就会导致整个事务失败,没有完善的容错机制。
-三阶段提交(3PC)在 2PC 的基础上增加了一个询问阶段(CanCommit),并且在参与者端也引入了超时机制,参与者在等待提交通知超时后会默认提交,从而减少了阻塞,但是仍然可能出现数据不一致。
+三阶段提交(3PC)在 2PC 的基础上增加了一个询问阶段(CanCommit),并且在参与者端也引入了超时机制,参与者在等待提交通知超时后会默认提交,从而减少了阻塞。但是它假设网络延迟有上界,在现实系统中仍然可能出现数据不一致。实践中更好的办法是用共识算法代替单点的协调者。
### TCC
@@ -224,7 +226,7 @@ RocketMQ 的事务消息把本地消息表的工作交给了消息队列:生
## 三、CAP
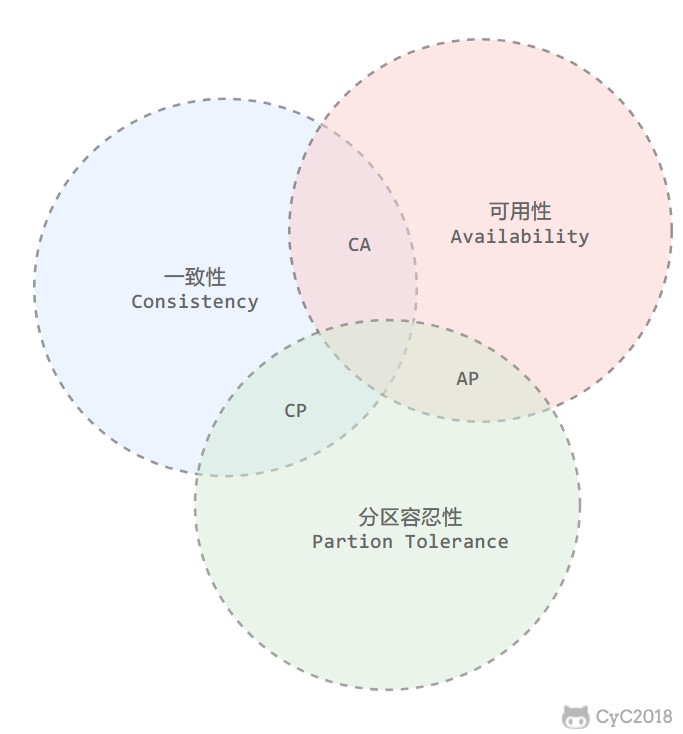
-分布式系统不可能同时满足一致性(C:Consistency)、可用性(A:Availability)和分区容忍性(P:Partition Tolerance),最多只能同时满足其中两项。
+分布式系统不可能同时满足一致性(C:Consistency)、可用性(A:Availability)和分区容忍性(P:Partition Tolerance)。常见的“三选二”说法有误导性,因为网络分区是无法避免的故障,不是可以选择的选项。
@@ -275,7 +277,7 @@ BASE 理论是对 CAP 中一致性和可用性权衡的结果,它的核心思
### 最终一致性
-最终一致性强调的是系统中所有的数据副本,在经过一段时间的同步后,最终能达到一致的状态。
+最终一致性强调的是系统中所有的数据副本,在经过一段时间的同步后,最终能达到一致的状态。“最终”没有时间上限,因此通常还会提供读己之写(用户能读到自己刚写入的数据)和单调读(不会读到比上次更旧的数据)等保证来减少不一致带来的困扰。
ACID 要求强一致性,通常运用在传统的数据库系统上。而 BASE 要求最终一致性,通过牺牲强一致性来达到可用性,通常运用在大型分布式系统中。
@@ -352,7 +354,7 @@ Raft 也是分布式共识算法,相比于 Paxos 更容易理解和实现。
### 单个 Candidate 的竞选
-有三种节点:Follower、Candidate 和 Leader。Raft 把时间划分为多个任期(Term),任期号单调递增,每个任期从一次选举开始。
+有三种节点:Follower、Candidate 和 Leader。Raft 把时间划分为多个任期(Term),任期号单调递增,每个任期从一次选举开始,并且每个任期内最多只有一个 Leader。任期号的作用和 Paxos 中的提议序号相同,发生冲突时任期号大的一方说了算。
Leader 会周期性的发送心跳包给 Follower。每个 Follower 都设置了一个随机的竞选超时时间,一般为 150ms\~300ms,如果在这个时间内没有收到 Leader 的心跳包,就会变成 Candidate,将任期号加 1 并给自己投一票,进入竞选阶段。
@@ -409,6 +411,7 @@ Leader 会周期性的发送心跳包给 Follower。每个 Follower 都设置了
## 参考
- 倪超. 从 Paxos 到 ZooKeeper : 分布式一致性原理与实践 [M]. 电子工业出版社, 2015.
+- [Designing Data-Intensive Applications 中文版](https://github.com/vonng/ddia)
- [Distributed locks with Redis](https://redis.io/topics/distlock)
- [How to do distributed locking](https://martin.kleppmann.com/2016/02/08/how-to-do-distributed-locking.html)
- [Locks and synchronizers - Redisson](https://redisson.pro/docs/data-and-services/locks-and-synchronizers/)