# HTTP
* [HTTP](#http)
* [一、基础概念](#一基础概念)
* [请求和响应报文](#请求和响应报文)
* [URL](#url)
* [二、HTTP 方法](#二http-方法)
* [GET](#get)
* [HEAD](#head)
* [POST](#post)
* [PUT](#put)
* [PATCH](#patch)
* [DELETE](#delete)
* [OPTIONS](#options)
* [CONNECT](#connect)
* [TRACE](#trace)
* [三、HTTP 状态码](#三http-状态码)
* [1XX 信息](#1xx-信息)
* [2XX 成功](#2xx-成功)
* [3XX 重定向](#3xx-重定向)
* [4XX 客户端错误](#4xx-客户端错误)
* [5XX 服务器错误](#5xx-服务器错误)
* [四、HTTP 首部](#四http-首部)
* [通用首部字段](#通用首部字段)
* [请求首部字段](#请求首部字段)
* [响应首部字段](#响应首部字段)
* [实体首部字段](#实体首部字段)
* [五、具体应用](#五具体应用)
* [连接管理](#连接管理)
* [Cookie](#cookie)
* [缓存](#缓存)
* [内容协商](#内容协商)
* [内容编码](#内容编码)
* [范围请求](#范围请求)
* [分块传输编码](#分块传输编码)
* [多部分对象集合](#多部分对象集合)
* [虚拟主机](#虚拟主机)
* [通信数据转发](#通信数据转发)
* [WebSocket](#websocket)
* [跨域](#跨域)
* [六、HTTPS](#六https)
* [加密](#加密)
* [认证](#认证)
* [TLS 握手](#tls-握手)
* [完整性保护](#完整性保护)
* [HTTPS 的缺点](#https-的缺点)
* [七、HTTP/2.0](#七http20)
* [HTTP/1.x 缺陷](#http1x-缺陷)
* [二进制分帧层](#二进制分帧层)
* [服务端推送](#服务端推送)
* [首部压缩](#首部压缩)
* [HTTP/3](#http3)
* [八、HTTP/1.1 新特性](#八http11-新特性)
* [九、GET 和 POST 比较](#九get-和-post-比较)
* [作用](#作用)
* [参数](#参数)
* [安全](#安全)
* [幂等性](#幂等性)
* [可缓存](#可缓存)
* [XMLHttpRequest](#xmlhttprequest)
* [附录:实测](#附录实测)
* [A1 OAuth 2.0 授权码模式](#a1-oauth-20-授权码模式)
* [A2 强缓存与协商缓存](#a2-强缓存与协商缓存)
* [A3 跨域](#a3-跨域)
* [A4 TLS 握手](#a4-tls-握手)
* [A5 XMLHttpRequest 发送 POST](#a5-xmlhttprequest-发送-post)
* [参考资料](#参考资料)
## 一、基础概念
### 请求和响应报文
客户端发送一个请求报文给服务器,服务器根据请求报文中的信息进行处理,并将处理结果放入响应报文中返回给客户端。
请求报文结构:
- 第一行是包含了请求方法、URL、协议版本;
- 接下来的多行都是请求首部 Header,每个首部都有一个首部名称,以及对应的值;
- 一个空行用来分隔首部和内容主体 Body;
- 最后是请求的内容主体,GET 请求通常没有主体,POST 请求的表单数据、JSON 放在这里。
```http
GET http://www.example.com/ HTTP/1.1
Accept: text/html,application/xhtml+xml,application/xml;q=0.9,image/webp,image/apng,*/*;q=0.8,application/signed-exchange;v=b3;q=0.9
Accept-Encoding: gzip, deflate
Accept-Language: zh-CN,zh;q=0.9,en;q=0.8
Cache-Control: max-age=0
Host: www.example.com
If-Modified-Since: Thu, 17 Oct 2019 07:18:26 GMT
If-None-Match: "3147526947+gzip"
Proxy-Connection: keep-alive
Upgrade-Insecure-Requests: 1
User-Agent: Mozilla/5.0 xxx
```
响应报文结构:
- 第一行包含协议版本、状态码以及描述,最常见的是 200 OK 表示请求成功了;
- 接下来多行也是首部内容;
- 一个空行分隔首部和内容主体;
- 最后是响应的内容主体。
```http
HTTP/1.1 200 OK
Age: 529651
Cache-Control: max-age=604800
Connection: keep-alive
Content-Encoding: gzip
Content-Length: 648
Content-Type: text/html; charset=UTF-8
Date: Mon, 02 Nov 2020 17:53:39 GMT
Etag: "3147526947+ident+gzip"
Expires: Mon, 09 Nov 2020 17:53:39 GMT
Keep-Alive: timeout=4
Last-Modified: Thu, 17 Oct 2019 07:18:26 GMT
Proxy-Connection: keep-alive
Server: ECS (sjc/16DF)
Vary: Accept-Encoding
X-Cache: HIT
Example Domain
// 省略...
```
### URL
HTTP 使用 URL(Uniform Resource Locator,统一资源定位符)来定位资源,它是 URI(Uniform Resource Identifier,统一资源标识符)的子集,URL 在 URI 的基础上增加了定位能力。URI 除了包含 URL,还包含 URN(Uniform Resource Name,统一资源名称),它只是用来定义一个资源的名称,并不具备定位该资源的能力。例如 urn:isbn:0451450523 用来定义一个书籍名称,但是却没有表示怎么找到这本书。
## 二、HTTP 方法
客户端发送的请求报文第一行为请求行,包含了方法字段。
### GET
GET 用于获取资源,当前网络请求中绝大部分使用的是 GET 方法。
### HEAD
HEAD 用于获取报文首部,和 GET 方法类似,但是不返回报文实体主体部分。
主要用于确认 URL 的有效性以及资源更新的日期时间等。
### POST
POST 用于传输实体主体,主要用来传输数据,而 GET 主要用来获取资源。
更多 POST 与 GET 的比较请见第九章。
### PUT
PUT 用于创建或者替换目标资源,例如上传文件。它自身不带验证机制,需要配合身份认证使用,否则任何人都可以上传文件。
```http
PUT /new.html HTTP/1.1
Host: example.com
Content-type: text/html
Content-length: 16
New File
```
### PATCH
PATCH 用于对资源进行部分修改。PUT 也可以用于修改资源,但是只能完全替代原始资源,PATCH 允许部分修改。
```http
PATCH /file.txt HTTP/1.1
Host: www.example.com
Content-Type: application/example
If-Match: "e0023aa4e"
Content-Length: 100
[description of changes]
```
### DELETE
DELETE 用于删除资源,与 PUT 功能相反,并且同样不带验证机制。
```http
DELETE /file.html HTTP/1.1
```
### OPTIONS
OPTIONS 用于查询指定的 URL 能够支持的方法。
会返回 `Allow: GET, POST, HEAD, OPTIONS` 这样的内容。
### CONNECT
CONNECT 要求在与代理服务器通信时建立隧道,使用 SSL(Secure Sockets Layer,安全套接层)和 TLS(Transport Layer Security,传输层安全)协议把通信内容加密后经网络隧道传输。
```http
CONNECT www.example.com:443 HTTP/1.1
```
### TRACE
TRACE 用于追踪路径,服务器会将通信路径返回给客户端。
发送请求时,在 Max-Forwards 首部字段中填入数值,每经过一个服务器就会减 1,当数值为 0 时就停止传输。
通常不会使用 TRACE,并且它容易受到 XST 攻击(Cross-Site Tracing,跨站追踪)。
## 三、HTTP 状态码
服务器返回的响应报文中第一行为状态行,包含了状态码以及原因短语,用来告知客户端请求的结果。
| 状态码 | 类别 | 含义 |
| :---: | :---: | :---: |
| 1XX | Informational(信息性状态码) | 接收的请求正在处理 |
| 2XX | Success(成功状态码) | 请求正常处理完毕 |
| 3XX | Redirection(重定向状态码) | 需要进行附加操作以完成请求 |
| 4XX | Client Error(客户端错误状态码) | 服务器无法处理请求 |
| 5XX | Server Error(服务器错误状态码) | 服务器处理请求出错 |
### 1XX 信息
- 100 Continue:表明到目前为止都很正常,客户端可以继续发送请求或者忽略这个响应。
### 2XX 成功
- 200 OK:请求成功;
- 204 No Content:请求已经成功处理,但是返回的响应报文不包含实体的主体部分。一般在只需要从客户端往服务器发送信息,而不需要返回数据时使用;
- 206 Partial Content:表示客户端进行了范围请求,响应报文包含由 Content-Range 指定范围的实体内容。
### 3XX 重定向
- 301 Moved Permanently:永久性重定向;
- 302 Found:临时性重定向;
- 303 See Other:和 302 有着相同的功能,但是 303 明确要求客户端应该采用 GET 方法获取资源;
- 304 Not Modified:GET 或 HEAD 请求带有 If-None-Match 或 If-Modified-Since,资源没有变化时返回 304,不带响应体(If-Match、If-Unmodified-Since 条件不满足时返回的是 412 Precondition Failed);
- 307 Temporary Redirect:临时重定向,与 302 的含义类似,但是 307 要求浏览器不会把重定向请求的 POST 方法改成 GET 方法;
- 308 Permanent Redirect:永久重定向,与 301 的含义类似,但不允许改变请求方法。
需要注意的是,RFC 9110 出于历史原因允许用户代理在 301、302 重定向时把 POST 方法改成 GET 方法,大多数浏览器也是这么做的。如果不希望方法被改变,应该使用 307 或者 308。
### 4XX 客户端错误
- 400 Bad Request:请求报文中存在语法错误;
- 401 Unauthorized:该状态码表示发送的请求需要有认证信息(BASIC 认证、DIGEST 认证)。如果之前已进行过一次请求,则表示用户认证失败;
- 403 Forbidden:请求被拒绝;
- 404 Not Found:服务器上没有找到请求的资源;
- 429 Too Many Requests:请求太频繁,被限流,可以在 Retry-After 首部中告诉客户端多久之后再试。
### 5XX 服务器错误
- 500 Internal Server Error:服务器正在执行请求时发生错误;
- 502 Bad Gateway:作为网关或代理的服务器从上游服务器收到了无效的响应,例如 Nginx 连不上后端,或者后端在返回响应之前断开了连接;
- 503 Service Unavailable:服务器暂时处于超负载或正在进行停机维护,现在无法处理请求;
- 504 Gateway Timeout:作为网关或代理的服务器没有及时收到上游服务器的响应,例如 Nginx 等待后端的时间超过了 proxy_read_timeout(默认 60 秒)。
502 和 504 都说明问题出在网关后面的服务上:502 是后端出错或者不可达,504 是后端太慢,排查时先看网关的错误日志,再看对应时间后端的日志和耗时。
## 四、HTTP 首部
有 4 种类型的首部字段:通用首部字段、请求首部字段、响应首部字段和实体首部字段。
各种首部字段及其含义如下(不需要全记,仅供查阅)。这是《图解 HTTP》按 RFC 2616 的分类,RFC 9110 不再区分实体首部,表中的 Content-MD5、Warning 已被废弃:
### 通用首部字段
| 首部字段名 | 说明 |
| :--: | :--: |
| Cache-Control | 控制缓存的行为 |
| Connection | 控制不再转发给代理的首部字段、管理持久连接|
| Date | 创建报文的日期时间 |
| Pragma | 报文指令 |
| Trailer | 报文末端的首部一览 |
| Transfer-Encoding | 指定报文主体的传输编码方式 |
| Upgrade | 升级为其他协议 |
| Via | 代理服务器的相关信息 |
| Warning | 错误通知 |
### 请求首部字段
| 首部字段名 | 说明 |
| :--: | :--: |
| Accept | 用户代理可处理的媒体类型 |
| Accept-Charset | 优先的字符集 |
| Accept-Encoding | 优先的内容编码 |
| Accept-Language | 优先的语言(自然语言) |
| Authorization | Web 认证信息 |
| Expect | 期待服务器的特定行为 |
| From | 用户的电子邮箱地址 |
| Host | 请求资源所在服务器 |
| If-Match | 比较实体标记(ETag) |
| If-Modified-Since | 比较资源的更新时间 |
| If-None-Match | 比较实体标记(与 If-Match 相反) |
| If-Range | 资源未更新时发送实体 Byte 的范围请求 |
| If-Unmodified-Since | 比较资源的更新时间(与 If-Modified-Since 相反) |
| Max-Forwards | 最大传输逐跳数 |
| Proxy-Authorization | 代理服务器要求客户端的认证信息 |
| Range | 实体的字节范围请求 |
| Referer | 对请求中 URI 的原始获取方 |
| TE | 传输编码的优先级 |
| User-Agent | HTTP 客户端程序的信息 |
### 响应首部字段
| 首部字段名 | 说明 |
| :--: | :--: |
| Accept-Ranges | 是否接受字节范围请求 |
| Age | 推算资源创建经过时间 |
| ETag | 资源的匹配信息 |
| Location | 令客户端重定向至指定 URI |
| Proxy-Authenticate | 代理服务器对客户端的认证信息 |
| Retry-After | 对再次发起请求的时机要求 |
| Server | HTTP 服务器的安装信息 |
| Vary | 代理服务器缓存的管理信息 |
| WWW-Authenticate | 服务器对客户端的认证信息 |
### 实体首部字段
| 首部字段名 | 说明 |
| :--: | :--: |
| Allow | 资源可支持的 HTTP 方法 |
| Content-Encoding | 实体主体适用的编码方式 |
| Content-Language | 实体主体的自然语言 |
| Content-Length | 实体主体的大小 |
| Content-Location | 替代对应资源的 URI |
| Content-MD5 | 实体主体的报文摘要 |
| Content-Range | 实体主体的位置范围 |
| Content-Type | 实体主体的媒体类型 |
| Expires | 实体主体过期的日期时间 |
| Last-Modified | 资源的最后修改日期时间 |
## 五、具体应用
### 连接管理
#### 1. 短连接与长连接
当浏览器访问一个包含多张图片的 HTML 页面时,除了请求访问的 HTML 页面资源,还会请求图片资源。如果每进行一次 HTTP 通信就要新建一个 TCP 连接,那么开销会很大。
长连接只需要建立一次 TCP 连接就能进行多次 HTTP 通信。
- 从 HTTP/1.1 开始默认是长连接的,如果要断开连接,需要由客户端或者服务器端提出断开,使用 `Connection: close`;
- 在 HTTP/1.1 之前默认是短连接的,如果需要使用长连接,则使用 `Connection: Keep-Alive`。
#### 2. 流水线
默认情况下,HTTP 请求是按顺序发出的,下一个请求只有在当前请求收到响应之后才会被发出。由于受到网络延迟和带宽的限制,在下一个请求被发送到服务器之前,可能需要等待很长时间。
流水线是在同一条长连接上连续发出请求,而不用等待响应返回,这样可以减少延迟。但服务器必须按请求的顺序返回响应,前面的响应慢了,后面的都要等待,称为队头阻塞,加上很多代理处理不好流水线,主流浏览器都没有启用它。HTTP/2 用多路复用解决了这个问题,见 [二进制分帧层](#二进制分帧层)。
### Cookie
HTTP 协议是无状态的,主要是为了让 HTTP 协议尽可能简单,使得它能够处理大量事务。可以使用 Cookie 来保存状态信息,Cookie 由 RFC 6265 单独定义,并不是 HTTP/1.1 的一部分。
Cookie 是服务器发送到用户浏览器并保存在本地的一小块数据,它会在浏览器之后向同一服务器再次发起请求时被携带上,用于告知服务端两个请求是否来自同一浏览器。由于之后每次请求都会需要携带 Cookie 数据,因此会带来额外的性能开销(尤其是在移动环境下)。
Cookie 曾一度用于客户端数据的存储,因为当时并没有其它合适的存储办法而作为唯一的存储手段,但现在随着现代浏览器开始支持各种各样的存储方式,Cookie 渐渐被淘汰。新的浏览器 API 已经允许开发者直接将数据存储到本地,如使用 Web storage API(本地存储和会话存储)或 IndexedDB。
#### 1. 用途
- 会话状态管理(如用户登录状态、购物车、游戏分数或其它需要记录的信息);
- 个性化设置(如用户自定义设置、主题等);
- 浏览器行为跟踪(如跟踪分析用户行为等)。
#### 2. 创建过程
服务器发送的响应报文包含 Set-Cookie 首部字段,客户端得到响应报文后把 Cookie 内容保存到浏览器中。
```http
HTTP/1.0 200 OK
Content-type: text/html
Set-Cookie: yummy_cookie=choco
Set-Cookie: tasty_cookie=strawberry
[page content]
```
客户端之后对同一个服务器发送请求时,会从浏览器中取出 Cookie 信息并通过 Cookie 请求首部字段发送给服务器。
```http
GET /sample_page.html HTTP/1.1
Host: www.example.org
Cookie: yummy_cookie=choco; tasty_cookie=strawberry
```
#### 3. 分类
- 会话期 Cookie:浏览器关闭之后它会被自动删除,也就是说它仅在会话期内有效;
- 持久性 Cookie:指定过期时间(Expires)或有效期(max-age)之后就成为了持久性的 Cookie。
```http
Set-Cookie: id=a3fWa; Expires=Wed, 21 Oct 2015 07:28:00 GMT;
```
#### 4. 作用域
Domain 标识指定了哪些主机可以接受 Cookie。如果不指定,默认为当前文档的主机(不包含子域名)。如果指定了 Domain,则一般包含子域名。例如,如果设置 Domain=mozilla.org,则 Cookie 也包含在子域名中(如 developer.mozilla.org)。
Path 标识指定了主机下的哪些路径可以接受 Cookie(该 URL 路径必须存在于请求 URL 中)。以字符 %x2F ("/") 作为路径分隔符,子路径也会被匹配。例如,设置 Path=/docs,则以下地址都会匹配:
- /docs
- /docs/Web/
- /docs/Web/HTTP
#### 5. JavaScript
浏览器通过 `document.cookie` 属性可创建新的 Cookie,也可通过该属性访问非 HttpOnly 标记的 Cookie。
```javascript
document.cookie = "yummy_cookie=choco";
document.cookie = "tasty_cookie=strawberry";
console.log(document.cookie);
```
#### 6. HttpOnly
标记为 HttpOnly 的 Cookie 不能被 JavaScript 脚本调用。跨站脚本攻击(XSS)常常使用 JavaScript 的 `document.cookie` API 窃取用户的 Cookie 信息,因此使用 HttpOnly 标记可以在一定程度上避免 XSS 攻击。
```http
Set-Cookie: id=a3fWa; Expires=Wed, 21 Oct 2015 07:28:00 GMT; Secure; HttpOnly
```
#### 7. Secure
标记为 Secure 的 Cookie 只能通过被 HTTPS 协议加密过的请求发送给服务端。但即便设置了 Secure 标记,敏感信息也不应该通过 Cookie 传输,因为 Cookie 有其固有的不安全性,Secure 标记也无法提供确实的安全保障。
SameSite 属性控制跨站请求是否携带 Cookie,用于防范跨站请求伪造,见 [设置 Cookie 的 SameSite 属性](攻击技术.md#3-设置-cookie-的-samesite-属性)。
#### 8. Session
除了可以将用户信息通过 Cookie 存储在用户浏览器中,也可以利用 Session 存储在服务器端,存储在服务器端的信息更加安全。
Session 可以存储在服务器上的文件、数据库或者内存中。也可以将 Session 存储在 Redis 这种内存型数据库中,效率会更高。
使用 Session 维护用户登录状态的过程如下:
- 用户进行登录时,用户提交包含用户名和密码的表单,放入 HTTP 请求报文中;
- 服务器验证该用户名和密码,如果正确则把用户信息存储到 Redis 中,它在 Redis 中的 Key 称为 Session ID;
- 服务器返回的响应报文的 Set-Cookie 首部字段包含了这个 Session ID,客户端收到响应报文之后将该 Cookie 值存入浏览器中;
- 客户端之后对同一个服务器进行请求时会包含该 Cookie 值,服务器收到之后提取出 Session ID,从 Redis 中取出用户信息,继续之前的业务操作。
应该注意 Session ID 的安全性问题,不能让它被恶意攻击者轻易获取,那么就不能产生一个容易被猜到的 Session ID 值。此外,还需要经常重新生成 Session ID。在对安全性要求极高的场景下,例如转账等操作,除了使用 Session 管理用户状态之外,还需要对用户进行重新验证,比如重新输入密码,或者使用短信验证码等方式。
#### 9. 浏览器禁用 Cookie
此时无法使用 Cookie 来保存用户信息,只能使用 Session。除此之外,不能再将 Session ID 存放到 Cookie 中,而是使用 URL 重写技术,将 Session ID 作为 URL 的参数进行传递。
#### 10. Cookie 与 Session 选择
- Cookie 只能存储 ASCII 码字符串,而 Session 则可以存储任何类型的数据,因此在考虑数据复杂性时首选 Session;
- Cookie 存储在浏览器中,容易被恶意查看。如果非要将一些隐私数据存在 Cookie 中,可以将 Cookie 值进行加密,然后在服务器进行解密;
- 对于大型网站,如果用户所有的信息都存储在 Session 中,那么开销是非常大的,因此不建议将所有的用户信息都存储到 Session 中。
#### 11. JWT
JSON Web Token(JWT)是一种自带签名的令牌。用户登录成功后,服务器把用户 ID、过期时间等信息签名后生成 JWT 返回给客户端,客户端之后在请求的 Authorization 首部中携带它。服务器验证签名,就能确认令牌是自己签发的、内容没有被修改,不需要像 Session 那样在服务器保存会话。
JWT 由三部分组成,用 . 连接:
```http
Authorization: Bearer eyJhbGciOiJIUzI1NiIsInR5cCI6IkpXVCJ9.eyJ1aWQiOjEwMjQsInJvbGUiOiJ1c2VyIiwiZXhwIjoxNzY3MjI1NjAwfQ.35OYguRMXfGxb4cYZPiP9KDH3-Ny6vMNwrPe-lNHBBw
```
- 头部:{"alg":"HS256","typ":"JWT"} 的 Base64URL 编码,表示用 HMAC-SHA256 计算签名;
- 载荷:{"uid":1024,"role":"user","exp":1767225600} 的 Base64URL 编码,exp 是过期时间 2026-01-01 00:00:00(UTC);
- 签名:用只有服务器知道的密钥,对“头部.载荷”计算 HMAC-SHA256。
头部和载荷只是编码而不是加密,任何人都能解码看到内容,所以载荷中不能放密码等敏感信息。签名的作用是防篡改:如果把载荷中的 role 改成 admin,没有密钥就算不出新的签名,服务器按篡改后的内容重新计算的签名与令牌中的不一致,请求会被拒绝:
```text
令牌中的签名 35OYguRMXfGxb4cYZPiP9KDH3-Ny6vMNwrPe-lNHBBw
按篡改后的内容计算 Az4UO74FtqslT1MDLrbi7CMlKtd4KICR1jcwA7rJE4U
```
JWT 与 Session 的区别:
- Session 的状态保存在服务器,删除 Session 就能让用户立即下线;集群中需要共享 Session,见 [集群下的 Session 管理](集群.md#二集群下的-session-管理);
- JWT 的状态保存在令牌中,任何持有密钥的服务都能独立验证,适合多个服务共用登录状态;代价是令牌签发后在过期前一直有效,服务器无法主动让它失效。
无法主动失效是 JWT 最常被追问的问题,常用的解决方法是双令牌:访问令牌(Access Token)的有效期很短,例如 15 分钟,每次请求都携带;刷新令牌(Refresh Token)的有效期较长,服务器记录已签发的刷新令牌,只在访问令牌过期时用它换取新的访问令牌。用户退出或者被封禁时撤销刷新令牌,已经发出的访问令牌最多 15 分钟后自然失效。需要立即失效时,可以把令牌的 ID 放入 Redis 黑名单,过期时间设为令牌的剩余有效期,但这又回到了在服务器保存状态。
令牌在浏览器中的存放位置:放在 localStorage 中,页面上的任何脚本都能读取,一旦存在 XSS 漏洞,令牌就会被盗走;放在 HttpOnly 的 Cookie 中,脚本读不到,但浏览器会自动携带 Cookie,需要防范 [跨站请求伪造](攻击技术.md#二跨站请求伪造)。
需要注意的是,服务器验证时要固定使用的签名算法,不能接受头部中 alg 为 none 的令牌;HMAC 的密钥要随机生成,长度不少于 256 位。
JWT 只是令牌的格式,而 OAuth 2.0 是授权框架,规定第三方应用如何获得访问令牌,这个访问令牌可以用 JWT 表示。
#### 12. 单点登录与 OAuth 2.0
单点登录(Single Sign-On, SSO)指的是在一个地方登录后,访问同一家公司的多个系统都不需要再登录。
多个系统在同一个父域名下时(a.example.com、b.example.com),把会话的 Cookie 设置为 Domain=example.com 就能共享。域名不同时(shop.com、pay.com),Cookie 无法跨域,需要一个统一的认证中心 sso.example.com:
1. 用户访问 pay.com,pay.com 发现没有会话,重定向到 sso.example.com/login?redirect=https://pay.com/;
2. 用户之前在 shop.com 登录时已经在认证中心登录过,认证中心的域名下有它自己的 Cookie,于是不需要输入密码,直接生成一个一次性的票据,重定向回 https://pay.com/?ticket=ST-1024;
3. pay.com 的后端拿票据向认证中心验证,得到用户信息后建立 pay.com 自己的会话。
票据经过浏览器的地址栏,可能被记录或截获,所以只能使用一次、有效期很短,并且必须由后端去认证中心验证,而不是直接信任。
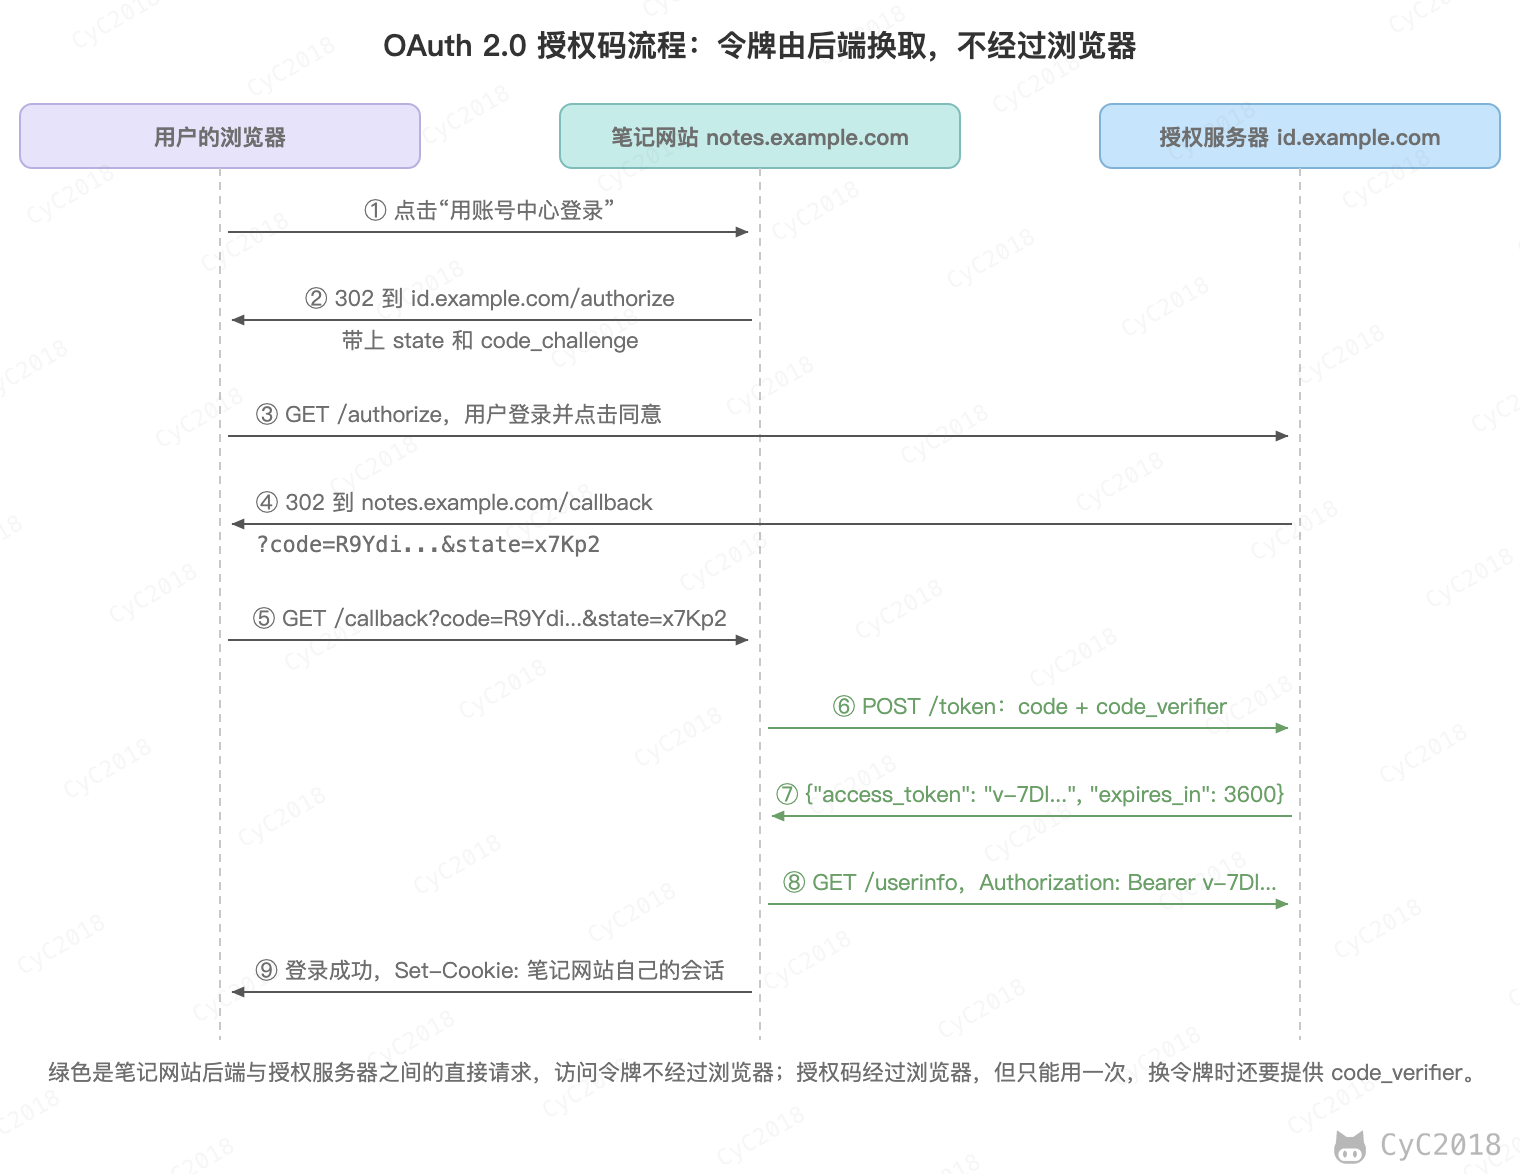
OAuth 2.0 解决的是另一个问题:授权第三方应用访问用户在某个服务上的数据,而不把密码交给它,例如笔记网站读取用户在账号中心的昵称和头像。“用微信登录”这类功能就是基于 OAuth 2.0 实现的,最常用的是授权码模式:
按上图走一遍,第 ① 步之后浏览器访问的地址和第 ⑥ 步笔记网站后端发送的请求如下(用 Python 实现的最小授权服务器实测,见[附录 A1](#a1-oauth-20-授权码模式),域名已替换,省略了部分字段):
```text
GET https://id.example.com/authorize?response_type=code&client_id=notes-app
&redirect_uri=https://notes.example.com/callback&scope=profile&state=x7Kp2
&code_challenge=RQgc0f_GtuKCUitkJiCz7wNdN-_2JLHQ0JGLD9XxGtg&code_challenge_method=S256
POST https://id.example.com/token
grant_type=authorization_code&code=8XNe0QukdUBz_2wmZ34JLA
&redirect_uri=https://notes.example.com/callback&client_id=notes-app
&code_verifier=notes-demo-verifier-0123456789abcdefghijklmnop
{"access_token": "7B0Gmo164bDXm_sgupjN4O9ANvUg1_SK", "token_type": "Bearer", "expires_in": 3600}
```
几个参数的作用:
- code:授权码,经过浏览器传给笔记网站,规范建议最长 10 分钟有效,并且只能使用一次。同一个授权码第二次换令牌时,返回 400 {"error": "invalid_grant"};
- code_verifier 和 code_challenge(PKCE):笔记网站先生成一个随机串 code_verifier,把它的 SHA-256 摘要 code_challenge 放在第一步的地址中,换令牌时再提交原文,授权服务器核对两者是否对应。攻击者即使截获了授权码,没有 code_verifier 也换不到令牌,同样返回 invalid_grant;
- state:笔记网站生成的随机值,回调时检查是否与发出的一致,防止攻击者用自己账号的授权码构造回调地址,让用户登录到攻击者的账号上,这是一种 [CSRF](攻击技术.md#二跨站请求伪造);
- access_token:访问令牌,由笔记网站的后端直接向授权服务器换取,不经过浏览器。
早期还有一种隐式模式,授权服务器直接把访问令牌放在重定向的地址中返回,令牌会出现在浏览器历史记录和日志中。RFC 9700(OAuth 2.0 安全最佳实践)规定不应该再使用隐式模式,没有能力保存密钥的客户端(例如单页应用、手机 App)必须使用 PKCE。
OAuth 2.0 本身只负责授权,访问令牌表示“可以读取昵称”,并不说明当前用户是谁。OpenID Connect 在它的基础上增加了 ID Token,这是一个包含用户 ID 的 JWT,专门用于登录,很多“第三方账号登录”使用的就是它。
扫码登录也是类似的思路,把手机上已有的登录状态安全地交给电脑:
1. 电脑网页向服务器申请一个二维码 ID,状态为“等待扫码”,并开始轮询这个 ID 的状态;
2. 已登录的手机 App 扫码后,带着手机自己的令牌把二维码 ID 发给服务器,状态变为“已扫码”,电脑上显示“请在手机上确认”;
3. 用户在手机上点击确认,服务器为电脑签发一个新的令牌,状态变为“已确认”,电脑轮询拿到令牌后完成登录。
需要注意的是,电脑拿到的是新签发的令牌,而不是手机的令牌;二维码 ID 有效期很短,确认这一步要求用户在手机上手动点击,防止别人把二维码发给用户诱导扫码。
### 缓存
#### 1. 优点
- 缓解服务器压力;
- 降低客户端获取资源的延迟:缓存通常位于内存中,读取缓存的速度更快。并且缓存服务器在地理位置上也有可能比源服务器来得近,例如浏览器缓存。
#### 2. 实现方法
- 让代理服务器进行缓存;
- 让客户端浏览器进行缓存。
#### 3. Cache-Control
HTTP/1.1 通过 Cache-Control 首部字段来控制缓存。
##### 3.1 禁止进行缓存
no-store 指令规定不能对请求或响应的任何一部分进行缓存。
```http
Cache-Control: no-store
```
##### 3.2 强制确认缓存
no-cache 指令规定缓存服务器需要先向源服务器验证缓存资源的有效性,只有当缓存资源有效时才能使用该缓存对客户端的请求进行响应。
```http
Cache-Control: no-cache
```
##### 3.3 私有缓存和公共缓存
private 指令规定了将资源作为私有缓存,只能被单独用户使用,一般存储在用户浏览器中。
```http
Cache-Control: private
```
public 指令规定了将资源作为公共缓存,可以被多个用户使用,一般存储在代理服务器中。
```http
Cache-Control: public
```
##### 3.4 缓存过期机制
max-age 指令出现在请求报文,并且缓存资源的缓存时间小于该指令指定的时间,那么就能接受该缓存。
max-age 指令出现在响应报文,表示缓存资源在缓存服务器中保存的时间。
```http
Cache-Control: max-age=31536000
```
Expires 首部字段也可以用于告知缓存服务器该资源什么时候会过期。
```http
Expires: Wed, 04 Jul 2012 08:26:05 GMT
```
- 在 HTTP/1.1 中,会优先处理 max-age 指令;
- 在 HTTP/1.0 中,max-age 指令会被忽略掉。
#### 4. 缓存验证
需要先了解 ETag 首部字段的含义,它是服务器为资源的某个版本生成的标识,资源的内容变化时 ETag 随之改变。同一个 URL 按内容协商返回不同的版本(例如中文和英文页面)时,每个版本也有各自的 ETag。
```http
ETag: "82e22293907ce725faf67773957acd12"
```
可以将缓存资源的 ETag 值放入 If-None-Match 首部,服务器收到该请求后,判断缓存资源的 ETag 值和资源的最新 ETag 值是否一致,如果一致则表示缓存资源有效,返回 304 Not Modified。
```http
If-None-Match: "82e22293907ce725faf67773957acd12"
```
Last-Modified 首部字段也可以用于缓存验证,它包含在源服务器发送的响应报文中,指示源服务器对资源的最后修改时间。但是它是一种弱校验器,因为只能精确到一秒,所以它通常作为 ETag 的备用方案。如果响应首部字段里含有这个信息,客户端可以在后续的请求中带上 If-Modified-Since 来验证缓存。服务器只在所请求的资源在给定的日期时间之后对内容进行过修改的情况下才会将资源返回,状态码为 200 OK。如果请求的资源从那时起未经修改,那么返回一个不带有实体主体的 304 Not Modified 响应报文。
```http
Last-Modified: Wed, 21 Oct 2015 07:28:00 GMT
```
```http
If-Modified-Since: Wed, 21 Oct 2015 07:28:00 GMT
```
#### 5. 强缓存与协商缓存
浏览器使用缓存分为两种情况:
- 强缓存:缓存还在 max-age 规定的有效期内,直接使用,不发送请求;
- 协商缓存:缓存已经过期,或者响应中有 no-cache,浏览器带上 If-None-Match 或 If-Modified-Since 向服务器确认,资源没有变化就返回 304,只传输首部,浏览器继续使用本地的缓存。
例如 a.js 返回 Cache-Control: max-age=600,b.js 返回 Cache-Control: no-cache,两者都带 ETag,用浏览器打开同一个页面两次,服务器收到的请求如下(Edge 156 实测,见[附录 A2](#a2-强缓存与协商缓存)):
```text
第 1 次 /a.js 无条件请求 -> 200
/b.js 无条件请求 -> 200
第 2 次 /b.js If-None-Match: "b-v1" -> 304
```
第 2 次打开时 a.js 没有发出请求,直接使用了强缓存;b.js 每次都要确认,但内容没有变化时只返回 304。常见的做法是 HTML 使用 no-cache,保证总能拿到最新的页面;JS、CSS 的文件名中带上内容的哈希值,例如 app.3f2a1c.js,设置很长的 max-age,内容变化时文件名随之改变,旧的缓存自然不再被使用。
### 内容协商
通过内容协商返回最合适的内容,例如根据浏览器的默认语言选择返回中文界面还是英文界面。
#### 1. 类型
##### 1.1 服务端驱动型
客户端设置特定的 HTTP 首部字段,例如 Accept、Accept-Charset、Accept-Encoding、Accept-Language,服务器根据这些字段返回特定的资源。
它存在以下问题:
- 服务器很难知道客户端浏览器的全部信息;
- 客户端提供的信息相当冗长(HTTP/2 协议的首部压缩机制缓解了这个问题),并且存在隐私风险(HTTP 指纹识别技术);
- 给定的资源需要返回不同的展现形式,共享缓存的效率会降低,而服务器端的实现会越来越复杂。
##### 1.2 代理驱动型
服务器返回 300 Multiple Choices 或者 406 Not Acceptable,客户端从中选出最合适的那个资源。
#### 2. Vary
```http
Vary: Accept-Language
```
在使用内容协商的情况下,只有当缓存服务器中的缓存满足内容协商条件时,才能使用该缓存,否则应该向源服务器请求该资源。
例如,一个客户端发送了一个包含 Accept-Language 首部字段的请求之后,源服务器返回的响应包含 `Vary: Accept-Language` 内容,缓存服务器对这个响应进行缓存之后,在客户端下一次访问同一个 URL 资源,并且 Accept-Language 与缓存中的对应的值相同时才会返回该缓存。
### 内容编码
内容编码将实体主体进行压缩,从而减少传输的数据量。
常用的内容编码有 gzip、deflate 和 br(Brotli),identity 表示不压缩。较新的浏览器还支持 zstd,例如 Edge 156 发出的请求中带的是 Accept-Encoding: gzip, deflate, br, zstd(见[附录 A5](#a5-xmlhttprequest-发送-post))。
浏览器发送 Accept-Encoding 首部,其中包含有它所支持的压缩算法,以及各自的优先级。服务器则从中选择一种,使用该算法对响应的消息主体进行压缩,并且发送 Content-Encoding 首部来告知浏览器它选择了哪一种算法。由于响应的内容取决于请求中的 Accept-Encoding,响应报文的 Vary 首部字段要包含 Accept-Encoding,否则缓存服务器可能把压缩过的内容返回给不支持该算法的客户端。
### 范围请求
如果网络出现中断,服务器只发送了一部分数据,范围请求可以使得客户端只请求服务器未发送的那部分数据,从而避免服务器重新发送所有数据。
#### 1. Range
在请求报文中添加 Range 首部字段指定请求的范围。
```http
GET /z4d4kWk.jpg HTTP/1.1
Host: i.imgur.com
Range: bytes=0-1023
```
请求成功的话服务器返回的响应包含 206 Partial Content 状态码。
```http
HTTP/1.1 206 Partial Content
Content-Range: bytes 0-1023/146515
Content-Length: 1024
...
(binary content)
```
#### 2. Accept-Ranges
响应首部字段 Accept-Ranges 用于告知客户端是否能处理范围请求,可以处理使用 bytes,否则使用 none。
```http
Accept-Ranges: bytes
```
#### 3. 响应状态码
- 在请求成功的情况下,服务器会返回 206 Partial Content 状态码;
- 在请求的范围越界的情况下,服务器会返回 416 Range Not Satisfiable 状态码;
- 在不支持范围请求的情况下,服务器会返回 200 OK 状态码。
### 分块传输编码
Chunked Transfer Encoding,可以把数据分割成多块,让浏览器逐步显示页面。响应中带有 Transfer-Encoding: chunked 首部,不需要 Content-Length,每一块先写明长度,再写内容,最后以长度为 0 的块结束,适合事先不知道总长度的场景,例如边生成边返回的页面。HTTP/2 有自己的分帧机制,不再使用分块传输编码。
### 多部分对象集合
一份报文主体内可含有多种类型的实体同时发送,每个部分之间用 boundary 字段定义的分隔符进行分隔,每个部分都可以有首部字段。
例如,上传多个表单时可以使用如下方式:
```http
Content-Type: multipart/form-data; boundary=AaB03x
--AaB03x
Content-Disposition: form-data; name="submit-name"
Larry
--AaB03x
Content-Disposition: form-data; name="files"; filename="file1.txt"
Content-Type: text/plain
... contents of file1.txt ...
--AaB03x--
```
### 虚拟主机
HTTP/1.1 使用虚拟主机技术,使得一台服务器拥有多个域名,并且在逻辑上可以看成多个服务器。
### 通信数据转发
#### 1. 代理
代理服务器接受客户端的请求,并且转发给其它服务器。
使用代理的主要目的是:
- 缓存;
- 负载均衡;
- 网络访问控制;
- 访问日志记录。
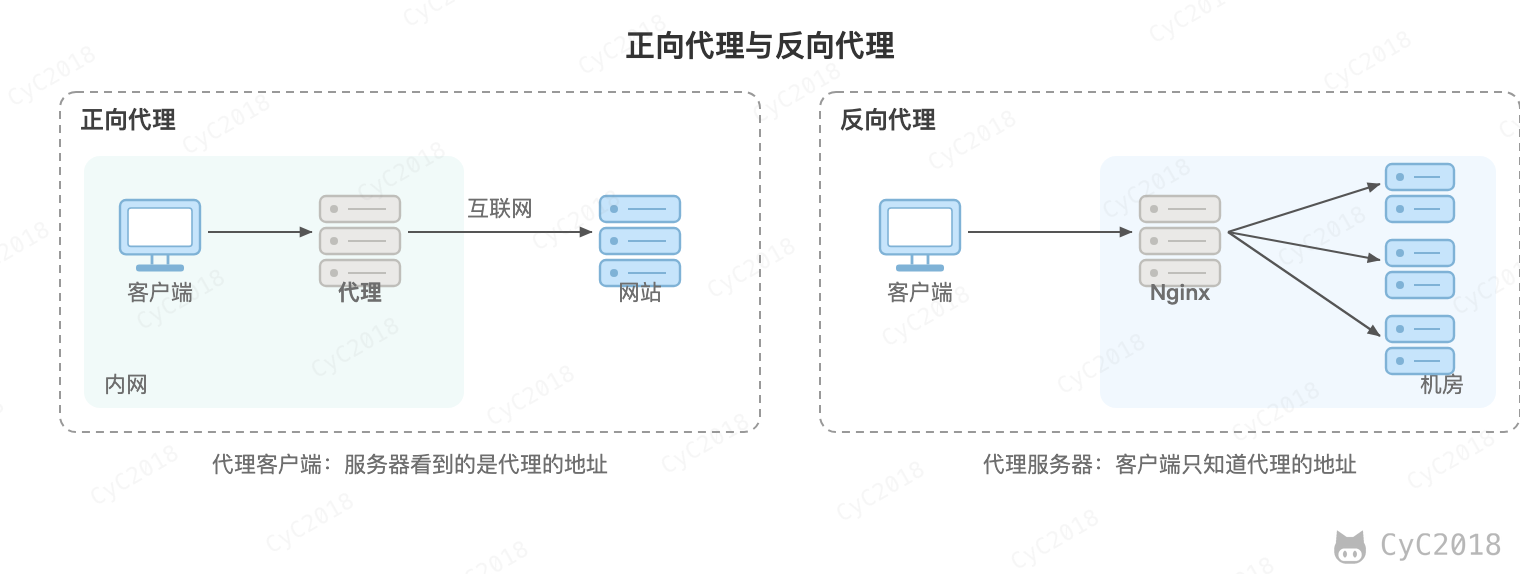
代理服务器分为正向代理和反向代理两种:
- 正向代理代表客户端访问外部的服务器,用户察觉得到它的存在,需要在客户端配置;
- 反向代理代表服务器接收请求,一般位于内部网络中,用户察觉不到。
#### 2. 网关
与代理服务器不同的是,网关服务器会将 HTTP 转化为其它协议进行通信,从而请求其它非 HTTP 服务器的服务。
#### 3. 隧道
使用 SSL 等加密手段,在客户端和服务器之间建立一条安全的通信线路。
### WebSocket
HTTP 是请求-响应模式,服务器不能主动给客户端发消息。聊天、实时通知这类场景以前只能轮询:短轮询定时发请求,大部分请求都是空的;长轮询让服务器挂起请求,直到有新消息再响应,但每条消息仍要一次新的请求。WebSocket 在一个 TCP 连接上提供全双工通信,建立连接后双方随时都可以发送消息。
WebSocket 连接由一次 HTTP 请求升级而来:
```text
GET /chat HTTP/1.1
Host: www.example.com
Upgrade: websocket
Connection: Upgrade
Sec-WebSocket-Key: Y3Mtbm90ZXMtMjAyNi0xMA==
Sec-WebSocket-Version: 13
HTTP/1.1 101 Switching Protocols
Upgrade: websocket
Connection: Upgrade
Sec-WebSocket-Accept: N5dfgp7eKvv+Po1vS+eAAHg5F1I=
```
Sec-WebSocket-Key 是客户端随机生成的 16 字节的 Base64 编码。服务器在它后面拼上协议规定的 GUID 258EAFA5-E914-47DA-95CA-C5AB0DC85B11,计算 SHA-1 后再做 Base64 编码,作为 Sec-WebSocket-Accept 返回,证明自己确实支持 WebSocket,而不是把请求当作普通的 HTTP 请求处理。之后连接上传输的不再是 HTTP 报文,而是 WebSocket 帧,帧头最短只有 2 字节,不用像 HTTP 那样每次都携带首部。
需要注意的是,长时间没有数据时,中间的代理或 NAT 可能会断开空闲的连接,所以通常定时发送 Ping 帧,对方回复 Pong 帧,以此保活并发现已经断开的连接。
SSE(Server-Sent Events)是另一种服务器推送方式:它是一个普通的 HTTP 响应,服务器不断地往响应中写入文本事件,只能由服务器发给客户端,浏览器断开后会自动重连。只需要服务器单向推送时(例如大模型逐字输出),SSE 更简单;客户端和服务器都需要随时发消息时(例如聊天、协同编辑),使用 WebSocket。
### 跨域
同源指的是协议、域名和端口都相同。浏览器的同源策略限制网页中的脚本读取其它源的响应,例如 https://shop.example.com 页面中的脚本请求 https://api.example.com/orders,请求能够发出去,但浏览器默认不把响应交给脚本。
跨域资源共享(Cross-Origin Resource Sharing, CORS)指的是服务器通过响应首部声明允许哪些源读取响应:
```text
GET /orders HTTP/1.1
Host: api.example.com
Origin: https://shop.example.com
HTTP/1.1 200 OK
Access-Control-Allow-Origin: https://shop.example.com
```
GET、HEAD 和表单形式的 POST 这类简单请求直接发送;其它请求,例如 PUT 或者 Content-Type 为 application/json 的 POST,浏览器会先发一个 OPTIONS 预检请求,询问服务器是否允许,允许之后才发送真正的请求:
```text
OPTIONS /orders/1024 HTTP/1.1
Origin: https://shop.example.com
Access-Control-Request-Method: PUT
Access-Control-Request-Headers: content-type
HTTP/1.1 204 No Content
Access-Control-Allow-Origin: https://shop.example.com
Access-Control-Allow-Methods: GET, PUT
Access-Control-Allow-Headers: content-type
Access-Control-Max-Age: 600
```
Access-Control-Max-Age 表示预检结果可以缓存的秒数,期间相同的请求不再预检。跨域请求默认不携带 Cookie,前端设置 credentials: 'include' 后,服务器还要返回 Access-Control-Allow-Credentials: true,并且 Access-Control-Allow-Origin 不能是 *,必须写明具体的源。
用两个端口模拟两个源验证(Edge 156 实测,见[附录 A3](#a3-跨域)):服务器不返回 Access-Control-Allow-Origin 时,fetch 失败,但服务器的日志显示请求已经执行了;预检请求没有允许 PUT 时,浏览器不再发送 PUT;携带 Cookie 而服务器返回 * 时,fetch 同样失败。
需要注意的是,CORS 只决定浏览器是否把响应交给脚本,并不是安全措施:服务器仍然执行了请求,curl 这类不经过浏览器的工具也完全不受限制,权限要靠认证和 [CSRF 防护](攻击技术.md#二跨站请求伪造) 保证。另一种解决跨域的办法是同源的反向代理,例如由 Nginx 把 https://shop.example.com/api 转发给后端,浏览器看到的就是同源的请求。
## 六、HTTPS
HTTP 有以下安全性问题:
- 使用明文进行通信,内容可能会被窃听;
- 不验证通信方的身份,通信方的身份有可能遭遇伪装;
- 无法证明报文的完整性,报文有可能遭篡改。
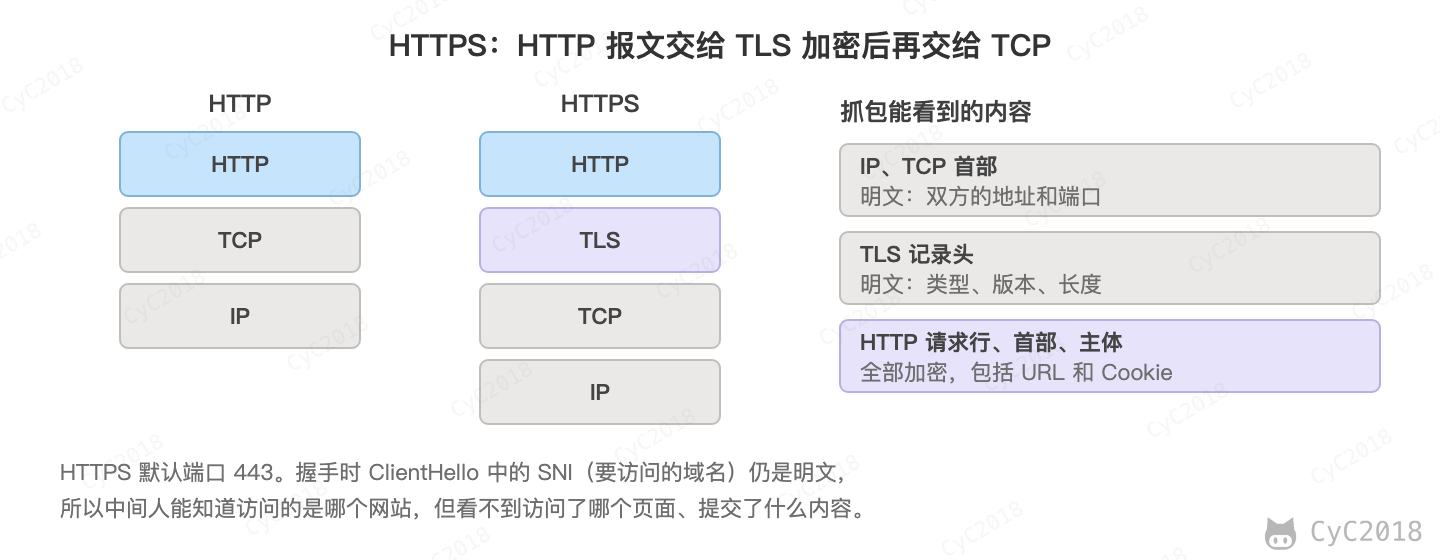
HTTPS 并不是新协议,而是让 HTTP 先和 SSL(Secure Sockets Layer)通信,再由 SSL 和 TCP 通信,也就是说 HTTPS 使用了隧道进行通信。
需要注意的是,SSL 已经被 TLS(Transport Layer Security)取代,SSL 3.0 在 2015 年由 RFC 7568 废弃,现在 HTTPS 实际使用的是 TLS,SSL 只是沿用的叫法。
通过使用 SSL,HTTPS 具有了加密(防窃听)、认证(防伪装)和完整性保护(防篡改)。
### 加密
#### 1. 对称密钥加密
对称密钥加密(Symmetric-Key Encryption),加密和解密使用同一密钥。
- 优点:运算速度快;
- 缺点:无法安全地将密钥传输给通信方。
#### 2. 非对称密钥加密
非对称密钥加密,又称公开密钥加密(Public-Key Encryption),加密和解密使用不同的密钥。
公开密钥所有人都可以获得,通信发送方获得接收方的公开密钥之后,就可以使用公开密钥进行加密,接收方收到通信内容后使用私有密钥解密。
非对称密钥除了用来加密,还可以用来进行签名。因为私有密钥无法被其他人获取,因此通信发送方使用其私有密钥进行签名,通信接收方使用发送方的公开密钥对签名进行验证,就能判断这个签名是否正确。
- 优点:可以更安全地将公开密钥传输给通信发送方;
- 缺点:运算速度慢。
#### 3. HTTPS 采用的加密方式
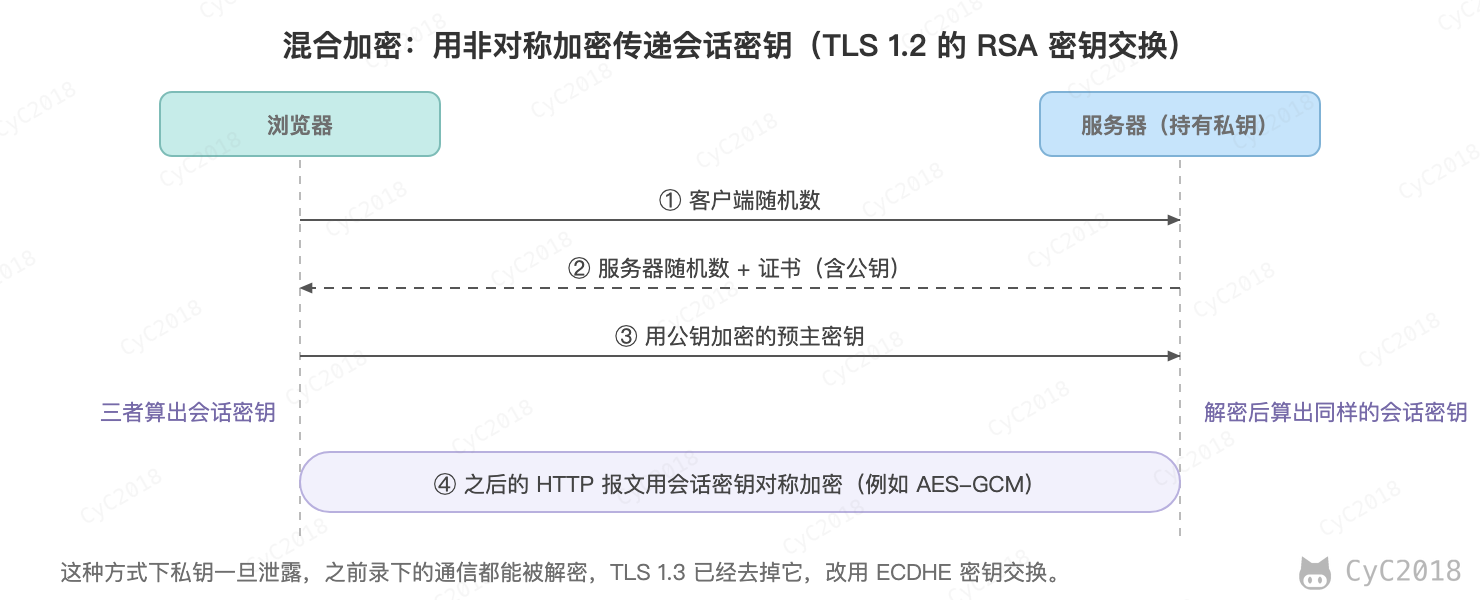
上面提到对称密钥加密方式的传输效率更高,但是无法安全地将密钥 Secret Key 传输给通信方。而非对称密钥加密方式可以保证传输的安全性,因此可以利用非对称密钥加密方式将 Secret Key 传输给通信方。HTTPS 采用混合的加密机制,正是利用了上面提到的方案:
- 使用非对称密钥加密方式,传输对称密钥加密方式所需要的 Secret Key,从而保证安全性;
- 获取到 Secret Key 后,再使用对称密钥加密方式进行通信,从而保证效率(下图中的会话密钥就是 Secret Key)。
需要注意的是,TLS 1.3 不再用公钥加密传输对称密钥,而是通过 ECDHE 密钥交换协商出会话密钥,非对称密钥只用于签名认证。
### 认证
通过使用证书来对通信方进行认证。
数字证书认证机构(CA,Certificate Authority)是客户端与服务器双方都可信赖的第三方机构。
服务器的运营人员向 CA 提出公开密钥的申请,CA 在判明提出申请者的身份之后,会对已申请的公开密钥做数字签名,然后分配这个已签名的公开密钥,并将该公开密钥放入公开密钥证书后绑定在一起。
进行 HTTPS 通信时,服务器会把证书发送给客户端。客户端取得其中的公开密钥之后,先使用数字签名进行验证,如果验证通过,就可以开始通信了。
### TLS 握手
TLS 握手完成三件事:协商加密算法、验证服务器的证书、协商出会话密钥。目前常用的密钥交换方式是 ECDHE:双方各自临时生成一对椭圆曲线密钥,把公钥发给对方,再用自己的私钥和对方的公钥算出相同的共享密钥。会话密钥本身从不在网络上传输,即使服务器的证书私钥日后泄露,之前录下的通信也无法解密,称为前向安全。服务器还要用证书的私钥对握手内容签名,证明自己就是证书的持有者。
下图是用 openssl s_client 连接两个网站时记录的握手报文(见[附录 A4](#a4-tls-握手)):
TLS 1.2 要 2 个 RTT 之后才能发送 HTTP 请求。TLS 1.3 把 ECDHE 公钥直接放在 ClientHello 中,服务器回复 ServerHello 时双方就能算出密钥,之后的握手报文(图中花括号内)都已加密,1 个 RTT 后就能发送请求;TLS 1.3 还去掉了 RSA 密钥交换等不安全的算法。
### 完整性保护
SSL 提供报文摘要功能来进行完整性保护。
HTTP 也提供了 MD5 报文摘要功能,但不是安全的。例如报文内容被篡改之后,同时重新计算 MD5 的值,通信接收方是无法意识到发生了篡改。
HTTPS 的报文摘要功能之所以安全,是因为计算摘要时用到了握手协商出的会话密钥(HMAC,或者 AES-GCM 等算法自带的认证标签)。攻击者没有这个密钥,篡改报文之后无法算出正确的摘要,接收方校验失败就会断开连接。
### HTTPS 的缺点
- 因为需要进行加密解密等过程,因此速度会更慢;
- 需要申请和维护证书,不过 Let's Encrypt 等机构可以免费签发证书。
## 七、HTTP/2.0
### HTTP/1.x 缺陷
HTTP/1.x 实现简单是以牺牲性能为代价的:
- 客户端需要使用多个连接才能实现并发和缩短延迟;
- 不会压缩请求和响应首部,从而导致不必要的网络流量;
- 不支持有效的资源优先级,致使底层 TCP 连接的利用率低下。
### 二进制分帧层
HTTP/2.0 将报文分成 HEADERS 帧和 DATA 帧,它们都是二进制格式的。
在通信过程中,只会有一个 TCP 连接存在,它承载了任意数量的双向数据流(Stream)。
- 一个数据流(Stream)都有一个唯一标识符和可选的优先级信息,用于承载双向信息;
- 消息(Message)是与逻辑请求或响应对应的完整的一系列帧;
- 帧(Frame)是最小的通信单位,来自不同数据流的帧可以交错发送,然后再根据每个帧头的数据流标识符重新组装。
### 服务端推送
HTTP/2.0 在客户端请求一个资源时,会把相关的资源一起发送给客户端,客户端就不需要再次发起请求了。例如客户端请求 page.html 页面,服务端就把 script.js 和 style.css 等与之相关的资源一起发给客户端。
需要注意的是,Chrome 106 起默认禁用了服务端推送,其它基于 Chromium 的浏览器也随之跟进。
### 首部压缩
HTTP/1.1 的首部带有大量信息,而且每次都要重复发送。
HTTP/2.0 要求客户端和服务器同时维护和更新一个包含之前见过的首部字段表,从而避免了重复传输。
不仅如此,HTTP/2.0 也使用 Huffman 编码对首部字段进行压缩。
### HTTP/3
HTTP/2 在一个 TCP 连接上复用多个流,但 TCP 只保证整个字节流按序到达:一个报文段丢失时,后面已经到达的数据也要等它重传,所有的流都被阻塞,称为队头阻塞。
HTTP/3 改为基于 UDP 的 QUIC 协议:
- 每个流单独保证顺序,一个流丢包不影响其它流;
- QUIC 内置了 TLS 1.3,传输层握手和加密握手合并,新连接 1 个 RTT 后就能发送请求,恢复之前的会话时可以 0 RTT;
- 连接用连接 ID 标识,而不是 IP 地址和端口,手机从 Wi-Fi 切换到移动网络时连接不用重建。
浏览器通常先用 HTTP/2 访问,从响应首部 Alt-Svc 得知服务器支持 HTTP/3 后再切换,例如 www.example.com 的响应中有 alt-svc: h3=":443"; ma=86400。
## 八、HTTP/1.1 新特性
与 HTTP/1.0 相比,HTTP/1.1 主要增加了以下特性,详细内容见上文:
- 默认使用长连接;
- 支持流水线;
- 请求必须带 Host 首部,从而支持虚拟主机;
- 新增状态码 100 Continue;
- 支持分块传输编码;
- 新增缓存处理指令 max-age 和条件请求 If-None-Match。
## 九、GET 和 POST 比较
### 作用
GET 用于获取资源,而 POST 用于传输实体主体。
### 参数
GET 和 POST 的请求都能使用额外的参数,但是 GET 的参数是以查询字符串出现在 URL 中,而 POST 的参数存储在实体主体中。不能因为 POST 参数存储在实体主体中就认为它的安全性更高,因为照样可以通过一些抓包工具(Fiddler)查看。
因为 URL 只支持 ASCII 码,因此 GET 的参数中如果存在中文等字符就需要先进行编码。例如 `中文` 会转换为 `%E4%B8%AD%E6%96%87`,而空格会转换为 `%20`。POST 参数支持标准字符集。
```http
GET /test/demo_form.asp?name1=value1&name2=value2 HTTP/1.1
```
```http
POST /test/demo_form.asp HTTP/1.1
Host: w3schools.com
Content-Type: application/x-www-form-urlencoded
name1=value1&name2=value2
```
### 安全
安全的 HTTP 方法不会改变服务器状态,也就是说它只是可读的。
GET 方法是安全的,而 POST 却不是,因为 POST 的目的是传送实体主体内容,这个内容可能是用户上传的表单数据,上传成功之后,服务器可能把这个数据存储到数据库中,因此状态也就发生了改变。
安全的方法除了 GET 之外还有:HEAD、OPTIONS、TRACE。
不安全的方法除了 POST 之外还有 PUT、DELETE。
### 幂等性
幂等的 HTTP 方法,同样的请求被执行一次与连续执行多次的效果是一样的,服务器的状态也是一样的。换句话说就是,幂等方法不应该具有副作用(统计用途除外)。
所有的安全方法也都是幂等的。
在正确实现的条件下,GET、HEAD、PUT 和 DELETE 等方法都是幂等的,而 POST 方法不是。
GET /pageX HTTP/1.1 是幂等的,连续调用多次,客户端接收到的结果都是一样的:
```http
GET /pageX HTTP/1.1
GET /pageX HTTP/1.1
GET /pageX HTTP/1.1
GET /pageX HTTP/1.1
```
POST /add_row HTTP/1.1 不是幂等的,如果调用多次,就会增加多行记录:
```text
POST /add_row HTTP/1.1 -> Adds a 1st row
POST /add_row HTTP/1.1 -> Adds a 2nd row
POST /add_row HTTP/1.1 -> Adds a 3rd row
```
DELETE /idX/delete HTTP/1.1 是幂等的,即使不同的请求接收到的状态码不一样:
```text
DELETE /idX/delete HTTP/1.1 -> Returns 200 if idX exists
DELETE /idX/delete HTTP/1.1 -> Returns 404 as it just got deleted
DELETE /idX/delete HTTP/1.1 -> Returns 404
```
### 可缓存
如果要对响应进行缓存,需要满足以下条件:
- 请求报文的 HTTP 方法本身是可缓存的,包括 GET 和 HEAD,但是 PUT 和 DELETE 不可缓存,POST 在多数情况下不可缓存;
- 响应报文的状态码是可缓存的,包括:200、203、204、206、300、301、308、404、405、410、414 和 501;
- 响应报文的 Cache-Control 首部字段没有指定不进行缓存。
### XMLHttpRequest
XMLHttpRequest 是浏览器提供的 API,用于在不刷新页面的情况下向服务器发送请求,是 AJAX 的基础,现在更常用的是 fetch()。
网上流传一种说法:XMLHttpRequest 发送 POST 时,会先发送首部,再单独发送请求体,GET 则一次发完。HTTP 规范中没有这样的规定,这只是个别浏览器早期的实现细节,不能作为 GET 和 POST 的区别。用 Edge 记录网络日志,通过 XMLHttpRequest 发送一个带 21 字节请求体的 POST 请求,首部和请求体是在同一次 socket 写入中发出的,共 723 字节(Edge 156 实测,见[附录 A5](#a5-xmlhttprequest-发送-post))。
## 附录:实测
以下实验的环境为 Apple M1 Pro、macOS,浏览器为 Edge 156,服务器都是用 Python 标准库 http.server 写的最小实现,运行在 127.0.0.1 上。
### A1 OAuth 2.0 授权码模式
授权服务器监听 9001 端口,笔记网站的回调地址在 9002 端口。授权码 10 分钟过期、只能用一次,换令牌时检查 redirect_uri,并核对 SHA-256(code_verifier) 是否等于第 ① 步的 code_challenge:
```python
verifier_hash = base64.urlsafe_b64encode(hashlib.sha256(q.get("code_verifier", "").encode()).digest()).rstrip(b"=").decode()
if not c or c["exp"] < time.time() or c["redirect_uri"] != q.get("redirect_uri") or c["challenge"] != verifier_hash:
return self._json(400, {"error": "invalid_grant"})
```
```text
① GET http://127.0.0.1:9001/authorize?response_type=code&client_id=notes-app&redirect_uri=http%3A%2F%2F127.0.0.1%3A9002%2Fcallback&scope=profile&state=x7Kp2&code_challenge=RQgc0f_GtuKCUitkJiCz7wNdN-_2JLHQ0JGLD9XxGtg&code_challenge_method=S256
② 302 Location: http://127.0.0.1:9002/callback?code=8XNe0QukdUBz_2wmZ34JLA&state=x7Kp2
③ POST /token grant_type=authorization_code&code=8XNe0QukdUBz_2wmZ34JLA&redirect_uri=http%3A%2F%2F127.0.0.1%3A9002%2Fcallback&client_id=notes-app&code_verifier=notes-demo-verifier-0123456789abcdefghijklmnop
-> {"access_token": "7B0Gmo164bDXm_sgupjN4O9ANvUg1_SK", "token_type": "Bearer", "expires_in": 3600}
④ GET /userinfo -> {"sub": "zhangsan", "name": "张三"}
再用一次同一个授权码 -> 400 {"error": "invalid_grant"}
截获授权码但没有 code_verifier -> 400 {"error": "invalid_grant"}
```
### A2 强缓存与协商缓存
页面引用 a.js 和 b.js,服务器对它们的响应首部分别为 Cache-Control: max-age=600、ETag: "a-v1" 和 Cache-Control: no-cache、ETag: "b-v1",收到的 If-None-Match 与 ETag 相同时返回 304。用 Edge 打开页面两次,服务器的日志:
```text
/ 无条件请求 -> 200
/a.js 无条件请求 -> 200
/b.js 无条件请求 -> 200
/favicon.ico 无条件请求 -> 200
/ 无条件请求 -> 200
/b.js If-None-Match: "b-v1" -> 304
/favicon.ico 无条件请求 -> 200
```
### A3 跨域
页面在 127.0.0.1:8001,接口在 127.0.0.1:8002。/plain 不返回 Access-Control-Allow-Origin;/cors 返回它,但预检时不返回 Access-Control-Allow-Methods;/full 的预检允许 PUT;/star 返回 Access-Control-Allow-Origin: *。用无头模式的 Edge 打开页面,页面中 fetch 的结果和接口服务器的日志:
```text
1 GET no-cors-header FAIL TypeError: Failed to fetch
2 GET with ACAO OK 200 data
3 PUT json, preflight denied FAIL TypeError: Failed to fetch
4 PUT json, preflight allowed OK 200 updated
5 credentials with ACAO * FAIL TypeError: Failed to fetch
API GET /plain {'Origin': 'http://127.0.0.1:8001'}
API GET /cors {'Origin': 'http://127.0.0.1:8001'}
API OPTIONS /cors {'Access-Control-Request-Method': 'PUT', 'Access-Control-Request-Headers': 'content-type', 'Origin': 'http://127.0.0.1:8001'}
API OPTIONS /full {'Access-Control-Request-Method': 'PUT', 'Access-Control-Request-Headers': 'content-type', 'Origin': 'http://127.0.0.1:8001'}
API PUT /full {'Origin': 'http://127.0.0.1:8001'}
API GET /star {'Origin': 'http://127.0.0.1:8001'}
```
第 1 个请求在服务器上已经执行了,只是响应没有交给脚本;第 3 个请求预检之后没有发出 PUT。
### A4 TLS 握手
openssl 为 macOS 自带的 LibreSSL 3.3.6:
```text
$ openssl s_client -connect www.baidu.com:443 -servername www.baidu.com -tls1_2 -msg
>>> TLS 1.3 Handshake [length 00d3], ClientHello
<<< TLS 1.3 Handshake [length 003b], ServerHello
<<< TLS 1.2 Handshake [length 12a3], Certificate
<<< TLS 1.2 Handshake [length 014d], ServerKeyExchange
<<< TLS 1.2 Handshake [length 0004], ServerHelloDone
>>> TLS 1.2 Handshake [length 0046], ClientKeyExchange
>>> TLS 1.2 ChangeCipherSpec [length 0001]
>>> TLS 1.2 Handshake [length 0010], Finished
<<< TLS 1.2 Handshake [length 00aa], NewSessionTicket
<<< TLS 1.2 ChangeCipherSpec [length 0001]
<<< TLS 1.2 Handshake [length 0010], Finished
Protocol : TLSv1.2
$ openssl s_client -connect www.example.com:443 -servername www.example.com -tls1_3 -msg
>>> TLS 1.3 Handshake [length 00ce], ClientHello
<<< TLS 1.3 Handshake [length 007a], ServerHello
<<< TLS 1.3 Handshake [length 000a], EncryptedExtensions
<<< TLS 1.3 Handshake [length 0e66], Certificate
<<< TLS 1.3 Handshake [length 004f], CertificateVerify
<<< TLS 1.3 Handshake [length 0024], Finished
>>> TLS 1.3 Handshake [length 0024], Finished
```
### A5 XMLHttpRequest 发送 POST
页面先用 XMLHttpRequest 发送 GET /api?m=GET,再发送 POST /api?m=POST,请求体为 user=alice&amount=100(21 字节)。Edge 加上 --log-net-log 启动,从日志中取出每次 SOCKET_BYTES_SENT 事件写入的字节数和内容的开头、结尾:
```text
740 b'GET / HTTP/1.1\r\nHost: 127.0.0.1:8770\r\nConnection: keep-alive' ... b'en-US;q=0.5\r\n\r\n'
649 b'GET /api?m=GET HTTP/1.1\r\nHost: 127.0.0.1:8770\r\nConnection: k' ... b'en-US;q=0.5\r\n\r\n'
723 b'POST /api?m=POST HTTP/1.1\r\nHost: 127.0.0.1:8770\r\nConnection:' ... b'q=0.5\r\n\r\nuser=alice&amount=100'
666 b'GET /favicon.ico HTTP/1.1\r\nHost: 127.0.0.1:8770\r\nConnection:' ... b'en-US;q=0.5\r\n\r\n'
```
POST 的首部和请求体在同一次写入中。第一个请求的首部中有 Accept-Encoding: gzip, deflate, br, zstd。
## 参考资料
- [RFC 7519: JSON Web Token (JWT)](https://www.rfc-editor.org/rfc/rfc7519)
- [RFC 6749: The OAuth 2.0 Authorization Framework](https://www.rfc-editor.org/rfc/rfc6749)
- [RFC 7636: Proof Key for Code Exchange (PKCE)](https://www.rfc-editor.org/rfc/rfc7636)
- [RFC 9700: Best Current Practice for OAuth 2.0 Security](https://www.rfc-editor.org/rfc/rfc9700)
- [OWASP: JSON Web Token Cheat Sheet](https://cheatsheetseries.owasp.org/cheatsheets/JSON_Web_Token_Cheat_Sheet.html)
- [OWASP: HTML5 Security Cheat Sheet](https://cheatsheetseries.owasp.org/cheatsheets/HTML5_Security_Cheat_Sheet.html)
- 上野宣. 图解 HTTP [M]. 人民邮电出版社, 2014.
- [High Performance Browser Networking: HTTP/2](https://hpbn.co/http2/)
- [MDN : HTTP](https://developer.mozilla.org/en-US/docs/Web/HTTP)
- [MDN : Cross-Origin Resource Sharing (CORS)](https://developer.mozilla.org/en-US/docs/Web/HTTP/CORS)
- [Difference between file URI and URL in java](https://web.archive.org/web/20191216080403/http://java2db.com:80/java-io/how-to-get-and-the-difference-between-file-uri-and-url-in-java)
- [浅谈 HTTP 中 Get 与 Post 的区别](https://www.cnblogs.com/hyddd/archive/2009/03/31/1426026.html)
- [Are http:// and www really necessary?](https://www.webdancers.com/are-http-and-www-necesary/)
- [HTTP (HyperText Transfer Protocol)](https://www3.ntu.edu.sg/home/ehchua/programming/webprogramming/HTTP_Basics.html)
- [Web-VPN: Secure Proxies with SPDY & Chrome](https://www.igvita.com/2011/12/01/web-vpn-secure-proxies-with-spdy-chrome/)
- [File:HTTP persistent connection.svg](http://en.wikipedia.org/wiki/File:HTTP_persistent_connection.svg)
- [Proxy server](https://en.wikipedia.org/wiki/Proxy_server)
- [What Is This HTTPS/SSL Thing And Why Should You Care?](https://www.x-cart.com/blog/what-is-https-and-ssl.html)
- [Sun Directory Server Enterprise Edition 7.0 Reference - Key Encryption](https://docs.oracle.com/cd/E19424-01/820-4811/6ng8i26bn/index.html)
- [An Introduction to Mutual SSL Authentication](https://www.codeproject.com/Articles/326574/An-Introduction-to-Mutual-SSL-Authentication)
- [The Difference Between URLs and URIs](https://danielmiessler.com/study/url-uri/)
- [Cookie 与 Session 的区别](https://juejin.im/entry/5766c29d6be3ff006a31b84e#comment)
- [COOKIE 和 SESSION 有什么区别](https://www.zhihu.com/question/19786827)
- [Cookie/Session 的机制与安全](https://harttle.land/2015/08/10/cookie-session.html)
- [What is the difference between a URI, a URL and a URN?](https://stackoverflow.com/questions/176264/what-is-the-difference-between-a-uri-a-url-and-a-urn)
- [XMLHttpRequest](https://developer.mozilla.org/zh-CN/docs/Web/API/XMLHttpRequest)
- [XMLHttpRequest (XHR) Uses Multiple Packets for HTTP POST?](https://blog.josephscott.org/2009/08/27/xmlhttprequest-xhr-uses-multiple-packets-for-http-post/)
- [Symmetric vs. Asymmetric Encryption – What are differences?](https://www.ssl2buy.com/wiki/symmetric-vs-asymmetric-encryption-what-are-differences)
- [Web 性能优化与 HTTP/2](https://www.kancloud.cn/digest/web-performance-http2)
- [RFC 8446: The Transport Layer Security (TLS) Protocol Version 1.3](https://www.rfc-editor.org/rfc/rfc8446)
- [RFC 7541: HPACK: Header Compression for HTTP/2](https://www.rfc-editor.org/rfc/rfc7541)
- [RFC 9114: HTTP/3](https://www.rfc-editor.org/rfc/rfc9114)
- [RFC 9000: QUIC](https://www.rfc-editor.org/rfc/rfc9000)
- [RFC 6455: The WebSocket Protocol](https://www.rfc-editor.org/rfc/rfc6455)
- [RFC 9110: HTTP Semantics](https://www.rfc-editor.org/rfc/rfc9110)
- [RFC 9111: HTTP Caching](https://www.rfc-editor.org/rfc/rfc9111)
- [RFC 3986: Uniform Resource Identifier (URI): Generic Syntax](https://www.rfc-editor.org/rfc/rfc3986)
- [RFC 6265: HTTP State Management Mechanism](https://www.rfc-editor.org/rfc/rfc6265)
- [wikipedia:统一资源标志符](https://zh.wikipedia.org/wiki/统一资源标志符)
- [wikipedia: URL](https://en.wikipedia.org/wiki/URL)
- [RFC 9110:4.2.1 http URI Scheme](https://www.rfc-editor.org/rfc/rfc9110#section-4.2.1)
- [RFC 9110:9 Methods](https://www.rfc-editor.org/rfc/rfc9110#section-9)