first commit
This commit is contained in:

@@ -0,0 +1,111 @@
|
||||
## MyBatis 与 Hibernate的区别
|
||||
|
||||
|
||||
## JDBC 和 Hibernate的区别
|
||||
|
||||
|
||||
## Hibernate的原理体系架构
|
||||
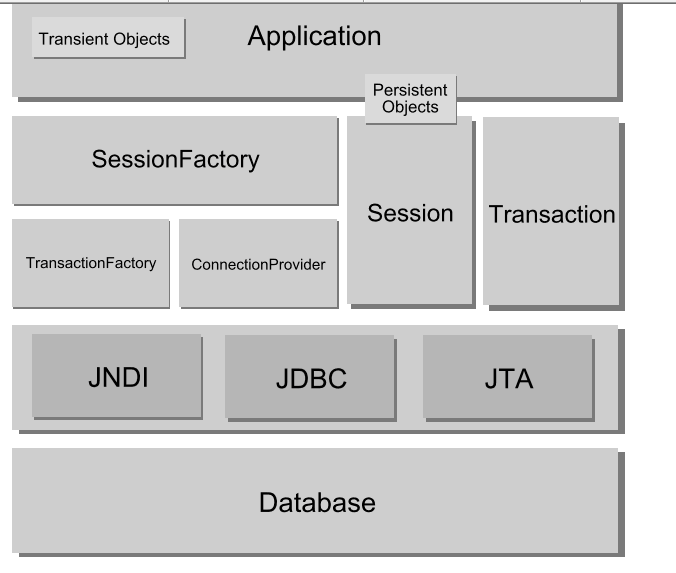
|
||||
**1) SessionFactory (org.hibernate.SessionFactory)**
|
||||
针对单个数据库映射关系经过编译后的内存镜像,是线程安全的(不可变)。它是生成Session的工厂,本身要用到ConnectionProvider。该对象可以在进程或集群的级别上,为那些事务之间可以重用的数据提供可选的二级缓存。
|
||||
**2) Session (org.hibernate.Session)**
|
||||
表示应用程序与持久储存层之间交互操作的一个单线程对象,此对象生存期很短。 其隐藏了JDBC连接,也是Transaction的工厂。其会持有一个针对持久化对象的必选(第一级)缓存,在遍历对象图或者根据持久化标识查找对象时会用到。
|
||||
**3)事务Transaction (org.hibernate.Transaction)**
|
||||
(可选的)应用程序用来指定原子操作单元范围的对象,它是单线程的,生命周期很短。 它通过抽象将应用从底层具体的JDBC、JTA以及CORBA事务隔离开。 某些情况下,一个Session之内可能包含多个Transaction对象。 尽管是否使用该对象是可选的,但无论是使用底层的API还是使用Transaction对象,事务边界的开启与关闭是必不可少的。
|
||||
**4) ConnectionProvider (org.hibernate.connection.ConnectionProvider)**
|
||||
(可选的)生成JDBC连接的工厂(同时也起到连接池的作用)。 它通过抽象将应用从底层的Datasource或DriverManager隔离开。 仅供开发者扩展/实现用,并不暴露给应用程序使用。
|
||||
**5)TransactionFactory (org.hibernate.TransactionFactory)**
|
||||
(可选的)生成Transaction对象实例的工厂。 仅供开发者扩展/实现用,并不暴露给应用程序使用。
|
||||
**6) 持久的对象及其集合**
|
||||
带有持久化状态的、具有业务功能的单线程对象,此对象生存期很短。 这些对象可能是普通的JavaBeans/POJO,唯一特殊的是他们正与(仅仅一个)Session相关联。 一旦这个Session被关闭,这些对象就会脱离持久化状态,这样就可被应用程序的任何层自由使用。 (例如,用作跟表示层打交道的数据传输对象。)
|
||||
**7) 瞬态(transient)和脱管(detached)的对象及其集合**
|
||||
那些目前没有与session关联的持久化类实例。他们可能是在被应用程序实例化后,尚未进行持久化的对象。也可能是因为实例化他们的Session已经被关闭而脱离持久化的对象。
|
||||
|
||||
参考: http://blog.sina.com.cn/s/blog_667fe4a501016awl.html
|
||||
|
||||
## 五大核心接口,
|
||||
Hibernate的核心接口一共有5个,分别为:Session、SessionFactory、Transaction、Query和 Configuration。这5个核心接口在任何开发中都会用到。通过这些接口,不仅可以对持久化对象进行存取,还能够进行事务控制。下面对这五的核心 接口分别加以介绍。
|
||||
**1) Session接口**:
|
||||
Session接口负责执行被持久化对象的CRUD操作(CRUD的任务是完成与数据库的交流,包含了很多常见的 SQL语句。)。但需要注意的是Session对象是非线程安全的。同时,Hibernate的session不同于JSP应用中的HttpSession。这里当使用session这个术语时,其实指的是Hibernate中的session,而以后会将HttpSesion对象称为用户session。
|
||||
**2) SessionFactory接口**
|
||||
SessionFactroy接口负责初始化Hibernate。它充当数据存储源的代理,并负责创建 Session对象。这里用到了工厂模式。需要注意的是SessionFactory并不是轻量级的,因为一般情况下,一个项目通常只需要一个SessionFactory就够,当需要操作多个数据库时,可以为每个数据库指定一个SessionFactory。
|
||||
**3) Configuration接口**
|
||||
Configuration接口负责配置并启动Hibernate,创建SessionFactory对 象。在Hibernate的启动的过程中,Configuration类的实例首先定位映射文档位置、读取配置,然后创建SessionFactory对象。
|
||||
**4) Transaction接口**
|
||||
Transaction接口负责事务相关的操作。它是可选的,开发人员也可以设计编写自己的底层事务处理代码。
|
||||
**5) Query和Criteria接口**:
|
||||
Query和Criteria接口负责执行各种数据库查询。它可以使用HQL语言或SQL语句两种表达方式。
|
||||
|
||||
http://blog.csdn.net/martinmateng/article/details/50879436
|
||||
|
||||
## Hibernate对象的三种状态转换
|
||||
### 1.瞬时状态 (transient)
|
||||
特征:
|
||||
1.不处于Session 缓存中
|
||||
2.数据库中没有对象记录
|
||||
Java如何进入临时状态
|
||||
1.通过new语句刚创建一个对象时
|
||||
2.当调用Session 的delete()方法,从Session 缓存中删除一个对象时。
|
||||
|
||||
### 2.持久化状态(persisted)
|
||||
特征:
|
||||
1.处于Session 缓存中
|
||||
2.持久化对象数据库中设有对象记录
|
||||
3.Session 在特定时刻会保持二者同步
|
||||
Java如何进入持久化状态
|
||||
1.Session 的save()把临时-》持久化状态
|
||||
2.Session 的load(),get()方法返回的对象
|
||||
3.Session 的find()返回的list集合中存放的对象
|
||||
4.ession 的update(),saveOrupdate()使游离-》持久化
|
||||
|
||||
### 3.游离状态(detached)
|
||||
特征:
|
||||
1.不再位于Session 缓存中
|
||||
2.游离对象由持久化状态转变而来,数据库中可能还有对应记录。
|
||||
Java如何进入持久化状态-》游离状态
|
||||
1.Session 的close()方法
|
||||
2.Session 的evict()方法,从缓存中删除一个对象。提高性能。少用。
|
||||
|
||||
## 事务管理
|
||||
|
||||
## Hibernate对一二级缓存的使用
|
||||
(1)一级缓存就是Session级别的缓存,一个Session做了一个查询操作,它会把这个操作的结果放在一级缓存中,如果短时间内这个session(一定要同一个session)又做了同一个操作,那么hibernate直接从一级缓存中拿,而不会再去连数据库,取数据;
|
||||
(2)二级缓存就是SessionFactory级别的缓存,顾名思义,就是查询的时候会把查询结果缓存到二级缓存中,如果同一个sessionFactory创建的某个session执行了相同的操作,hibernate就会从二级缓存中拿结果,而不会再去连接数据库;
|
||||
3)Hibernate中提供了两级Cache,第一级别的缓存是Session级别的缓存,它是属于事务范围的缓存。这一级别的缓存由hibernate管理的,一般情况下无需进行干预;第二级别的缓存是SessionFactory级别的缓存,它是属于进程范围或群集范围的缓存。这一级别的缓存可以进行配置和更改,并且可以动态加载和卸载。Hibernate还为查询结果提供了一个查询缓存,它依赖于第二级缓存;
|
||||
|
||||
http://www.open-open.com/lib/view/open1413527015465.html
|
||||
|
||||
## Lazy-Load的理解
|
||||
在Hibernate框架中,当我们要访问的数据量过大时,明显用缓存不太合适, 因为内存容量有限,为了减少并发量,减少系统资源的消耗,这时Hibernate用懒加载机制来弥补这种缺陷,但是这只是弥补而不是用了懒加载总体性能就提高了。我们所说的懒加载也被称为延迟加载,它在查询的时候不会立刻访问数据库,而是返回代理对象,当真正去使用对象的时候才会访问数据库。
|
||||
1、通过Session.load()实现懒加载
|
||||
load(Object, Serializable):根据id查询。查询返回的是代理对象,不会立刻访问数据库,是懒加载的。当真正去使用对象的时候才会访问数据库。用load()的时候会发现不会打印出查询语句,而使用get()的时候会打印出查询语句。
|
||||
使用load()时如果在session关闭之后再查询此对象,会报异常:could not initialize proxy - no Session。处理办法:在session关闭之前初始化一下查询出来的对象:Hibernate.initialize(user);使用load()可以提高效率,因为刚开始的时候并没有查询数据库。但很少使用。
|
||||
|
||||
2、one-to-one(元素)实现了懒加载。
|
||||
在一对一的时候,查询主对象时默认不是懒加载。即:查询主对象的时候也会把从对象查询出来。需要把主对象配制成lazy="true" constrained="true" fetch="select"。此时查询主对象的时候就不会查询从对象,从而实现了懒加载。一对一的时候,查询从对象的是默认是懒加载。即:查询从对象的时候不会把主对象查询出来。而是查询出来的是主对象的代理对象。
|
||||
|
||||
3、many-to-one(元素)实现了懒加载。
|
||||
多对一的时候,查询主对象时默认是懒加载。即:查询主对象的时候不会把从对象查询出来。
|
||||
|
||||
4、one-to-many(元素)懒加载:默认会懒加载,这是必须的,是重常用的。
|
||||
一对多的时候,查询主对象时默认是懒加载。即:查询主对象的时候不会把从对象查询出来。
|
||||
|
||||
参考: http://blog.csdn.net/sanjy523892105/article/details/7071139
|
||||
http://blog.csdn.net/yaorongwang0521/article/details/7074573
|
||||
|
||||
## 悲观锁和乐观锁
|
||||
**悲观锁 (Pessimistic Locking)**
|
||||
悲观锁,正如其名,他是对数据库而言的,数据库悲观了,他感觉每一个对他操作的程序都有可能产生并发。它指的是对数据被外界(包括本系统当前的其他事务,以及来自外部系统的事务处理)修改持保守态度,因此,在整个数据处理过程中,将数据处于锁定状态。悲观锁的实现,往往依靠数据库提供的锁机制(也只有数据库层提供的锁机制才能真正保证数据访问的排他性,否则,即使在本系统中实现了加锁机制,也无法保证外部系统不会修改数据)
|
||||
|
||||
优点:数据的一致性保持得很好
|
||||
缺点:不适合多个用户并发访问。
|
||||
|
||||
**乐观锁**
|
||||
相对悲观锁而言,乐观锁机制采取了更加宽松的加锁机制。悲观锁大多数情况下依靠数据库的锁机制实现,以保证操作最大程度的独占性。但随之而来的就是数据库性能的大量开销,特别是对长事务而言,这样的开销往往无法承受。乐观锁机制在一定程度上解决了这个问题。乐观锁,大多是基于数据版本(Version)记录机制实现。何谓数据版本?即为数据增加一个版本标识,在基于数据库表的版本解决方案中,一般是通过为数据库表增加一个"version"字段来实现。乐观锁的工作原理:读取出数据时,将此版本号一同读出,之后更新时,对此版本号加一。此时,将提交数据的版本数据与数据库表对应记录的当前版本信息进行比对,如果提交的数据版本号大于数据库表当前版本号,则予以更新,否则认为是过期数据。
|
||||
|
||||
|
||||
个人公众号(欢迎关注):
|
||||

|
||||
|
||||
|
||||
|
||||
@@ -0,0 +1,417 @@
|
||||
## 什么是Spring
|
||||
Spring是一个开源的Java EE开发框架。Spring框架的核心功能可以应用在任何Java应用程序中,但对Java EE平台上的Web应用程序有更好的扩展性。Spring框架的目标是使得Java EE应用程序的开发更加简捷,通过使用POJO为基础的编程模型促进良好的编程风格。
|
||||
|
||||
## Spring有哪些优点
|
||||
**轻量级**:Spring在大小和透明性方面绝对属于轻量级的,基础版本的Spring框架大约只有2MB。
|
||||
**控制反转(IOC)**:Spring使用控制反转技术实现了松耦合。依赖被注入到对象,而不是创建或寻找依赖对象。
|
||||
**面向切面编程(AOP)**: Spring支持面向切面编程,同时把应用的**业务逻辑与系统的服务分离开来**。
|
||||
**容器**:Spring包含并管理应用程序对象的配置及生命周期。
|
||||
**MVC框架**:Spring的web框架是一个设计优良的web MVC框架,很好的取代了一些web框架。
|
||||
**事务管理**:Spring对下至本地业务上至全局业务(JAT)提供了统一的事务管理接口。
|
||||
**异常处理**:Spring提供一个方便的API将特定技术的异常(由JDBC, Hibernate, 或JDO抛出)转化为一致的、Unchecked异常。
|
||||
|
||||
## Spring框架有哪些模块
|
||||
Spring框架至今已集成了20多个模块。这些模块主要被分如下图所示的核心容器、数据访问/集成、Web、AOP(面向切面编程)、工具、消息和测试模块。
|
||||
**核心容器模块**:是spring中最核心的模块。负责Bean的创建,配置和管理。主要包括:beans,core,context,expression等模块。
|
||||
**Spring的AOP模块**:主要负责对面向切面编程的支持,帮助应用对象解耦。
|
||||
**数据访问和集成模块**:包括JDBC,ORM,OXM,JMS和事务处理模块,其细节如下:
|
||||
JDBC模块提供了不再需要冗长的JDBC编码相关了JDBC的抽象层。
|
||||
ORM模块提供的集成层。流行的对象关系映射API,包括JPA,JDO,Hibernate和iBatis。
|
||||
OXM模块提供了一个支持对象/ XML映射实现对JAXB,Castor,使用XMLBeans,JiBX和XStream 的抽象层。
|
||||
Java消息服务JMS模块包含的功能为生产和消费的信息。
|
||||
事务模块支持编程和声明式事务管理实现特殊接口类,并为所有的POJO。
|
||||
**Web和远程调用**:包括web,servlet,struts,portlet模块。
|
||||
**测试模块**:test
|
||||
**工具模块**
|
||||
**消息模块**
|
||||
|
||||
## 什么是控制反转(IOC)?什么是依赖注入?
|
||||
传统模式中对象的调用者需要创建被调用对象,两个对象过于耦合,不利于变化和拓展.在spring中,直接操控的对象的调用权交给容器,通过容器来实现对象组件的装配和管理,从而实现对象之间的松耦合。所谓的“控制反转”概念就是对组件对象控制权的转移,从程序代码本身转移到了外部容器。
|
||||
**依赖注入**:对象无需自行创建或管理它们的依赖关系,IoC容器在运行期间,动态地将某种依赖关系注入到对象之中。依赖注入能让相互协作的软件组件保持松散耦合。
|
||||
|
||||
## BeanFactory和ApplicationContext有什么区别?
|
||||
Bean工厂(BeanFactory)是Spring框架最核心的接口,提供了高级Ioc的配置机制.应用上下文(ApplicationContext)建立在BeanFacotry基础之上,提供了更多面向应用的功能,如果国际化,属性编辑器,事件等等.beanFactory是spring框架的基础设施,是面向spring本身,ApplicationContext是面向使用Spring框架的开发者,几乎所有场合都会用到ApplicationContext.
|
||||
|
||||
## Spring有几种配置方式?
|
||||
将Spring配置到应用开发中有以下三种方式:
|
||||
**基于XML的配置**:
|
||||
**基于注解的配置**: Spring在2.5版本以后开始支持用注解的方式来配置依赖注入。可以用注解的方式来替代XML方式的bean描述,可以将bean描述转移到组件类的内部,只需要在相关类上、方法上或者字段声明上使用注解即可。注解注入将会被容器在XML注入之前被处理,所以后者会覆盖掉前者对于同一个属性的处理结果
|
||||
**基于Java的配置**: Spring对Java配置的支持是由@Configuration注解和@Bean注解来实现的。由@Bean注解的方法将会实例化、配置和初始化一个新对象,这个对象将由Spring的IoC容器来管理。@Bean声明所起到的作用与<bean/> 元素类似。被@Configuration所注解的类则表示这个类的主要目的是作为bean定义的资源。被@Configuration声明的类可以通过在同一个类的内部调用@bean方法来设置嵌入bean的依赖关系。
|
||||
|
||||
## Spring Bean的生命周期
|
||||
|
||||
Bean在Spring中的生命周期如下:
|
||||
**实例化**。Spring通过new关键字将一个Bean进行实例化,JavaBean都有默认的构造函数,因此不需要提供构造参数。
|
||||
**填入属性**。Spring根据xml文件中的配置通过调用Bean中的setXXX方法填入对应的属性。
|
||||
事件通知。Spring依次检查Bean是否实现了BeanNameAware、BeanFactoryAware、ApplicationContextAware、BeanPostProcessor、InitializingBean接口,如果有的话,依次调用这些接口。
|
||||
**使用**。应用程序可以正常使用这个Bean了。
|
||||
**销毁**。如果Bean实现了DisposableBean接口,就调用其destroy方法。
|
||||
|
||||
|
||||
---加载过程---
|
||||
1.容器寻找Bean的定义信息并且将其实例化。
|
||||
2.如果允许提前暴露工厂,则提前暴露这个bean的工厂,这个工厂主要是返回该未完全处理的bean.主要是用于避免单例属性循环依赖问题.
|
||||
3.受用**依赖注入**,Spring按照Bean定义信息配置Bean的所有属性。
|
||||
4.如果Bean实现了**BeanNameAware**接口,工厂调用Bean的**setBeanName()**方法传递Bean的ID。
|
||||
5.如果Bean实现了**BeanFactoryAware**接口,工厂调用**setBeanFactory()**方法传入工厂自身。
|
||||
6.如果**BeanPostProcessor**和Bean关联,那么它们的**postProcessBeforeInitialzation()**方法将被调用。
|
||||
7.如果Bean指定了init-method方法,它将被调用。
|
||||
8.如果有**BeanPostProcessor**和Bean关联,那么它们的postProcessAfterInitialization()方法将被调用
|
||||
9.最后如果配置了destroy-method方法则注册**DisposableBean**.
|
||||
|
||||
到这个时候,Bean已经可以被应用系统使用了,并且将被保留在Bean Factory中知道它不再需要。
|
||||
有两种方法可以把它从Bean Factory中删除掉。
|
||||
1.如果Bean实现了DisposableBean接口,destory()方法被调用。
|
||||
2.如果指定了订制的销毁方法,就调用这个方法。
|
||||
|
||||
## Spring Bean的作用域之间有什么区别
|
||||
singleton:这种bean范围是默认的,这种范围确保不管接受到多少个请求,每个容器中只有一个bean的实例,单例的模式由bean factory自身来维护。
|
||||
prototype:原形范围与单例范围相反,为每一个bean请求提供一个实例。
|
||||
request:在请求bean范围内会每一个来自客户端的网络请求创建一个实例,在请求完成以后,bean会失效并被垃圾回收器回收。
|
||||
Session:与请求范围类似,确保每个session中有一个bean的实例,在session过期后,bean会随之失效。
|
||||
global-session:global-session和Portlet应用相关。当你的应用部署在Portlet容器中工作时,它包含很多portlet。如果你想要声明让所有的portlet共用全局的存储变量的话,那么这全局变量需要存储在global-session中。
|
||||
|
||||
## 请解释自动装配模式的区别
|
||||
**no**:这是Spring框架的默认设置,在该设置下自动装配是关闭的,开发者需要自行在bean定义中用标签明确的设置依赖关系。
|
||||
**byName****:该选项可以根据bean名称设置依赖关系。当向一个bean中自动装配一个属性时,容器将根据bean的名称自动在在配置文件中查询一个匹配的bean。如果找到的话,就装配这个属性,如果没找到的话就报错。
|
||||
**byType**:该选项可以根据bean类型设置依赖关系。当向一个bean中自动装配一个属性时,容器将根据bean的类型自动在在配置文件中查询一个匹配的bean。如果找到的话,就装配这个属性,如果没找到的话就报错。
|
||||
**constructor**:造器的自动装配和byType模式类似,但是仅仅适用于与有构造器相同参数的bean,如果在容器中没有找到与构造器参数类型一致的bean,那么将会抛出异常。
|
||||
**autodetect**:该模式自动探测**使用构造器自动装配或者byType自动装配**。首先,首先会尝试找合适的带参数的构造器,如果找到的话就是用构造器自动装配,如果在bean内部没有找到相应的构造器或者是无参构造器,容器就会自动选择byTpe的自动装配方式。
|
||||
|
||||
## Spring 框架中都用到了哪些设计模式
|
||||
**代理模式**—在AOP和remoting中被用的比较多。
|
||||
**单例模式**—在spring配置文件中定义的bean默认为单例模式。
|
||||
**模板方法**—用来解决代码重复的问题
|
||||
比如. RestTemplate, JmsTemplate, JpaTemplate。
|
||||
前端控制器—Srping提供了DispatcherServlet来对请求进行分发。
|
||||
视图帮助(View Helper )—Spring提供了一系列的JSP标签,高效宏来辅助将分散的代码整合在视图里。
|
||||
依赖注入—贯穿于BeanFactory / ApplicationContext接口的核心理念。
|
||||
**工厂模式**—BeanFactory用来创建对象的实例。
|
||||
**Builder模式** - 自定义配置文件的解析bean是时采用builder模式,一步一步地构建一个beanDefinition
|
||||
**策略模式** :Spring 中策略模式使用有多个地方,如 Bean 定义对象的创建以及代理对象的创建等。这里主要看一下代理对象创建的策略模式的实现。
|
||||
前面已经了解 Spring 的代理方式有两个 Jdk 动态代理和 CGLIB 代理。这两个代理方式的使用正是使用了策略模式。
|
||||
|
||||
## AOP是怎么实现的
|
||||
实现AOP的技术,主要分为两大类:一是采用动态代理技术,利用截取消息的方式,对该消息进行装饰,以取代原有对象行为的执行;二是采用静态织入的方式,引入特定的语法创建“方面”,从而使得编译器可以在编译期间织入有关“方面”的代码。Spring AOP 的实现原理其实很简单:AOP 框架负责动态地生成 AOP 代理类,这个代理类的方法则由 Advice 和回调目标对象的方法所组成,并将该对象可作为目标对象使用。AOP 代理包含了目标对象的全部方法,但 AOP 代理中的方法与目标对象的方法存在差异,AOP 方法在特定切入点添加了增强处理,并回调了目标对象的方法。
|
||||
Spring AOP使用动态代理技术在运行期织入增强代码。使用两种代理机制:基于JDK的动态代理(JDK本身只提供接口的代理);基于CGlib的动态代理。
|
||||
|
||||
1)JDK的动态代理主要涉及java.lang.reflect包中的两个类:Proxy和InvocationHandler。其中InvocationHandler只是一个接口,可以通过实现该接口定义横切逻辑,并通过反射机制调用目标类的代码,动态的将横切逻辑与业务逻辑织在一起。而Proxy利用InvocationHandler动态创建一个符合某一接口的实例,生成目标类的代理对象。
|
||||
其代理对象**必须是某个接口的实现**,它是通过在运行期间创建一个接口的实现类来完成对目标对象的代理.只能实现接口的类生成代理,而**不能针对类**
|
||||
|
||||
2)CGLib采用底层的字节码技术,为一个类创建子类,并在子类中采用方法拦截的技术拦截所有父类的调用方法,并顺势织入横切逻辑.它运行期间生成的代理对象是目标类的扩展子类.所以无法通知final的方法,因为它们不能被覆写.是针对类实现代理,主要是为指定的类生成一个子类,覆盖其中方法.
|
||||
|
||||
在spring中默认情况下使用JDK动态代理实现AOP,如果proxy-target-class设置为true或者使用了优化策略那么会使用CGLIB来创建动态代理.Spring AOP在这两种方式的实现上基本一样.以JDK代理为例,会使用JdkDynamicAopProxy来创建代理,在invoke()方法首先需要织入到当前类的增强器封装到拦截器链中,然后递归的调用这些拦截器完成功能的织入.最终返回代理对象.
|
||||
|
||||
http://zhengjianglong.cn/2015/12/12/Spring/spring-source-aop/
|
||||
|
||||
## 介绍spring的IOC实现
|
||||
Spring IOC主要负责创建和管理bean及bean之间的依赖关系.Spring IOC的可分为:IOC容器的初始化和bean的加载.
|
||||
在IOC容器阶段主要是完成资源的加载(如定义bean的xml文件),bean的解析及对解析后得到的beanDefinition的进行注册.以xmlBeanFactory为例,XmlBeanFactory继承了DefaultListableBeanFactory,XmlBeanFactory将读取xml配置文件,解析bean和注册解析后的beanDefinition工作交给XmlBeanDefinitionReader(是BeanDefinitionReader接口的一个个性化实现)来执行.spring中定义了一套资源类,将文件,class等都看做资源.
|
||||
1)所以首先是将xml文件转化为资源然后用EncodeResouce来封装,该功能主要时考虑Resource可能存在编码要求的情况,如UTF-8等.
|
||||
2)然后根据xml文件判断xml的约束模式,是DTD还是Schema,以及寻找模式文档(验证文件)的方法(EntityResolver,这部分采用了代理模式和策略模式).
|
||||
完成了前面所有的准备工作以后就可以正式的加载配置文件,获取Docoment和解析注册BeanDefinition.Docoment的获取以及BeanDefinition的解析注册并不是由XmlBeanDefinitionReader完成,XmlBeanDefinitionReader只是将前面的工作完成以后文档加载交给DefaultDocumentLoader类来完成.而解析交给了DefaultBeanDefinitionDocumentReader来处理.bean标签可以分为两种,一种是spring自带的默认标签,另一种就是用户自定义的标签.所以spring针对这两种情况,提供了不同的解析方式. 每种bean的解析完成后都会先注册到容器中然后最后发出响应事件,通知相关的监听器这个bean已经注册完成了.
|
||||
|
||||
**bean的加载**
|
||||
http://zhengjianglong.cn/2015/12/06/Spring/spring-source-ioc-bean-parse/
|
||||
|
||||
## spring中bean加载机制,bean生成的具体步骤
|
||||
1.容器寻找Bean的定义信息并且将其实例化。
|
||||
2.如果允许提前暴露工厂,则提前暴露这个bean的工厂,这个工厂主要是返回该未完全处理的bean.主要是用于避免单例属性循环依赖问题.
|
||||
3.受用**依赖注入**,Spring按照Bean定义信息配置Bean的所有属性。
|
||||
4.如果Bean实现了**BeanNameAware**接口,工厂调用Bean的**setBeanName()**方法传递Bean的ID。
|
||||
5.如果Bean实现了**BeanFactoryAware**接口,工厂调用**setBeanFactory()**方法传入工厂自身。
|
||||
6.如果**BeanPostProcessor**和Bean关联,那么它们的**postProcessBeforeInitialzation()**方法将被调用。
|
||||
7.如果Bean指定了init-method方法,它将被调用。
|
||||
8.如果有**BeanPsotProcessor**和Bean关联,那么它们的postProcessAfterInitialization()方法将被调用
|
||||
9.最后如果配置了destroy-method方法则注册**DisposableBean**.
|
||||
http://www.cnblogs.com/ITtangtang/p/3978349.html
|
||||
|
||||
|
||||
## springMVC流程具体叙述下
|
||||
当应用启动时,容器会加载servlet类并调用init方法. 在这个阶段,DispatcherServlet在init()完成初始化参数init-param的解析和封装,相关配置,spring的WebApplicationContext的初始化即完成xml文件的加载,bean的解析和注册等工作,另外为servlet功能所用的变量进行初始化,如:handlerMapping,viewResolvers等.
|
||||
|
||||
当用户发送一个请求时,首先根据请求的类型调用DispatcherServlet不同的方法,这些方法都会转发到doService()中执行.在该方法内部完成以下工作:
|
||||
1)spring首先考虑multipart的处理,如果是MultipartContent类型的request,则将该请求转换成MultipartHttpServletRequest类型的request.
|
||||
2)根据request信息获取对应的Handler. 首先根据request获取访问路径,然后根据该路径可以选择直接匹配或通用匹配的方式寻找Handler,即用户定义的controller. Handler在init()方法时已经完成加载且保存到Map中了,只要根据路径就可以得到对应的Handler. 如果不存在则尝试使用默认的Handler. 如果还是没有找到那么就通过response向用户返回错误信息.找到handler后会将其包装在一个执行链中,然后将所有的拦截器也加入到该链中.
|
||||
4)如果存在handler则根据当前的handler寻找对应的HandlerAdapter. 通过遍历所有适配器来选择合适的适配器.
|
||||
5)SpringMVC允许你通过处理拦截器Web请求,进行前置处理和后置处理.所以在正式调用 Handler的逻辑方法时,先执行所有拦截器的preHandle()方法.
|
||||
6)正式执行handle的业务逻辑方法handle(),返回ModelAndView.逻辑处理是通过适配器调用handle并返回视图.这过程其实是调用用户controller的业务逻辑.
|
||||
8)调用拦截器的postHandle()方法,完成后置处理.
|
||||
9)根据视图进行页面跳转.该过程首先会根据视图名字解析得到视图,该过程支持缓存,如果缓存中存在则直接获取,否则创建新的视图并在支持缓存的情况下保存到缓冲中.该10)过程完成了像添加前缀后缀,设置必须的属性等工作.最后就是进行页面跳转处理.
|
||||
11)调用拦截器的afterComplection()
|
||||
|
||||
## spring各个版本的区别
|
||||
|
||||
|
||||
## ioc注入的方式
|
||||
1)setter方法注入
|
||||
2)构造器注入
|
||||
<!--普通构造器注入-->
|
||||
<bean id="helloAction" class="org.yoo.action.ConstructorHelloAction">
|
||||
<!--type 必须为java.lang.String 因为是按类型匹配的,不是按顺序匹配-->
|
||||
|
||||
<constructor-arg type="java.lang.String" value="yoo"/>
|
||||
<!-- 也可以使用index来匹配-->
|
||||
<!--<constructor-arg index="1" value="42"/>-->
|
||||
<constructor-arg><ref bean="helloService"/></constructor-arg>
|
||||
</bean>
|
||||
|
||||
3)静态工厂注入 factory-method参数
|
||||
4)实例工厂
|
||||
http://blessht.iteye.com/blog/1162131
|
||||
|
||||
## AOP相关概念
|
||||
**方面(Aspect)**:一个关注点的模块化,这个关注点实现可能另外横切多个对象。事务管理是J2EE应用中一个很好的横切关注点例子。方面用Spring的 Advisor或拦截器实现。
|
||||
**连接点(Joinpoint)**: 程序执行过程中明确的点,如方法的调用或特定的异常被抛出。
|
||||
**通知(Advice):** 在特定的连接点,AOP框架执行的动作。各种类型的通知包括“around”、“before”和“throws”通知。通知类型将在下面讨论。许多AOP框架包括Spring都是以拦截器做通知模型,维护一个“围绕”连接点的拦截器链。Spring中定义了4个advice.Interception Around(MethodInterceptor)、Before(MethodBeforeAdvice)、After Returning(AfterReturningAdvice)、After(AfterAdvice)。
|
||||
**切入点(Pointcut)**: 一系列连接点的集合。AOP框架必须允许开发者指定切入点:例如,使用正则表达式。 Spring定义了Pointcut接口,用来组合MethodMatcher和ClassFilter,可以通过名字很清楚的理解, MethodMatcher是用来检查目标类的方法是否可以被应用此通知,而ClassFilter是用来检查Pointcut是否应该应用到目标类上
|
||||
**引入(Introduction)**: 添加方法或字段到被通知的类。 Spring允许引入新的接口到任何被通知的对象。例如,你可以使用一个引入使任何对象实现 IsModified接口,来简化缓存。Spring中要使用Introduction, 可有通过DelegatingIntroductionInterceptor来实现通知,通过DefaultIntroductionAdvisor来配置Advice和代理类要实现的接口
|
||||
**目标对象(Target Object)**: 包含连接点的对象。也被称作被通知或被代理对象。POJO
|
||||
**AOP代理(AOP Proxy)**: AOP框架创建的对象,包含通知。 在Spring中,AOP代理可以是JDK动态代理或者CGLIB代理。
|
||||
**织入(Weaving)**: 组装方面来创建一个被通知对象。这可以在编译时完成(例如使用AspectJ编译器),也可以在运行时完成。Spring和其他纯Java AOP框架一样,在运行时完成织入。
|
||||
|
||||
## spring何时创建applicationContext(web.xml中使用listener 或dispatcherServlet)
|
||||
|
||||
## listener是监听哪个事件(ServletContext创建事件)
|
||||
ServletContextListener 接口用于监听 ServletContext 对象的创建和销毁事件。
|
||||
(1) 当 ServletContext 对象被创建时,激发contextInitialized (ServletContextEvent sce)方法
|
||||
(2) 当 ServletContext 对象被销毁时,激发contextDestroyed(ServletContextEvent sce)方法。
|
||||
|
||||
## 过滤器与监听器的区别
|
||||
Filter可认为是Servlet的一种“变种”,它主要用于对用户请求进行预处理,也可以对HttpServletResponse进行后处理,是个典型的处理链。它与Servlet的区别在于:它不能直接向用户生成响应。完整的流程是:Filter对用户请求进行预处理,接着将请求交给 Servlet进行处理并生成响应,最后Filter再对服务器响应进行后处理。
|
||||
Java中的Filter 并不是一个标准的Servlet ,它不能处理用户请求,也不能对客户端生成响应。 主要用于对HttpServletRequest 进行预处理,也可以对HttpServletResponse 进行后处理,是个典型的处理链。优点:过滤链的好处是,执行过程中任何时候都可以打断,只要不执行chain.doFilter()就不会再执行后面的过滤器和请求的内容。而在实际使用时,就要特别注意过滤链的执行顺序问题
|
||||
http://blog.csdn.net/sd0902/article/details/8395641
|
||||
|
||||
Servlet,Filter都是针对url之类的,而Listener是针对对象的操作的,如session的创建,session.setAttribute的发生,或者在启动服务器的时候将你需要的数据加载到缓存等,在这样的事件发生时做一些事情。
|
||||
http://www.tuicool.com/articles/bmqMjm
|
||||
|
||||
## 请描述一下java事件监听机制。
|
||||
(1) Java的事件监听机制涉及到三个组件:事件源、事件监听器、事件对象
|
||||
(2) 当事件源上发生操作时,它将会调用事件监听器的一个方法,并在调用这个方法时,会传递事件对象过来
|
||||
(3) 事件监听器由开发人员编写,开发人员在事件监听器中,通过事件对象可以拿到事件源,从而对事件源上的操作进行处理。
|
||||
|
||||
## 解释核心容器(应用上下文)模块
|
||||
这是Spring的基本模块,它提供了Spring框架的基本功能。BeanFactory 是所有Spring应用的核心。Spring框架是建立在这个模块之上的,这也使得Spring成为一个容器。
|
||||
|
||||
## BeanFactory – BeanFactory 实例
|
||||
BeanFactory是工厂模式的一种实现,它使用控制反转将应用的配置和依赖与实际的应用代码分离开来。最常用的BeanFactory实现是XmlBeanFactory类。
|
||||
|
||||
## XmlBeanFactory
|
||||
最常用的就是org.springframework.beans.factory.xml.XmlBeanFactory,它根据XML文件中定义的内容加载beans。该容器从XML文件中读取配置元数据,并用它来创建一个完备的系统或应用。
|
||||
|
||||
## 解释AOP模块
|
||||
AOP模块用来开发Spring应用程序中具有切面性质的部分。该模块的大部分服务由AOP Aliance提供,这就保证了Spring框架和其他AOP框架之间的互操作性。另外,该模块将元数据编程引入到了Spring。
|
||||
|
||||
## 解释抽象JDBC和DAO模块
|
||||
通过使用抽象JDBC和DAO模块保证了与数据库连接代码的整洁与简单,同时避免了由于未能关闭数据库资源引起的问题。它在多种数据库服务器的错误信息之上提供了一个很重要的异常层。它还利用Spring的AOP模块为Spring应用程序中的对象提供事务管理服务。
|
||||
|
||||
## 解释对象/关系映射集成模块
|
||||
Spring通过提供ORM模块在JDBC的基础上支持对象关系映射工具。这样的支持使得Spring可以集成主流的ORM框架,包括Hibernate, JDO, 及iBATIS SQL Maps。Spring的事务管理可以同时支持以上某种框架和JDBC。
|
||||
|
||||
## 解释web模块
|
||||
Spring的web模块建立在应用上下文(application context)模块之上,提供了一个适合基于web应用程序的上下文环境。该模块还支持了几个面向web的任务,如透明的处理多文件上传请求及将请求参数同业务对象绑定起来。
|
||||
|
||||
## 解释Spring MVC模块
|
||||
Spring提供MVC框架构建web应用程序。Spring可以很轻松的同其他MVC框架结合,但Spring的MVC是个更好的选择,因为它通过控制反转将控制逻辑和业务对象完全分离开来。
|
||||
|
||||
## ContextLoaderListener是监听什么事件
|
||||
ContextLoaderListener的作用就是启动Web容器时,自动装配ApplicationContext的配置信息。因为它实现了ServletContextListener这个接口,在web.xml配置这个监听器,启动容器时,就会默认执行它实现的方法。
|
||||
|
||||
## Spring IoC容器
|
||||
Spring IOC负责创建对象、管理对象(通过依赖注入)、整合对象、配置对象以及管理这些对象的生命周期。
|
||||
|
||||
## IOC有什么优点?
|
||||
IOC或依赖注入减少了应用程序的代码量。它使得应用程序的**测试很简单**,因为在单元测试中不再需要单例或JNDI查找机制。简单的实现以及较少的干扰机制使得**松耦合**得以实现。IOC容器支持勤性单例及延迟加载服务。
|
||||
|
||||
## 应用上下文是如何实现的?
|
||||
ClassPathXmlApplicationContext 容器加载XML文件中beans的定义。XML Bean配置文件的完整路径必须传递给构造器。
|
||||
FileSystemXmlApplicationContext 容器也加载XML文件中beans的定义。注意,你需要正确的设置CLASSPATH,因为该容器会在CLASSPATH中查看bean的XML配置文件。
|
||||
WebXmlApplicationContext:该容器加载xml文件,这些文件定义了web应用中所有的beans。
|
||||
|
||||
## 有哪些不同类型的IOC(依赖注入)
|
||||
**接口注入**:接口注入的意思是通过接口来实现信息的注入,而其它的类要实现该接口时,就可以实现了注入
|
||||
构造器依赖注入:构造器依赖注入在容器触发构造器的时候完成,该构造器有一系列的参数,每个参数代表注入的对象。
|
||||
Setter方法依赖注入:首先容器会触发一个无参构造函数或无参静态工厂方法实例化对象,之后容器调用bean中的setter方法完成Setter方法依赖注入。
|
||||
|
||||
## 你推荐哪种依赖注入?构造器依赖注入还是Setter方法依赖注入?
|
||||
你可以同时使用两种方式的依赖注入,最好的选择是使用构造器参数实现强制依赖注入,使用setter方法实现可选的依赖关系。
|
||||
|
||||
## 什么是Spring Beans
|
||||
Spring Beans是构成Spring应用核心的Java对象。这些对象由Spring IOC容器实例化、组装、管理。这些对象通过容器中配置的元数据创建,例如,使用XML文件中定义的创建。
|
||||
在Spring中创建的beans都是单例的beans。在bean标签中有一个属性为”singleton”,如果设为true,该bean是单例的,如果设为false,该bean是原型bean。Singleton属性默认设置为true。因此,spring框架中所有的bean都默认为单例bean。
|
||||
|
||||
## Spring Bean中定义了什么内容?
|
||||
Spring Bean中定义了所有的配置元数据,这些配置信息告知容器如何创建它,它的生命周期是什么以及它的依赖关系。
|
||||
|
||||
## 如何向Spring 容器提供配置元数据
|
||||
有三种方式向Spring 容器提供元数据:
|
||||
XML配置文件
|
||||
基于注解配置
|
||||
基于Java的配置
|
||||
|
||||
## 你如何定义bean的作用域
|
||||
在Spring中创建一个bean的时候,我们可以声明它的作用域。只需要在bean定义的时候通过’scope’属性定义即可。例如,当Spring需要产生每次一个新的bean实例时,应该声明bean的scope属性为prototype。如果每次你希望Spring返回一个实例,应该声明bean的scope属性为singleton。
|
||||
|
||||
## Spring框架中单例beans是线程安全的吗?
|
||||
不是,Spring框架中的单例beans不是线程安全的。
|
||||
|
||||
## 哪些是最重要的bean生命周期方法?能重写它们吗?
|
||||
有两个重要的bean生命周期方法。第一个是setup方法,该方法在容器加载bean的时候被调用。第二个是teardown方法,该方法在bean从容器中移除的时候调用。
|
||||
bean标签有两个重要的属性(init-method 和 destroy-method),你可以通过这两个属性定义自己的初始化方法和析构方法。Spring也有相应的注解:@PostConstruct 和 @PreDestroy。
|
||||
|
||||
## 什么是Spring的内部bean
|
||||
当一个bean被用作另一个bean的属性时,这个bean可以被声明为内部bean。在基于XML的配置元数据中,可以通过把元素定义在 或元素内部实现定义内部bean。内部bean总是匿名的并且它们的scope总是prototype。
|
||||
|
||||
## 如何在Spring中注入Java集合类
|
||||
Spring提供如下几种类型的集合配置元素:
|
||||
list元素用来注入一系列的值,允许有相同的值。
|
||||
set元素用来注入一些列的值,不允许有相同的值。
|
||||
map用来注入一组”键-值”对,键、值可以是任何类型的。
|
||||
props也可以用来注入一组”键-值”对,这里的键、值都字符串类型。
|
||||
|
||||
## 什么是bean wiring?
|
||||
Wiring,或者说bean Wiring是指beans在Spring容器中结合在一起的情况。当装配bean的时候,Spring容器需要知道需要哪些beans以及如何使用依赖注入将它们结合起来。
|
||||
|
||||
## 什么是bean自动装配?
|
||||
Spring容器可以自动配置相互协作beans之间的关联关系。这意味着Spring可以自动配置一个bean和其他协作bean之间的关系,通过检查BeanFactory 的内容里没有使用和< property>元素。
|
||||
|
||||
## 解释自动装配的各种模式
|
||||
自动装配提供五种不同的模式供Spring容器用来自动装配beans之间的依赖注入:
|
||||
no:默认的方式是不进行自动装配,通过手工设置ref 属性来进行装配bean。
|
||||
byName:通过参数名自动装配,Spring容器查找beans的属性,这些beans在XML配置文件中被设置为byName。之后容器试图匹配、装配和该bean的属性具有相同名字的bean。
|
||||
byType:通过参数的数据类型自动自动装配,Spring容器查找beans的属性,这些beans在XML配置文件中被设置为byType。之后容器试图匹配和装配和该bean的属性类型一样的bean。如果有多个bean符合条件,则抛出错误。
|
||||
constructor:这个同byType类似,不过是应用于构造函数的参数。如果在BeanFactory中不是恰好有一个bean与构造函数参数相同类型,则抛出一个严重的错误。
|
||||
autodetect:如果有默认的构造方法,通过 construct的方式自动装配,否则使用 byType的方式自动装配。
|
||||
|
||||
## 自动装配有哪些局限性?
|
||||
自动装配有如下局限性:
|
||||
重写:你仍然需要使用 和< property>设置指明依赖,这意味着总要重写自动装配。
|
||||
原生数据类型:你不能自动装配简单的属性,如原生类型、字符串和类。
|
||||
模糊特性:自动装配总是没有自定义装配精确,因此,如果可能尽量使用自定义装配。
|
||||
|
||||
## 你可以在Spring中注入null或空字符串吗
|
||||
完全可以。
|
||||
|
||||
## 什么是Spring基于Java的配置?给出一些注解的例子
|
||||
基于Java的配置允许你使用Java的注解进行Spring的大部分配置而非通过传统的XML文件配置。以注解@Configuration为例,它用来标记类,说明作为beans的定义,可以被Spring IOC容器使用。另一个例子是@Bean注解,它表示该方法定义的Bean要被注册进Spring应用上下文中。
|
||||
|
||||
## 什么是基于注解的容器配置
|
||||
另外一种替代XML配置的方式为基于注解的配置,这种方式通过字节元数据装配组件而非使用尖括号声明。开发人员将直接在类中进行配置,通过注解标记相关的类、方法或字段声明,而不再使用XML描述bean之间的连线关系。
|
||||
|
||||
## 如何开启注解装配?
|
||||
注解装配默认情况下在Spring容器中是不开启的。如果想要开启基于注解的装配只需在Spring配置文件中配置元素即可。<context:annotation-config>
|
||||
|
||||
## @Required 注解
|
||||
@Required表明bean的属性必须在配置时设置,可以在bean的定义中明确指定也可通过自动装配设置。如果bean的属性未设置,则抛出BeanInitializationException异常。
|
||||
|
||||
## @Autowired 注解
|
||||
@Autowired 注解提供更加精细的控制,包括自动装配在何处完成以及如何完成。它可以像@Required一样自动装配setter方法、构造器、属性或者具有任意名称和/或多个参数的PN方法。
|
||||
|
||||
## @Qualifier 注解
|
||||
当有多个相同类型的bean而只有其中的一个需要自动装配时,将@Qualifier 注解和@Autowire 注解结合使用消除这种混淆,指明需要装配的bean。
|
||||
Spring数据访问
|
||||
|
||||
## 在Spring框架中如何更有效的使用JDBC?
|
||||
使用Spring JDBC框架,资源管理以及错误处理的代价都会减轻。开发人员只需通过statements和queries语句从数据库中存取数据。Spring框架中通过使用模板类能更有效的使用JDBC,也就是所谓的JdbcTemplate。
|
||||
|
||||
## JdbcTemplate
|
||||
JdbcTemplate类提供了许多方法,为我们与数据库的交互提供了便利。例如,它可以将数据库的数据转化为原生类型或对象,执行写好的或可调用的数据库操作语句,提供自定义的数据库错误处理功能。
|
||||
|
||||
## Spring对DAO的支持
|
||||
Spring对数据访问对象(DAO)的支持旨在使它可以与数据访问技术(如 JDBC, Hibernate 及JDO)方便的结合起来工作。这使得我们可以很容易在的不同的持久层技术间切换,编码时也无需担心会抛出特定技术的异常。
|
||||
|
||||
## 使用Spring可以通过什么方式访问Hibernate?
|
||||
使用Spring有两种方式访问Hibernate:
|
||||
使用Hibernate Template的反转控制以及回调方法
|
||||
继承HibernateDAOSupport,并申请一个AOP拦截器节点
|
||||
|
||||
## Spring支持的ORM
|
||||
Spring支持一下ORM:
|
||||
Hibernate
|
||||
iBatis
|
||||
JPA (Java -Persistence API)
|
||||
TopLink
|
||||
JDO (Java Data Objects)
|
||||
OJB
|
||||
|
||||
## 如何通过HibernateDaoSupport将Spring和Hibernate结合起来?
|
||||
使用Spring的SessionFactory 调用LocalSessionFactory。结合过程分为以下三步:
|
||||
配置Hibernate SessionFactory
|
||||
继承HibernateDaoSupport实现一个DAO
|
||||
使用AOP装载事务支持
|
||||
|
||||
## Spring支持的事务管理类型
|
||||
Spring支持如下两种方式的事务管理:
|
||||
编码式事务管理:sping对编码式事务的支持与EJB有很大区别,不像EJB与java事务API耦合在一起.spring通过回调机制将实际的事务实现从事务性代码中抽象出来.你能够精确控制事务的边界,它们的开始和结束完全取决于你.
|
||||
声明式事务管理:这种方式意味着你可以将事务管理和业务代码分离。你只需要通过注解或者XML配置管理事务。通过传播行为,隔离级别,回滚规则,事务超时,只读提示来定义.
|
||||
|
||||
## Spring框架的事务管理有哪些优点
|
||||
它为不同的事务API(如JTA, JDBC, Hibernate, JPA, 和JDO)提供了统一的编程模型。
|
||||
它为编程式事务管理提供了一个简单的API而非一系列复杂的事务API(如JTA).
|
||||
它支持声明式事务管理。
|
||||
它可以和Spring 的多种数据访问技术很好的融合。
|
||||
|
||||
## ACID
|
||||
**原子性(Atomic)**:一个操作要么成功,要么全部不执行.
|
||||
**一致性(Consistent)**: 一旦事务完成,系统必须确保它所建模业务处于一致的状态
|
||||
**隔离性(Isolated)**: 事务允许多个用户对相同的数据进行操作,每个用户用户的操作相互隔离互补影响.
|
||||
**持久性(Durable)**: 一旦事务完成,事务的结果应该持久化.
|
||||
|
||||
## spring事务定义的传播规则
|
||||
PROPAGATION_REQUIRED–支持当前事务,如果当前没有事务,就新建一个事务。这是最常见的选择。
|
||||
PROPAGATION_SUPPORTS–支持当前事务,如果当前没有事务,就以非事务方式执行。
|
||||
PROPAGATION_MANDATORY–支持当前事务,如果当前没有事务,就抛出异常。
|
||||
PROPAGATION_REQUIRES_NEW–新建事务,如果当前存在事务,把当前事务挂起。
|
||||
PROPAGATION_NOT_SUPPORTED–以非事务方式执行操作,如果当前存在事务,就把当前事务挂起。
|
||||
PROPAGATION_NEVER–以非事务方式执行,如果当前存在事务,则抛出异常。
|
||||
PROPAGATION_NESTED–如果当前存在事务,则在嵌套事务内执行。如果当前没有事务,则进行与PROPAGATION_REQUIRED类似的操作。
|
||||
|
||||
## spring事务支持的隔离级别
|
||||
并发会导致以下问题:
|
||||
藏读:发生在一个事务读取了另一个事务改写但尚未提交的数据.
|
||||
不可重复读:在一个事务执行相同的查询两次或两次以上,每次得到的数据不同.
|
||||
幻读:与不可重复读类似,发生在一个事务读取多行数据,接着另一个并发事务插入一些数据,随后查询中,第一个事务发现多了一些原本不存在的数据.
|
||||
spring 事务上提供以下的隔离级别:
|
||||
ISOLATION_DEFAULT: 使用后端数据库默认的隔离级别
|
||||
ISOLATION_READ_UNCOMMITTED : 允许读取未提交的数据变更,可能会导致脏读,幻读或不可重复读
|
||||
ISOLATION_READ_COMMITTD : 允许读取为提交数据,可以阻止脏读,当时幻读或不可重复读仍可能发生
|
||||
ISOLATION_REPEATABLE_READ: 对统一字段多次读取结果是一致的,除非数据是被本事务自己修改.可以阻止脏读,不可重复读,但幻读可能发生
|
||||
ISOLATION_SERIALIZABLE : 完全服从ACID
|
||||
|
||||
## 你更推荐那种类型的事务管理?
|
||||
许多Spring框架的用户选择声明式事务管理,因为这种方式和应用程序的关联较少,因此更加符合轻量级容器的概念。声明式事务管理要优于编程式事务管理,尽管在灵活性方面它弱于编程式事务管理(这种方式允许你通过代码控制业务)。
|
||||
|
||||
## 有几种不同类型的自动代理?
|
||||
BeanNameAutoProxyCreator:bean名称自动代理创建器
|
||||
DefaultAdvisorAutoProxyCreator:默认通知者自动代理创建器
|
||||
Metadata autoproxying:元数据自动代理
|
||||
|
||||
## 什么是织入?什么是织入应用的不同点?
|
||||
织入是将切面和其他应用类型或对象连接起来创建一个通知对象的过程。织入可以在编译、加载或运行时完成。
|
||||
|
||||
## 什么是Spring的MVC框架?
|
||||
Spring提供了一个功能齐全的MVC框架用于构建Web应用程序。Spring框架可以很容易的和其他的MVC框架融合(如Struts),该框架使用控制反转(IOC)将控制器逻辑和业务对象分离开来。它也允许以声明的方式绑定请求参数到业务对象上。
|
||||
|
||||
## DispatcherServlet
|
||||
Spring的MVC框架围绕DispatcherServlet来设计的,它用来处理所有的HTTP请求和响应。
|
||||
|
||||
## WebApplicationContext
|
||||
WebApplicationContext继承了ApplicationContext,并添加了一些web应用程序需要的功能。和普通的ApplicationContext 不同,WebApplicationContext可以用来处理主题样式,它也知道如何找到相应的servlet。
|
||||
|
||||
## 什么是Spring MVC框架的控制器?
|
||||
控制器提供对应用程序行为的访问,通常通过服务接口实现。控制器解析用户的输入,并将其转换为一个由视图呈现给用户的模型。Spring 通过一种极其抽象的方式实现控制器,它允许用户创建多种类型的控制器。
|
||||
|
||||
## @Controller annotation
|
||||
@Controller注解表示该类扮演控制器的角色。Spring不需要继承任何控制器基类或应用Servlet API。
|
||||
|
||||
## @RequestMapping annotation
|
||||
@RequestMapping注解用于将URL映射到任何一个类或者一个特定的处理方法上。
|
||||
|
||||
|
||||
http://www.codeceo.com/article/spring-top-25-interview.html
|
||||
|
||||
个人公众号(欢迎关注):
|
||||

|
||||
|
||||
|
||||
|
||||
@@ -0,0 +1,162 @@
|
||||
## 描述 Struts 体系结构?对应各个部分的开发工作主要包括哪些?
|
||||
Struts开源架构很好的实现了MVC模式,MVC即Model-View-Controller的缩写,是一种常用的设计模式。MVC 减弱了业务逻辑接口和数据接口之间的耦合,以及让视图层更富于变化。在Struts2的模型 - 视图 - 控制器模式,实现以下五个核心部件:
|
||||
Actions
|
||||
Interceptors
|
||||
Value Stack / OGNL
|
||||
Results / Result types
|
||||
View technologies
|
||||
|
||||
Struts 2 从传统的MVC框架操作需要的模型,而不是在控制器角色略有不同,虽然有一些重叠
|
||||
**模型**
|
||||
模型以一个或多个java bean的形式存在。这些bean分为三类:Action Form、Action、JavaBean or EJB。Action Form通常称之为FormBean,封装了来自于Client的用户请求信息,如表单信息。Action通常称之为ActionBean,获取从ActionSevlet传来的FormBean,取出FormBean中的相关信息,并做出相关的处理,一般是调用Java Bean或EJB等。
|
||||
|
||||
**视图**
|
||||
主要由JSP生成页面完成视图,Struts提供丰富的JSP 标签库: Html,Bean,Logic,Template等
|
||||
|
||||
**控制器**
|
||||
该控制器负责响应用户输入和执行数据模型对象的相互作用。控制器接收输入,验证输入,然后进行业务操作,修改数据模型的状态。
|
||||
|
||||
这个解释比较好: http://www.yiibai.com/struts_2/struts_architecture.html
|
||||
http://www.cnblogs.com/langtianya/archive/2013/04/09/3011090.html
|
||||
|
||||
## 什么是Struts2
|
||||
Apache Struts2的是一个在Java中构建**Web应用程序开源框架**。 Struts2是基于OpenSymphony的WebWork的框架。它是Struts1的提高,它更加灵活,易于使用和扩展。 Struts2的核心组成部分是Action,拦截器和结果页。
|
||||
|
||||
Struts2提供了许多方法来创建Action类,并**通过struts.xml中或通过注释进行配置**。我们可以创建自己的**拦截器**实现常见任务。 Struts2中自带了很多的**标签,并使用OGNL表达式语言**。我们可以创造我们自己的类型转换器来呈现的结果页面。结果页面可以JSP和FreeMarker的模板。
|
||||
|
||||
## Struts 与webWork的区别
|
||||
Struts 2是Struts的下一代产品。是在 struts 和WebWork的技术基础上进行了合并,全新的Struts 2框架。其全新的Struts 2的体系结构与Struts 1的体系结构的差别巨大。Struts 2以WebWork为核心,采用拦截器的机制来处理用户的请求,这样的设计也使得业务逻辑控制器能够与Servlet API完全脱离开,所以Struts 2可以理解为WebWork的更新产品。
|
||||
|
||||
Struts和Webwork同为服务于Web的一种MVC框架,从某种程度上看,Struts2是从WebWork2上升级得到的。甚至Apache的官方文档也讲:WebWork2到Struts2是平滑的过渡。我们甚至也可以说Struts2就是WebWork2.3而已。在很多方面Struts仅仅是改变了WebWork下的名称。Struts2对应的有自己的标签,并且功能强大。Webwork也有自己的标签。
|
||||
1) 在很多方面Struts2仅仅是改变了WebWork下的名称,如DispatcherUtil 改为了Dispatcher.
|
||||
2) AroundInterceptor:Struts 2不再支持WebWork中的AroundInterceptor。如果应用程序中需要使用AroundInterceptor,则应该自己手动导入WebWork中的AroundInterceptor类。
|
||||
3) IoC容器支持:Struts 2不再支持内建的IoC容器,而改为全面支持Spring的IoC容器,以Spring的IoC容器作为默认的Object工厂。
|
||||
4) 富文本编辑器标签:Struts 2不再支持WebWork的富文本编辑器,如果应用中需要使用富文本编辑器,则应该使用**Dojo**的富文本编辑器。
|
||||
|
||||
http://developer.51cto.com/art/201106/271744.htm
|
||||
|
||||
## struts2 与struts1的区别
|
||||
Action类,线程安全,测试,标签,验证
|
||||
<img src="imgs/struts2-vs-struts1.png">
|
||||
|
||||
**Action 类:**
|
||||
• Struts1要求Action类继承一个**抽象**基类。Struts1的一个普遍问题是使用抽象类编程而不是接口,而struts2的Action是接口。
|
||||
• Struts 2 Action类可以实现一个Action**接口**,也可实现其他接口,**使可选和定制的服务成为可能**。Struts2提供一个ActionSupport基类去 实现 常用的接口。Action接口不是必须的,任何有execute标识的POJO对象都可以用作Struts2的Action对象。
|
||||
|
||||
**线程模式**:
|
||||
• Struts1 Action是单例模式并且必须是线程安全的,因为仅有Action的一个实例来处理所有的请求。单例策略限制了Struts1 Action能作的事,并且要在开发时特别小心。Action资源必须是线程安全的或同步的。(**不是线程安全**)
|
||||
• Struts2 Action对象为每一个请求产生一个实例,因此没有线程安全问题。(实际上,servlet容器给每个请求产生许多可丢弃的对象,并且不会导致性能和垃圾回收问题)(**线程安全**)
|
||||
|
||||
**Servlet 依赖**:
|
||||
• Struts1 Action 依赖于Servlet API ,因为当一个Action被调用时HttpServletRequest 和 HttpServletResponse 被传递给execute方法。
|
||||
• Struts 2 Action不依赖于容器,允许Action脱离容器单独被测试。如果需要,Struts2 Action仍然可以访问初始的request和response。但是,其他的元素减少或者消除了直接访问HttpServetRequest 和 HttpServletResponse的必要性。
|
||||
|
||||
**可测性**:
|
||||
• 测试Struts1 Action的一个主要问题是execute方法暴露了servlet API(这使得测试要依赖于容器)。一个第三方扩展--Struts TestCase--提供了一套Struts1的模拟对象(来进行测试)。
|
||||
• Struts 2 Action可以通过初始化、设置属性、调用方法来测试,“依赖注入”支持也使测试更容易。
|
||||
|
||||
**表达式语言**:
|
||||
• Struts1 整合了JSTL,因此使用JSTL EL。这种EL有基本对象图遍历,但是对集合和索引属性的支持很弱。
|
||||
• Struts2可以使用JSTL,但是也支持一个更强大和灵活的表达式语言--"Object Graph Notation Language" (OGNL).
|
||||
|
||||
**绑定值到页面(view)**:
|
||||
• Struts 1使用标准JSP机制把对象绑定到页面中来访问。
|
||||
• Struts 2 使用 "ValueStack"技术,使taglib能够访问值而不需要把你的页面(view)和对象绑定起来。ValueStack策略允许通过一系列名称相同但类型不同的属性重用页面(view)。
|
||||
|
||||
## Struts工作流程:
|
||||

|
||||
Struts2:
|
||||
(1)客户端提交一个HttpServletRequest请求(.action或JSP页面)
|
||||
(2)请求被提交到一系列(主要是三层)的过滤器(Filter),如(ActionContextCleanUp、其他过滤器(SiteMesh等)、 FilterDispatcher)。注意这里是有顺序的,先ActionContextCleanUp,再其他过滤器(SiteMesh等)、最后到FilterDispatcher。
|
||||
(3)FilterDispatcher是Struts2控制器的核心,它通常是过滤器链中的最后一个过滤器,FilterDispatcher进行初始化并启用核心doFilter().FilterDispatcher询问ActionMapper是否需要调用某个Action来处理这个(request)请求,如果ActionMapper决定需要调用某个Action,FilterDispatcher把请求的处理交给ActionProxy。
|
||||
(6)ActionProxy通过**ConfigurationManager**(它会访问struts.xml)询问框架的配置文件,找到需要调用的Action类.
|
||||
(7)ActionProxy创建一个ActionInvocation实例,而ActionInvocation通过代理模式调用Action,(在调用之前会根据配置文件加载相关的所有Interceptor拦截器)
|
||||
(8)Action执行完毕后,返回一个result字符串,此时再按相反的顺序通过Interceptor拦截器.
|
||||
(9)最后ActionInvocation负责根据struts.xml中配置的result元素,找到与返回值对应的result,决定进行下一步输出.
|
||||
|
||||
## 为什么要使用 Struts2 & Struts2 的优点:
|
||||
①. 基于 MVC 架构,框架结构清晰。
|
||||
②. 使用 OGNL: OGNL 可以快捷的访问值栈中的数据、调用值栈中对象的方法
|
||||
③. 拦截器: Struts2 的拦截器是一个 Action 级别的 AOP, Struts2 中的许多特性都是通过拦截器来实现的, 例如异常处理,文件上传,验证等。拦截器是可配置与重用的
|
||||
④. 多种表现层技术. 如:JSP、FreeMarker、Velocity 等
|
||||
|
||||
## SpringMVC 与 Struts2区别
|
||||
1.核心控制器(前端控制器、预处理控制器):对于使用过mvc框架的人来说这个词应该不会陌生,核心控制器的主要用途是处理所有的请求,然后对那些特殊的请求 (控制器)统一的进行处理(字符编码、文件上传、参数接受、异常处理等等),spring mvc核心控制器是Servlet,而Struts2是Filter。
|
||||
2.控制器实例:Spring Mvc会比Struts快一些(理论上)。Spring Mvc是基于方法设计,而Sturts是基于对象,每次发一次请求都会实例一个action,每个action都会被注入属性,而Spring更像Servlet一样,只有一个实例,每次请求执行对应的方法即可(注意:由于是单例实例,所以应当避免全局变量的修改,这样会产生线程安全问题)。
|
||||
3. 管理方式:大部分的公司的核心架构中,就会使用到spring,而spring mvc又是spring中的一个模块,所以spring对于spring mvc的控制器管理更加简单方便,而且提供了全 注解方式进行管理,各种功能的注解都比较全面,使用简单,而struts2需要采用XML很多的配置参数来管理(虽然也可以采用注解,但是几乎没有公司那 样使用)。
|
||||
4.参数传递:Struts2中自身提供多种参数接受,其实都是通过(ValueStack)进行传递和赋值,而SpringMvc是通过方法的参数进行接收。
|
||||
5.intercepter 的实现机制:struts有以自己的interceptor机制,spring mvc用的是独立的AOP方式。这样导致struts的配置文件量还是比spring mvc大,虽然struts的配置能继承,所以我觉得论使用上来讲,spring mvc使用更加简洁,开发效率Spring MVC确实比struts2高。spring mvc是方法级别的拦截,一个方法对应一个request上下文,而方法同时又跟一个url对应,所以说从架构本身上spring3 mvc就容易实现restful url。struts2是类级别的拦截,一个类对应一个request上下文;实现restful url要费劲,因为struts2 action的一个方法可以对应一个url;而其类属性却被所有方法共享,这也就无法用注解或其他方式标识其所属方法了。spring3 mvc的方法之间基本上独立的,独享request response数据,请求数据通过参数获取,处理结果通过ModelMap交回给框架方法之间不共享变量,而struts2搞的就比较乱,虽然方法之间 也是独立的,但其所有Action变量是共享的,这不会影响程序运行,却给我们编码,读程序时带来麻烦。
|
||||
7.spring mvc处理ajax请求,直接通过返回数据,方法中使用注解@ResponseBody,spring mvc自动帮我们对象转换为JSON数据。
|
||||
|
||||
|
||||
## Filter,Listener,Servlet区别
|
||||
1) Filter 实现javax.servlet.Filter接口,在web.xml中配置与标签指定使用哪个Filter实现类过滤哪些URL链接。只在web启动时进行初始化操作。filter流程是**线性**的, url传来之后,检查之后,可保持原来的流程继续向下执行,被下一个filter, servlet接收等,而servlet 处理之后,不会继续向下传递。filter功能可用来保持流程继续按照原来的方式进行下去,或者主导流程,而servlet的功能主要用来主导流程。
|
||||
特点:可以在响应之前修改Request和Response的头部,只能转发请求,不能直接发出响应。filter可用来进行字符编码的过滤,检测用户是否登陆的过滤,禁止页面缓存等
|
||||
2) Servlet 流程是短的,url传来之后,就对其进行处理,之后返回或转向到某一自己指定的页面。它主要用来在业务处理之前进行控制。
|
||||
3) Listener
|
||||
servlet,filter都是针对url之类的,而listener是针对**对象操作**的,如session的创建,session.setAttribute的发生,在这样的事件发
|
||||
生时做一些事情。
|
||||
|
||||
## Struts2拦截器和过滤器的区别
|
||||
①、过滤器依赖于Servlet容器,而拦截器不依赖于Servlet容器。
|
||||
②、Struts2 拦截器只能对 Action 请求起作用,而过滤器则可以对几乎所有请求起作用。
|
||||
③、拦截器可以访问 Action 上下文(ActionContext)、值栈里的对象(ValueStack),而过滤器不能.
|
||||
④、在 Action 的生命周期中,拦截器可以多次调用,而过滤器只能在容器初始化时被调用一次。
|
||||
|
||||
## Struts的Action是不是线程安全的
|
||||
struts2的action是线程安全的,struts1的action不是线程安全的 。
|
||||
对于struts1 ,Action是单例模式,一个实例来处理所有的请求。当第一次**.do的请求过来时,在内存中的actionmapping中找到相对应的action,然后new出这个action放在缓存中,当第二次一样的请求过来时,还是找的这个action,所以对于struts1来说,action是单实例的,只有一个,如果在action中定义变量,就要非常小心了,因为并发问题,可能带来灾难性的后果,也不是不可以,我们可以加锁达到同步,只是在性能上就 要折衷了。
|
||||
声明局部变量,或者扩展RequestProcessor,让每次都创建一个Action,或者在spring中用scope=”prototype”来管理,不申明类变量就可以保证线程安全。因为只存在一个Action类实例,所有线程会共享类变量。
|
||||
struts2 在struts1的基础上做了改进 ,对于struts2 ,每次请求过来都会new一个新的action, 所以说struts2的action没有线程安全问题,是线程安全的,但同时也带来一个问题,每次都new一个action ,这样action的实例太多 , 在性能方面还是存在一定的缺陷的。
|
||||
|
||||
## struts2.0的mvc模式与struts1.0的区别?
|
||||
与struts1最大的不同是:struts2的控制器。struts2的控制器不再像struts1的控制器,需要**继承**一个Action父类,甚至可以无需实现任何接口,struts2的Action就是一个普通的POJO。实际上,Struts2 的Action就是一个包含execute方法的普通Java类该类里包含的多个属性用于封装用户的请求参数。
|
||||
|
||||
## 你对MVC的理解,MVC有什么优缺点?结合Struts,说明在一个Web应用如何去使用?
|
||||
MVC设计模式(应用观察者模式的框架模式)
|
||||
M: Model(Business process layer),模型,是应用程序中用于处理应用程序数据逻辑的部分,通常模型对象负责在数据库中存取数据。,并独立于表现层 (Independent of presentation)。
|
||||
V: View(Presentation layer),视图,通过客户端数据类型显示数据,并回显模型层的执行结果。
|
||||
C: Controller(Control layer),控制器,也就是**视图层和模型层桥梁**,控制数据的流向,接受视图层发出的事件,并重绘视图
|
||||
优点:
|
||||
1)视图控制模型分离,提高代码重用性。
|
||||
2)提高开发效率。
|
||||
3)便于后期维护,降低维护成本。
|
||||
4)方便多开发人员间的分工。
|
||||
5)结构清晰
|
||||
缺点:
|
||||
1)清晰的构架以代码的复杂性为代价, 对小项目优可能反而降低开发效率。
|
||||
2)运行效率相对较低
|
||||
|
||||
MVC框架的一种实现模型
|
||||
模型二(Servlet-centric): JSP+Servlet+JavaBean,以控制为核心,JSP只负责显示和收集数据,Sevlet,连接视图和模型,将视图层数据,发送给模型层,JavaBean,分为业务类和数据实体,业务类处理业务数据,数据实体,承载数据,基本上大多数的项目都是使用这种MVC的实现模式。
|
||||
|
||||
Struts MVC框架(Web application frameworks) :Struts是使用MVC的实现模式二来实现的,也就是以控制器为核心。
|
||||
|
||||
Struts提供了一些组件使用MVC开发应用程序:
|
||||
Model:Struts 没有提供model 类。这个商业逻辑必须由Web 应用程序的开发者以JavaBean或EJB的形式提供
|
||||
View:Struts提供了action form创建form bean, 用于在controller和view间传输数据。此外,Struts提供了自定义JSP标签库,辅助开发者用JSP创建交互式的以表单为基础的应用程序,应用程序资源文件保留了一些文本常量和错误消息,可转变为其它语言, 可用于JSP中。
|
||||
Controller:Struts提供了一个核心的控制器FilterDispatcher,通过这个核心的控制器来调用其他用户注册了的自定义的控制器Action,自定义Action需要符合Struts的自定义Action规范,还需要在struts-config.xml的特定配置文件中进行配置,接收JSP输入字段形成Action form,然后调用一个Action控制器。Action控制器中提供了model的逻辑接口。
|
||||
|
||||
## 说出 struts2 中至少 5 个的默认拦截器
|
||||
exception;fileUpload;i18n;modelDriven;params;prepare;token;tokenSession;validation 等
|
||||
拦截器的生命周期与工作过程 ?
|
||||
|
||||
## 每个拦截器都是需要实现 Interceptor 接口
|
||||
init():在拦截器被创建后立即被调用, 它在拦截器的生命周期内只被调用一次. 可以在该方法中对相关资源进行必要的初始化;
|
||||
intercept(ActionInvocation invocation):每拦截一个动作请求,该方法就会被调用一次;
|
||||
destroy:该方法将在拦截器被销毁之前被调用, 它在拦截器的生命周期内也只被调用一次;
|
||||
|
||||
## 创建Action类有几种方法?
|
||||
实现Action 接口
|
||||
使用Struts2 @Action 元注解
|
||||
继承ActionSupport类,必须实现 execute() 方法,返回一个可配置的字符串
|
||||
|
||||
##Struts2的拦截器执行什么模式?
|
||||
**责任链模式**
|
||||
过滤器decorator模式和职责链模式
|
||||
|
||||
|
||||
个人公众号(欢迎关注):
|
||||

|
||||
|
||||
|
||||
Reference in New Issue
Block a user