
32 KiB
MySQL
一、索引
B+ Tree 原理
1. 数据结构
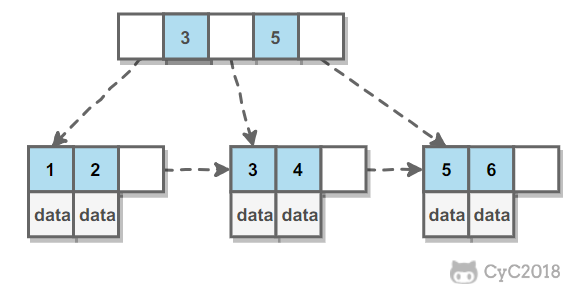
B Tree 指的是 Balance Tree,也就是平衡树。平衡树是一棵查找树,并且所有叶子节点位于同一层。
B+ Tree 是基于 B Tree 和叶子节点顺序访问指针进行实现,它具有 B Tree 的平衡性,并且通过顺序访问指针来提高区间查询的性能。
在 B+ Tree 中,一个节点中的 key 从左到右非递减排列,如果某个指针的左右相邻 key 分别是 keyi 和 keyi+1,且不为 null,则该指针指向节点的所有 key 大于等于 keyi 且小于等于 keyi+1。
2. 操作
进行查找操作时,首先在根节点进行二分查找,找到一个 key 所在的指针,然后递归地在指针所指向的节点进行查找。直到查找到叶子节点,然后在叶子节点上进行二分查找,找出 key 所对应的 data。
插入删除操作会破坏平衡树的平衡性,因此在进行插入删除操作之后,需要对树进行分裂、合并、旋转等操作来维护平衡性。
3. 与红黑树的比较
红黑树等平衡树也可以用来实现索引,但是文件系统及数据库系统普遍采用 B+ Tree 作为索引结构,这是因为使用 B+ 树访问磁盘数据有更高的性能。
(一)B+ 树有更低的树高
平衡树的树高 O(h)=O(logdN),其中 d 为每个节点的出度。红黑树的出度为 2,而 B+ Tree 的出度一般都非常大,所以红黑树的树高 h 很明显比 B+ Tree 大非常多。
(二)磁盘访问原理
操作系统一般将内存和磁盘分割成固定大小的块,每一块称为一页,内存与磁盘以页为单位交换数据。数据库系统将索引的一个节点的大小设置为页的大小,使得一次 I/O 就能完全载入一个节点。
如果数据不在同一个磁盘块上,那么通常需要移动磁臂进行寻道,而磁臂因为其物理结构导致了移动效率低下,从而增加磁盘数据读取时间。B+ 树相对于红黑树有更低的树高,进行寻道的次数与树高成正比,在同一个磁盘块上进行访问只需要很短的磁盘旋转时间,所以 B+ 树更适合磁盘数据的读取。
(三)磁盘预读特性
为了减少磁盘 I/O 操作,磁盘往往不是严格按需读取,而是每次都会预读。预读过程中,磁盘进行顺序读取,顺序读取不需要进行磁盘寻道,并且只需要很短的磁盘旋转时间,速度会非常快。并且可以利用预读特性,相邻的节点也能够被预先载入。
MySQL 索引
索引是在存储引擎层实现的,而不是在服务器层实现的,所以不同存储引擎具有不同的索引类型和实现。
下面按数据结构介绍几种索引。按用途还可以分为主键索引、唯一索引、普通索引、联合索引和前缀索引;按叶子节点中存放的是整行还是主键,分为主索引(聚簇索引)和辅助索引(二级索引),见下文的 B+Tree 索引。
1. B+Tree 索引
是大多数 MySQL 存储引擎的默认索引类型。
因为不再需要进行全表扫描,只需要对树进行搜索即可,所以查找速度快很多。
因为 B+ Tree 的有序性,所以除了用于查找,还可以用于排序和分组。
可以指定多个列作为索引列,多个索引列共同组成键。
适用于全键值、键值范围和键前缀查找,其中键前缀查找只适用于最左前缀查找。如果不是按照索引列的顺序进行查找,则无法使用索引。
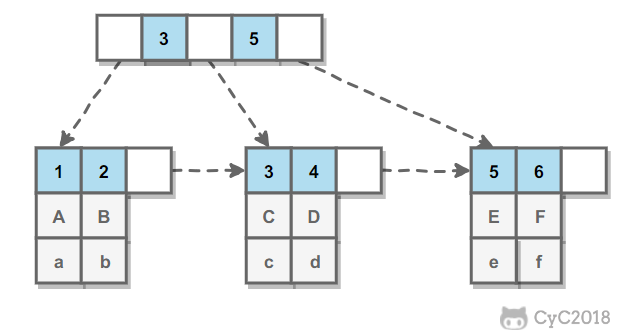
InnoDB 的 B+Tree 索引分为主索引和辅助索引。主索引的叶子节点 data 域记录着完整的数据记录,这种索引方式被称为聚簇索引。因为无法把数据行存放在两个不同的地方,所以一个表只能有一个聚簇索引。
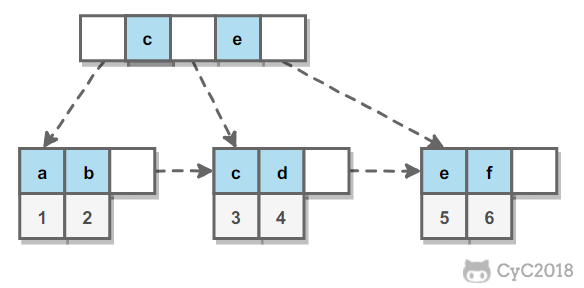
辅助索引的叶子节点的 data 域记录着主键的值,因此在使用辅助索引进行查找时,需要先查找到主键值,然后再到主索引中进行查找。
2. 哈希索引
哈希索引能以 O(1) 时间进行查找,但是失去了有序性:
- 无法用于排序与分组;
- 只支持精确查找,无法用于部分查找和范围查找。
InnoDB 存储引擎有一个特殊的功能叫“自适应哈希索引”,当某个索引值被使用的非常频繁时,会在 B+Tree 索引之上再创建一个哈希索引,这样就让 B+Tree 索引具有哈希索引的一些优点,比如快速的哈希查找。
3. 全文索引
MyISAM 存储引擎支持全文索引,用于查找文本中的关键词,而不是直接比较是否相等。
查找条件使用 MATCH AGAINST,而不是普通的 WHERE。
全文索引使用倒排索引实现,它记录着关键词到其所在文档的映射。
InnoDB 存储引擎在 MySQL 5.6.4 版本中也开始支持全文索引。
4. 空间数据索引
MyISAM 存储引擎支持空间数据索引(R-Tree),可以用于地理数据存储。空间数据索引会从所有维度来索引数据,可以有效地使用任意维度来进行组合查询。目前 InnoDB 存储引擎也支持空间数据索引。
必须使用 GIS 相关的函数来维护数据。
索引优化
1. 独立的列
在进行查询时,索引列不能是表达式的一部分,也不能是函数的参数,否则无法使用索引。
例如下面的查询不能使用 actor_id 列的索引:
SELECT actor_id FROM sakila.actor WHERE actor_id + 1 = 5;
2. 多列索引
在需要使用多个列作为条件进行查询时,使用多列索引比使用多个单列索引性能更好。例如下面的语句中,最好把 actor_id 和 film_id 设置为多列索引。
SELECT film_id, actor_ id FROM sakila.film_actor
WHERE actor_id = 1 AND film_id = 1;
3. 索引列的顺序
让选择性最强的索引列放在前面。
索引的选择性是指:不重复的索引值和记录总数的比值。最大值为 1,此时每个记录都有唯一的索引与其对应。选择性越高,每个记录的区分度越高,查询效率也越高。
例如下面显示的结果中 customer_id 的选择性比 staff_id 更高,因此最好把 customer_id 列放在多列索引的前面。
SELECT COUNT(DISTINCT staff_id)/COUNT(*) AS staff_id_selectivity,
COUNT(DISTINCT customer_id)/COUNT(*) AS customer_id_selectivity,
COUNT(*)
FROM payment;
   staff_id_selectivity: 0.0001
customer_id_selectivity: 0.0373
               COUNT(*): 16049
4. 前缀索引
对于 BLOB 和 TEXT 类型的列,必须使用前缀索引,只索引开始的部分字符;对于 VARCHAR 和 CHAR 类型的列,可以选择使用前缀索引来减小索引的大小。
前缀长度的选取需要根据索引选择性来确定。
5. 覆盖索引
索引包含所有需要查询的字段的值。
具有以下优点:
- 索引通常远小于数据行的大小,只读取索引能大大减少数据访问量。
- 一些存储引擎(例如 MyISAM)在内存中只缓存索引,而数据依赖于操作系统来缓存。因此,只访问索引可以不使用系统调用(通常比较费时)。
- 对于 InnoDB 引擎,若辅助索引能够覆盖查询,则无需访问主索引。
索引失效
索引失效指的是查询条件中有索引列,执行计划却没有使用这个索引,或者只用到了联合索引的一部分。下面在一张 200 万行的订单表 orders 上用 Explain 验证,表上有联合索引 idx_user_status_time(user_id, status, create_time)、单列索引 idx_create_time(create_time) 和 idx_order_no(order_no),其中 order_no 是 VARCHAR 类型:
| 查询条件 | type | 原因 |
|---|---|---|
status = 1 AND create_time > '2025-01-20' |
ALL | 没有从联合索引最左边的 user_id 开始 |
DATE(create_time) = '2025-01-12' |
ALL | 对索引列使用了函数 |
order_no = 7007 |
ALL | 字符串列与数字比较,发生了隐式类型转换 |
order_no LIKE '%7007' |
ALL | 以 % 开头,无法利用索引的顺序 |
user_id = 5 OR amount = 10.99 |
ALL | OR 的一侧没有索引,仍然要扫描全表 |
user_id != 5 |
ALL | 几乎匹配所有行 |
对应的写法:
- 把函数改写为范围:
create_time >= '2025-01-12' AND create_time < '2025-01-13',type 变为 range; - 字符串列用字符串比较:
order_no = '7007',type 变为 ref。这是因为 '7007'、' 7007'、'7007a' 转换成数字后都等于 7007,没法按索引的顺序查找;反过来,整数列与字符串比较(id = '1001')仍然走主键,因为被转换的是常量而不是列; - 只在右边模糊匹配:
LIKE '7007%',type 为 range; - OR 两侧的列都有索引时,可以分别扫描两个索引再合并结果,type 为 index_merge。
联合索引中出现范围条件时,范围条件之后的列不能再用来缩小扫描的范围。Explain 的 key_len 表示用到了索引的前几列,user_id 为 INT,占 4 字节,status 为 TINYINT,占 1 字节,create_time 为 DATETIME,占 5 字节:
WHERE user_id = 5 AND status = 1 AND create_time > '2025-01-05'   -- key_len = 10,三列都用上了
WHERE user_id = 5 AND status > 0 AND create_time > '2025-01-05'   -- key_len = 5,只用到前两列
不过第二条语句的 Extra 为 Using index condition,也就是索引下推:create_time 虽然不能缩小扫描范围,但仍然在索引上过滤,不满足条件的行不需要回表,所以范围条件之后的列并不是完全没有作用。
需要注意的是,是否使用索引是优化器按成本估算决定的。走二级索引的每一行都要回表,匹配的行越多回表越多,超过一定比例后全表扫描反而更快:create_time > '2025-01-23' 匹配 9.9 万行,走 idx_create_time;create_time > '2025-01-02' 匹配 191 万行,就选择了全表扫描。IN 也一样,user_id IN 5 个值时走索引,3 万多个值时全表扫描。因此同一种写法有时走索引有时不走,可能是因为匹配的数据量不同。
索引的优点
-
大大减少了服务器需要扫描的数据行数。
-
帮助服务器避免进行排序和分组,以及避免创建临时表(B+Tree 索引是有序的,可以用于 ORDER BY 和 GROUP BY 操作。临时表主要是在排序和分组过程中创建,不需要排序和分组,也就不需要创建临时表)。
-
将随机 I/O 变为顺序 I/O(B+Tree 索引是有序的,会将相邻的数据都存储在一起)。
索引的使用条件
-
对于非常小的表、大部分情况下简单的全表扫描比建立索引更高效;
-
对于中到大型的表,索引就非常有效;
-
但是对于特大型的表,建立和维护索引的代价将会随之增长。这种情况下,需要用到一种技术可以直接区分出需要查询的一组数据,而不是一条记录一条记录地匹配,例如可以使用分区技术;
-
索引并不是越多越好:插入、删除数据和修改索引列时,要同时维护每个相关的索引,索引也要占用存储空间。在上面的 orders 表上插入 50 万行,没有二级索引时耗时 2.0 s,有 4 个二级索引时耗时 5.5 s,这 4 个索引占用 73 MB,而数据本身是 89 MB;
-
适合建索引的是经常出现在 WHERE、JOIN、ORDER BY、GROUP BY 中,并且区分度高的列,区分度很低的列(例如只有几种取值的状态)单独建索引的作用不大。
二、查询性能优化
使用 Explain 进行分析
Explain 用来分析 SELECT 查询语句,开发人员可以通过分析 Explain 结果来优化查询语句。
比较重要的字段有:
- select_type : 查询类型,有简单查询、联合查询、子查询等
- type : 访问类型,从好到差常见的有 const、eq_ref、ref、range、index、ALL。const 表示通过主键或唯一索引最多匹配一行,ref 表示通过普通索引等值匹配,range 表示索引范围扫描,index 表示扫描整个索引树,ALL 表示全表扫描
- key : 使用的索引
- rows : 扫描的行数
- Extra : 额外信息,Using index 表示使用了覆盖索引,不需要回表;Using index condition 表示使用了索引下推;Using filesort 表示无法利用索引的顺序,需要额外排序;Using temporary 表示使用了临时表,常见于 GROUP BY 和 ORDER BY 的列不一致
出现 ALL、Using filesort 或 Using temporary,并且 rows 很大时,通常需要调整索引或者改写查询。
找出慢查询可以使用慢查询日志:开启 slow_query_log 后,执行时间超过 long_query_time(默认 10 秒)的语句会被记录下来,再用 mysqldumpslow 按执行时间、次数汇总分析。
优化数据访问
1. 减少请求的数据量
- 只返回必要的列:最好不要使用 SELECT * 语句。
- 只返回必要的行:使用 LIMIT 语句来限制返回的数据。
- 缓存重复查询的数据:使用缓存可以避免在数据库中进行查询,特别在要查询的数据经常被重复查询时,缓存带来的查询性能提升将会是非常明显的。
2. 减少服务器端扫描的行数
最有效的方式是使用索引来覆盖查询。
重构查询方式
1. 切分大查询
一个大查询如果一次性执行的话,可能一次锁住很多数据、占满整个事务日志、耗尽系统资源、阻塞很多小的但重要的查询。
DELETE FROM messages WHERE create < DATE_SUB(NOW(), INTERVAL 3 MONTH);
rows_affected = 0
do {
    rows_affected = do_query(
    "DELETE FROM messages WHERE create  < DATE_SUB(NOW(), INTERVAL 3 MONTH) LIMIT 10000")
} while rows_affected > 0
2. 分解大连接查询
将一个大连接查询分解成对每一个表进行一次单表查询,然后在应用程序中进行关联,这样做的好处有:
- 让缓存更高效。对于连接查询,如果其中一个表发生变化,那么整个查询缓存就无法使用。而分解后的多个查询,即使其中一个表发生变化,对其它表的查询缓存依然可以使用。
- 分解成多个单表查询,这些单表查询的缓存结果更可能被其它查询使用到,从而减少冗余记录的查询。
- 减少锁竞争;
- 在应用层进行连接,可以更容易对数据库进行拆分,从而更容易做到高性能和可伸缩。
- 查询本身效率也可能会有所提升。例如下面的例子中,使用 IN() 代替连接查询,可以让 MySQL 按照 ID 顺序进行查询,这可能比随机的连接要更高效。
SELECT * FROM tag
JOIN tag_post ON tag_post.tag_id=tag.id
JOIN post ON tag_post.post_id=post.id
WHERE tag.tag='mysql';
SELECT * FROM tag WHERE tag='mysql';
SELECT * FROM tag_post WHERE tag_id=1234;
SELECT * FROM post WHERE post.id IN (123,456,567,9098,8904);
深分页
深分页指的是偏移量很大的分页查询。例如 200 万行的订单表 orders,create_time 上有普通索引 idx_create_time,按创建时间翻到第 100001 页:
SELECT * FROM orders ORDER BY create_time LIMIT 1000000, 10;
MySQL 没办法直接跳到第 1000001 行,只能先找出排在前面的 1000010 行,丢弃前 1000000 行,再返回最后 10 行,偏移量越大越慢。

这条查询的执行计划中 type 为 ALL、Extra 为 Using filesort,也就是全表扫描后排序。这是因为如果走 idx_create_time,读出的 1000010 条索引项都要回表取整行,产生上百万次随机读,优化器判断这样还不如全表扫描。
延迟关联指的是先在索引上查出这一页的主键,再根据主键回表。子查询只用到 create_time 和 id,idx_create_time 就是覆盖索引(Extra 为 Using index),虽然仍要扫描 1000010 条索引项,但不需要回表,只有最后 10 行需要回表:
SELECT o.* FROM orders o
JOIN (SELECT id FROM orders ORDER BY create_time LIMIT 1000000, 10) t ON o.id = t.id
ORDER BY o.create_time;
游标分页(也叫书签分页)指的是记住上一页最后一行的排序值,下一页从它之后开始查。这样可以直接在索引上定位到上一页结束的位置,只读 10 行:
-- 上一页最后一行:create_time = '2025-01-12 13:46:39',id = 982321
SELECT * FROM orders
WHERE create_time > '2025-01-12 13:46:39'
   OR (create_time = '2025-01-12 13:46:39' AND id > 982321)
ORDER BY create_time, id
LIMIT 10;
排序列的值可能重复,所以要再按主键排序,并把主键也作为游标的一部分,否则时间相同的行会被跳过或者重复返回。游标分页的代价是不能直接跳到任意一页,只能逐页翻,适合 App 下拉加载、按时间浏览记录这类场景。
在 MySQL 8.0 上实测的结果如下(数据全部在内存中,取 5 次中最快的一次),三种写法返回的 10 行相同:
| 写法 | 耗时 | 读取的数据 |
|---|---|---|
| LIMIT 0, 10 | 0.05 ms | 10 行 |
| LIMIT 1000000, 10 | 1321 ms | 全表 200 万行,再排序 |
| 延迟关联 | 88 ms | 1000010 条索引项,回表 10 次 |
| 游标分页 | 0.13 ms | 10 行 |
还可以从需求上限制翻页的深度,例如只允许翻到前 100 页。Elasticsearch 默认也不允许 from + size 超过 10000,更深的翻页要用 search_after,原理与游标分页相同。
需要注意的是,分页时常常还要显示总记录数。InnoDB 没有保存表的行数,因为并发的事务看到的行数可能不同,COUNT(*) 需要扫描整个索引,上面的表执行一次需要 136 ms。数据量大时可以缓存总数、显示估算值,或者只提供“下一页”。
三、存储引擎
InnoDB
是 MySQL 默认的事务型存储引擎,只有在需要它不支持的特性时,才考虑使用其它存储引擎。
实现了四个标准的隔离级别,默认级别是可重复读(REPEATABLE READ)。在可重复读隔离级别下,通过多版本并发控制(MVCC)+ Next-Key Locking 防止幻影读。
主索引是聚簇索引,在索引中保存了数据,从而避免直接读取磁盘,因此对查询性能有很大的提升。
内部做了很多优化,包括从磁盘读取数据时采用的可预测性读、能够加快读操作并且自动创建的自适应哈希索引、能够加速插入操作的插入缓冲区等。
支持真正的在线热备份。其它存储引擎不支持在线热备份,要获取一致性视图需要停止对所有表的写入,而在读写混合场景中,停止写入可能也意味着停止读取。
MyISAM
设计简单,数据以紧密格式存储。对于只读数据,或者表比较小、可以容忍修复操作,则依然可以使用它。
提供了大量的特性,包括压缩表、空间数据索引等。
不支持事务。
不支持行级锁,只能对整张表加锁,读取时会对需要读到的所有表加共享锁,写入时则对表加排它锁。但在表有读取操作的同时,也可以往表中插入新的记录,这被称为并发插入(CONCURRENT INSERT)。
可以手工或者自动执行检查和修复操作,但是和事务恢复以及崩溃恢复不同,可能导致一些数据丢失,而且修复操作是非常慢的。
如果指定了 DELAY_KEY_WRITE 选项,在每次修改执行完成时,不会立即将修改的索引数据写入磁盘,而是会写到内存中的键缓冲区,只有在清理键缓冲区或者关闭表的时候才会将对应的索引块写入磁盘。这种方式可以极大的提升写入性能,但是在数据库或者主机崩溃时会造成索引损坏,需要执行修复操作。
比较
-
事务:InnoDB 是事务型的,可以使用 Commit 和 Rollback 语句。
-
并发:MyISAM 只支持表级锁,而 InnoDB 还支持行级锁。
-
外键:InnoDB 支持外键。
-
备份:InnoDB 支持在线热备份。
-
崩溃恢复:MyISAM 崩溃后发生损坏的概率比 InnoDB 高很多,而且恢复的速度也更慢。
-
其它特性:MyISAM 支持压缩表和空间数据索引。
四、数据类型
整型
TINYINT, SMALLINT, MEDIUMINT, INT, BIGINT 分别使用 8, 16, 24, 32, 64 位存储空间,一般情况下越小的列越好。
INT(11) 中的数字只是规定了交互工具显示字符的个数,对于存储和计算来说是没有意义的。
浮点数
FLOAT 和 DOUBLE 为浮点类型,DECIMAL 为高精度小数类型。CPU 原生支持浮点运算,但是不支持 DECIMAL 类型的计算,因此 DECIMAL 的计算比浮点类型需要更高的代价。
FLOAT、DOUBLE 和 DECIMAL 都可以指定列宽,例如 DECIMAL(18, 9) 表示总共 18 位,取 9 位存储小数部分,剩下 9 位存储整数部分。
字符串
主要有 CHAR 和 VARCHAR 两种类型,一种是定长的,一种是变长的。
VARCHAR 这种变长类型能够节省空间,因为只需要存储必要的内容。但是在执行 UPDATE 时可能会使行变得比原来长,当超出一个页所能容纳的大小时,就要执行额外的操作。MyISAM 会将行拆成不同的片段存储,而 InnoDB 则需要分裂页来使行放进页内。
在进行存储和检索时,会保留 VARCHAR 末尾的空格,而会删除 CHAR 末尾的空格。
时间和日期
MySQL 提供了两种相似的日期时间类型:DATETIME 和 TIMESTAMP。
1. DATETIME
能够保存从 1000 年到 9999 年的日期和时间,精度为秒,使用 5 字节的存储空间(MySQL 5.6.4 之前为 8 字节)。
它与时区无关。
默认情况下,MySQL 以一种可排序的、无歧义的格式显示 DATETIME 值,例如“2008-01-16 22:37:08”,这是 ANSI 标准定义的日期和时间表示方法。
2. TIMESTAMP
和 UNIX 时间戳相同,保存从 1970 年 1 月 1 日午夜(格林威治时间)以来的秒数,使用 4 个字节,只能表示从 1970 年到 2038 年。
它和时区有关,也就是说一个时间戳在不同的时区所代表的具体时间是不同的。
MySQL 提供了 FROM_UNIXTIME() 函数把 UNIX 时间戳转换为日期,并提供了 UNIX_TIMESTAMP() 函数把日期转换为 UNIX 时间戳。
如果希望插入时没有指定 TIMESTAMP 列的值就设置为当前时间,需要显式声明 DEFAULT CURRENT_TIMESTAMP。MySQL 8.0 默认开启了 explicit_defaults_for_timestamp,不再自动为表中第一个 TIMESTAMP 列添加这个默认值。
TIMESTAMP 比 DATETIME 少占用 1 字节,但是只能表示到 2038 年,需要表示更大的时间范围时应当使用 DATETIME。
五、切分
水平切分
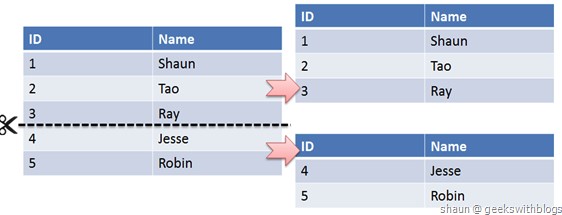
水平切分又称为 Sharding,它是将同一个表中的记录拆分到多个结构相同的表中。
当一个表的数据不断增多时,Sharding 是必然的选择,它可以将数据分布到集群的不同节点上,从而缓解单个数据库的压力。
垂直切分
垂直切分是将一张表按列切分成多个表,通常是按照列的关系密集程度进行切分,也可以利用垂直切分将经常被使用的列和不经常被使用的列切分到不同的表中。
在数据库的层面使用垂直切分将按数据库中表的密集程度部署到不同的库中,例如将原来的电商数据库垂直切分成商品数据库、用户数据库等。
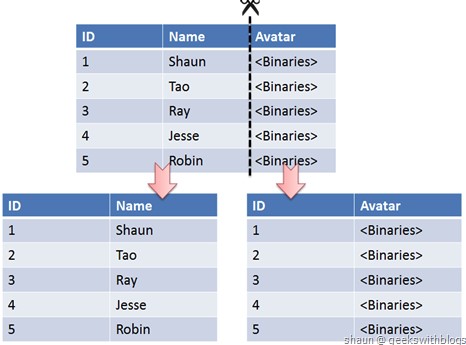
Sharding 策略
- 哈希取模:hash(key) % N;
- 范围:可以是 ID 范围也可以是时间范围;
- 映射表:使用单独的一个数据库来存储映射关系。
Sharding 存在的问题
1. 事务问题
使用分布式事务来解决,比如 XA 接口。
2. 连接
可以将原来的连接分解成多个单表查询,然后在用户程序中进行连接。
3. ID 唯一性
- 使用全局唯一 ID(GUID)
- 为每个分片指定一个 ID 范围
- 分布式 ID 生成器 (如 Twitter 的 Snowflake 算法)
六、复制
主从复制
主要涉及三个线程:binlog dump 线程、I/O 线程和 SQL 线程。
- binlog dump 线程 :主服务器上的数据更改会写入二进制日志(Binary log),该线程负责把二进制日志的内容发送给从服务器。
- I/O 线程 :负责从主服务器上读取二进制日志,并写入从服务器的中继日志(Relay log)。
- SQL 线程 :负责读取中继日志,解析出主服务器已经执行的数据更改并在从服务器中重放(Replay)。

读写分离
主服务器处理写操作以及实时性要求比较高的读操作,而从服务器处理读操作。
读写分离能提高性能的原因在于:
- 主从服务器负责各自的读和写,极大程度缓解了锁的争用;
- 从服务器可以使用 MyISAM,提升查询性能以及节约系统开销;
- 增加冗余,提高可用性。
读写分离常用代理方式来实现,代理服务器接收应用层传来的读写请求,然后决定转发到哪个服务器。

七、日志
InnoDB 执行一次修改时,会写下面三种日志:
| 日志 | 由谁写 | 记录的内容 | 作用 |
|---|---|---|---|
| undo log | InnoDB | 修改前的旧版本 | 回滚事务,MVCC 读取旧版本 |
| redo log | InnoDB | 对数据页的修改 | 崩溃恢复 |
| binlog | Server 层 | 修改前后的整行(ROW 格式) | 主从复制,恢复到指定时间点 |
undo log 的作用见 多版本并发控制。
redo log
InnoDB 以 16 KB 的页为单位存储数据,修改数据时先修改内存中缓存的页。如果每次提交都把修改过的页写回磁盘,修改几行数据就要随机写好几个 16 KB 的页。redo log 的做法是:提交时只把对数据页的修改顺序追加到 redo log 并刷盘,数据页之后再由后台线程批量写回。崩溃重启时重放 redo log 中还没有写回数据页的修改,已提交的事务就不会丢失。这种先写日志、后写数据的方式称为预写日志(Write-Ahead Logging, WAL)。
innodb_flush_log_at_trx_commit 控制提交时 redo log 的刷盘方式:
- 1(默认):每次提交都写入并刷盘,已提交的事务不会丢失;
- 2:每次提交都写入操作系统的缓存,每秒刷盘一次,MySQL 进程崩溃不会丢失数据,操作系统崩溃或者断电可能丢失最近 1 秒的事务;
- 0:每秒写入并刷盘一次,MySQL 进程崩溃也可能丢失最近 1 秒的事务。
redo log 的空间是固定的,循环写入:数据页写回磁盘之后,对应的 redo log 就可以被覆盖。MySQL 8.0.30 起由 innodb_redo_log_capacity 控制大小,默认为 100 MB。
binlog
binlog 由 Server 层记录,与存储引擎无关,用于 主从复制 和把数据恢复到指定的时间点。MySQL 8.0 默认使用 ROW 格式,记录每一行修改前后的值。例如执行 UPDATE orders SET status = 3 WHERE id = 1024 后,用 mysqlbinlog 解析 binlog(省略了其它列):
### UPDATE `demo`.`orders`
### WHERE
###   @1=1024
###   @4=0
### SET
###   @1=1024
###   @4=3
... Xid = 341
COMMIT
redo log 与 binlog 的区别:
- redo log 是 InnoDB 的日志,记录对数据页的修改,空间固定、循环写,用于崩溃恢复;
- binlog 是 Server 层的日志,记录行的修改或者 SQL 语句,追加写、不会覆盖,可以发送给从库,也可以用来把数据恢复到任意时间点。
两阶段提交
一个事务既要写 redo log 又要写 binlog,如果只写成功了一个就崩溃,主库和从库的数据就会不一致。例如 redo log 写了而 binlog 没写,主库重启后保留了这次修改,从库却收不到。因此 MySQL 把提交分为两个阶段:

- prepare:写入 redo log 并刷盘,事务处于 prepare 状态;
- 写入 binlog 并刷盘,binlog 中记录了事务的 ID(Xid);
- commit:在 redo log 中把事务标记为提交。
崩溃重启时,对于处于 prepare 状态的事务,到 binlog 中查找它的 Xid:找到了说明 binlog 已经写完,就提交这个事务;找不到就回滚。这样主库的数据与 binlog 总是一致的,从库按照 binlog 复制,也就与主库一致。
innodb_flush_log_at_trx_commit 和 sync_binlog 的默认值都是 1,也就是每次提交时两种日志都会刷盘,常被称为“双 1”配置。
参考资料
- MySQL 8.0: InnoDB Restrictions and Limitations
- Elasticsearch: Paginate search results
- MySQL 8.0: EXPLAIN Output Format
- MySQL 8.0: The Slow Query Log
- Baron Schwartz, Peter Zaitsev, Vadim Tkachenko, 等. 高性能 MySQL[M]. 电子工业出版社, 2013.
- 姜承尧. MySQL 技术内幕: InnoDB 存储引擎 [M]. 机械工业出版社, 2011.
- 20+ 条 MySQL 性能优化的最佳经验
- 服务端指南 数据存储篇 | MySQL(09) 分库与分表带来的分布式困境与应对之策
- How to create unique row ID in sharded databases?
- SQL Azure Federation – Introduction
- MySQL 索引背后的数据结构及算法原理
- MySQL 性能优化神器 Explain 使用分析
- How Sharding Works
- 大众点评订单系统分库分表实践
- B + 树
- MySQL 8.0: Type Conversion in Expression Evaluation
- MySQL 8.0: Redo Log
- MySQL 8.0: The Binary Log