mirror of
https://gitee.com/wangkang/udf.git
synced 2026-10-21 00:43:42 +00:00

201 lines
8.3 KiB
Markdown
201 lines
8.3 KiB
Markdown
# spring boot / cloud (十六) 分布式ID生成服务
|
|
|
|
在几乎所有的**分布式系统**或者采用了**分库/分表设计的系统**中,几乎都会需要**生成数据的唯一标识ID**的需求,
|
|
|
|
常规做法,是使用数据库中的自动增长列来做系统主键,但是这样的做法无法保证ID全局唯一.
|
|
|
|
那么一个分布式ID生成器应该满足那些需求呢 :
|
|
|
|
- **全局唯一性**
|
|
|
|
- **趋势递增**
|
|
|
|
- **能够融入分库基因**
|
|
|
|
本文将基于snowflake的算法来进行以下的讨论,当然,分布式ID的生成方案有很多,
|
|
|
|
不过在本文并不会分散开来讨论/比对,因为网上相关的文章实在太多,如果有需要了解的同学,请自行百度.
|
|
|
|
同时,也不会讨论snowflake算法,同样也是因为网上相关的文章实在太多,如果有需要了解的同学,请自行百度.
|
|
|
|
## **本文期望解决什么问题?**
|
|
|
|
先看两段代码:
|
|
|
|
``` java
|
|
public void id() {
|
|
Map<Long, Long> map = new HashMap<>();
|
|
int maxCount = 100;
|
|
IdWorker idWorker = new IdWorker(1, 1);
|
|
for (int i = 0; i < maxCount; i++) {
|
|
long id = idWorker.nextId();
|
|
map.put(id, id);
|
|
}
|
|
log.info("{} , {}", maxCount, map.size());
|
|
}
|
|
```
|
|
|
|
输出为 : 100 , 100
|
|
|
|
``` java
|
|
public void id() {
|
|
Map<Long, Long> map = new HashMap<>();
|
|
int maxCount = 100;
|
|
for (int i = 0; i < maxCount; i++) {
|
|
IdWorker idWorker = new IdWorker(1, 1);
|
|
long id = idWorker.nextId();
|
|
map.put(id, id);
|
|
}
|
|
log.info("{} , {}", maxCount, map.size());
|
|
}
|
|
```
|
|
|
|
输出为 : 100 , 10
|
|
|
|
### 这两段代码的区别,相信大家一眼就能看出,但是那为什么会出现这样的情况呢?
|
|
|
|
了解snowflake的同学也都知道,这个算法是基于时间的,如下组成 :
|
|
|
|
**0 | 时间(41位) | 数据中心ID(5位) | 机器ID(5位) | 序号(12位)**
|
|
|
|
而生成ID的算法逻辑,简单点说,在相同**数据中心ID**和**机器ID**的情况下,如果时间的毫秒数是一致的,那么就通过递增序列号来保证ID不重复.
|
|
|
|
也就是说在**1毫秒**内最大生成的ID个数是**二进制12bit的最大值**,也就是**4096**(**0-4095**)个
|
|
|
|
那么如果序列号超过了这个最大值,则会将程序阻塞到下一毫秒,然后序列号归零,继续生成ID.
|
|
|
|
好知道了生成ID的逻辑后,上面两个程序判断的现象也就不难解释了.
|
|
|
|
**程序一** : 没有重复,是因为在整个循环中,ID生成器只实例化过一次,在循环的过程中,能正常的递增序列号,所以不会有重复的ID出现
|
|
|
|
**程序二** : 有重复,是因为ID生成器是在循环中循环实例化的,每次生成ID的时候序列号都是0,但是程序执行很快,得到的时间毫秒数又是一样的,那么,就必然会有重复值了.
|
|
|
|
**所以从以上的程序片段和分析中可以得出一个结论 : 要想snowflake生成全局唯一的ID,那么ID生成器必须也是全局单例的**
|
|
|
|
### 那申明一个全局静态的ID生成器不就行了?
|
|
|
|
两个点要主注意一下 :
|
|
|
|
- **分布式系统下全局静态变量也是多份的,因为系统可能运行在不同的JVM下,并不能保证变量的全局单例**
|
|
|
|
- **前面提到了在同一毫秒下,最多只能生成4096个ID,对于那些并发量很大是系统来说,显然是不够的,
|
|
那么这个时候就是通过datacenterId和workerId来做区分,这两个ID,分别是5bit,共10bit,最大值是1024(0-1023)个,
|
|
在这种情况下,snowflake一毫秒理论上最大能够生成的ID数量是约42W个,这是一个非常大的基数了,理论上能够满足绝大多数系统的并发量**
|
|
|
|
**所以得出一个结论 : snowflake可以通过datacenterId和workerId来区分ID的归属(可以是业务线,可以是机房,等等,按需定义)来达到更大的ID生成数量**
|
|
|
|
### 那么有那些方法来分配atacenterId和workerId呢?
|
|
|
|
- **写死 : 正如上面说的一样,单机部署,然后写死两个值**
|
|
|
|
- **读配置文件 : 将值放在配置中心,应用启动的时候读取,然后初始化**
|
|
|
|
- **动态分配 : 本文主旨**
|
|
|
|
## **所以本文主要讨论的是如何动态分配snowflake的datacenterId和workerId,以及如何做到高可用**
|
|
|
|
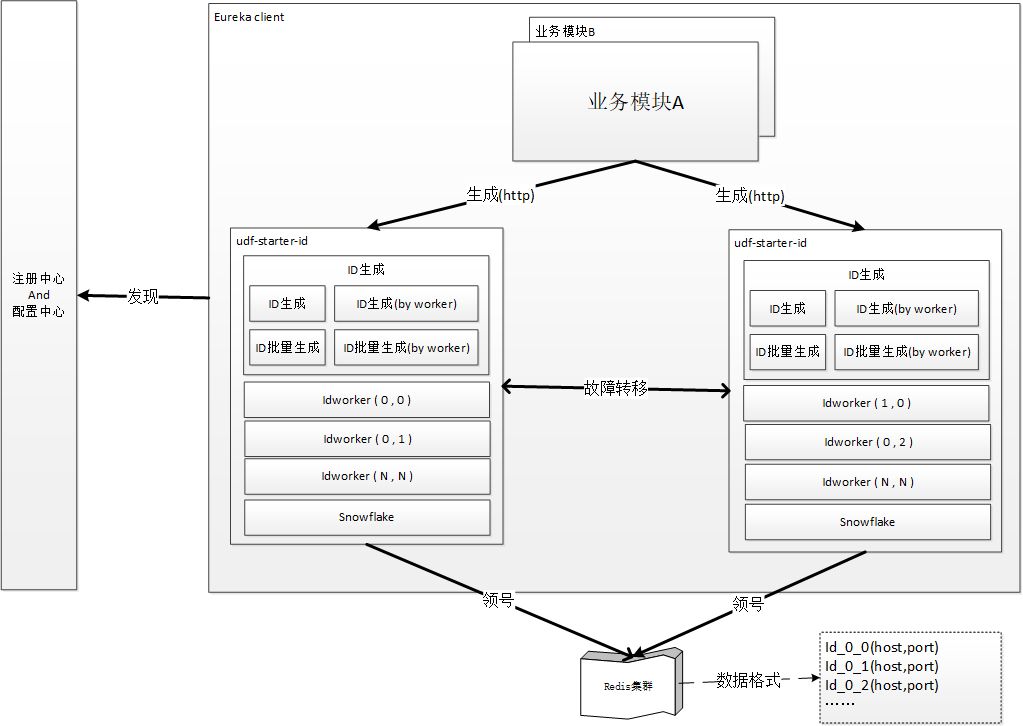
所以大家先看一下架构图 :
|
|
|
|
## 分布式ID-逻辑架构示意
|
|
|
|
|
|
|
|
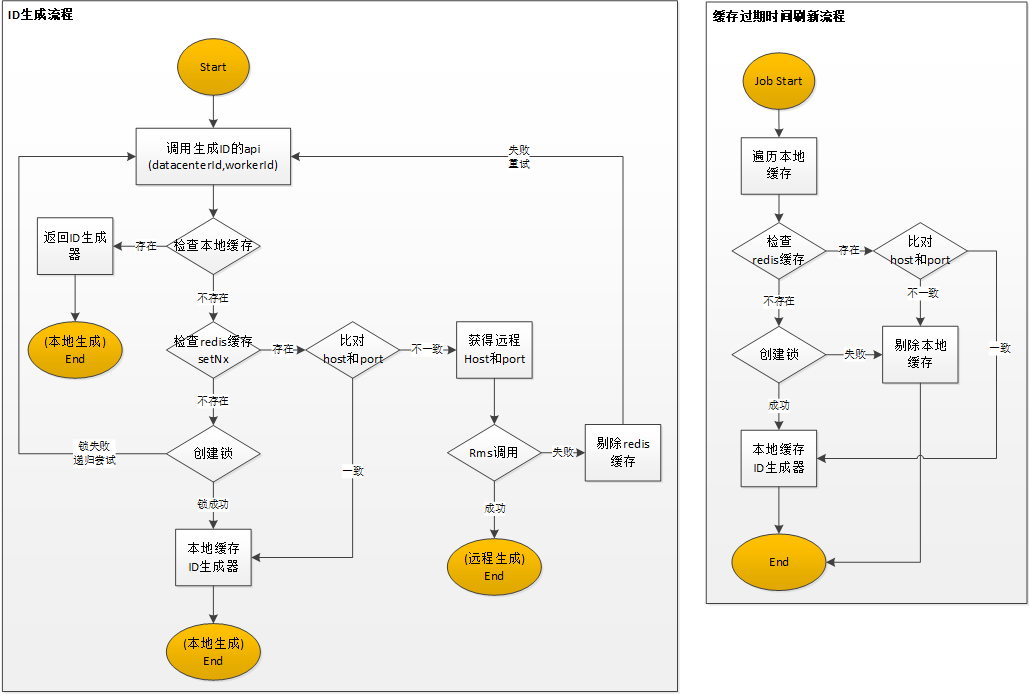
## 分布式ID-发号流程示意
|
|
|
|
|
|
|
|
## 相关源码可在本文末尾的配套代码仓库中获得,工程是 : udf-starter-id
|
|
|
|
## 架构设计
|
|
|
|
### 构建独立的ID生成服务,提供如下服务:
|
|
|
|
``` java
|
|
#生成分布式ID(按时间戳区分datacenterId和workerId)
|
|
/service/id
|
|
|
|
#生成分布式ID(按dwId[0-1023])
|
|
/service/id/{dwId}
|
|
|
|
#生成分布式ID(按datacenterId[0-31]和workerId[0-31])
|
|
/service/id/{datacenterId}/{workerId}
|
|
|
|
#批量生成分布式ID(按时间戳区分datacenterId和workerId)
|
|
/service/id/batch/{count}
|
|
|
|
#批量生成分布式ID(按dwId[0-1023])
|
|
/service/id/batch/{dwId}/{count}
|
|
|
|
#批量生成分布式ID(按datacenterId[0-31]和workerId[0-31])
|
|
/service/id/batch/{datacenterId}/{workerId}/{count}
|
|
```
|
|
|
|
### 融入分库基因
|
|
|
|
在提供出来的rest服务中,提供了datacenterId和workerId的参数(dwId就是两者的融合,10bit),
|
|
|
|
总共预留了10个bit的空余来支持分库分表,最大支持1024个节点.
|
|
|
|
#### 反解析分布式ID
|
|
|
|
snowflake生成的ID是可以被反解析的,这样更进一步的支持了分库的相关炒作,相关实现如下 :
|
|
|
|
``` java
|
|
Id reverseId = new Id();
|
|
reverseId.setSequence((id) & ~(-1L << 12)); // sequence
|
|
reverseId.setDwId((id >> (12)) & ~(-1L << (10))); // dwId
|
|
reverseId.setWorkerId((id >> 12) & ~(-1L << 5)); // workerId
|
|
reverseId.setDatacenterId((id >> 17) & ~(-1L << 5)); // datacenterId
|
|
reverseId.setTimestamp((id >> 22) + TWEPOCH); // timestamp
|
|
return reverseId;
|
|
```
|
|
|
|
### 集群部署 和 懒实例化ID生成器
|
|
|
|
本方案是可以支持ID生成服务有多个实例,最多1024个,能并且能保证每个实例内,相同datacenterId和workerId的ID生成器只有一个,做到全局单例.
|
|
|
|
主要是通过redis原子锁的来实现的.详情可看上面的流程图,主要分为**本地ID生成**和**跨实例ID生成**两种模式 :
|
|
|
|
#### **本地生成**
|
|
|
|
这种情况比较简单,就是生成ID的请求刚刚落到ID生成器所在的实例上,然后就可以直接拿到ID生成器,然后生成ID.
|
|
|
|
#### **跨实例ID生成**
|
|
|
|
这种情况简单点说就是,比如你要生成**3-3**的ID,这个ID生成器在**实例A**上,但是负载均衡器将请求发到**实例B**上去了,
|
|
|
|
这个时候**实例B**上并没有对应的ID生成器,这个时候,就会从缓存中拿到对应的缓存值,拿到用用这个ID生成器的HOST和PORT,
|
|
|
|
然后在做一个RMS请求,调用远程的rest服务,生成ID,然后返回
|
|
|
|
### 高可用 和 故障转移
|
|
|
|
**上面提到了,ID生成器现在是全网单例的了,那么其中一个节点有故障,挂掉了怎么办呢?**
|
|
|
|
在**跨实例ID生成**的场景下,会有RMS请求失败的情况,远程节点有可能会故障,这个时候,一旦RMS请求失败,则会触发**故障转移**,
|
|
|
|
具体操作就是将redis中的对应缓存删除掉,然后走一个实例化ID生成器的流程,这个时候,**当前处理请求的节点**就会将**故障节点**拥有的ID生成器转移过来,转为**本地生成**模式,从而做到的**故障转移**
|
|
|
|
### 性能
|
|
|
|
如果是**本地ID生成**的话,那基本没有性能损耗,直接操作本地变量.
|
|
|
|
**跨实例ID生成**的情况会多出来一个RMS请求的耗时,但是一次ID生成的请求最多触发一次RMS请求,消耗是可控的
|
|
|
|
在有**节点故障**的时候,**触发故障转移**会额外的产生一次**ID实例化的流程**,会造成**轻微波动**,但紧当前的这一次请求,下次的请求就会转为**本地ID生成的模式**
|
|
|
|
## **结束**
|
|
|
|
今天跟大家分享了如何动态分配snowflake的datacenterId和workerId,以及如何做到高可用的设计和思路,环境大家提出意见和建议
|
|
|
|
## **代码仓库** (博客配套代码)
|
|
|
|
- [udf-starter : 基础项目,脚手架,框架](https://gitee.com/wangkang/udf)
|
|
|
|
- [udf-sample : 集成样例](https://gitee.com/wangkang/udf-sample)
|
|
|
|
---------
|
|
|
|
想获得最快更新,请关注公众号
|
|
|
|
 |